Alibaba dévoile Qwen3.8-Flash-Next : des poids ouverts qui surpassent Claude Opus 4.6 Max
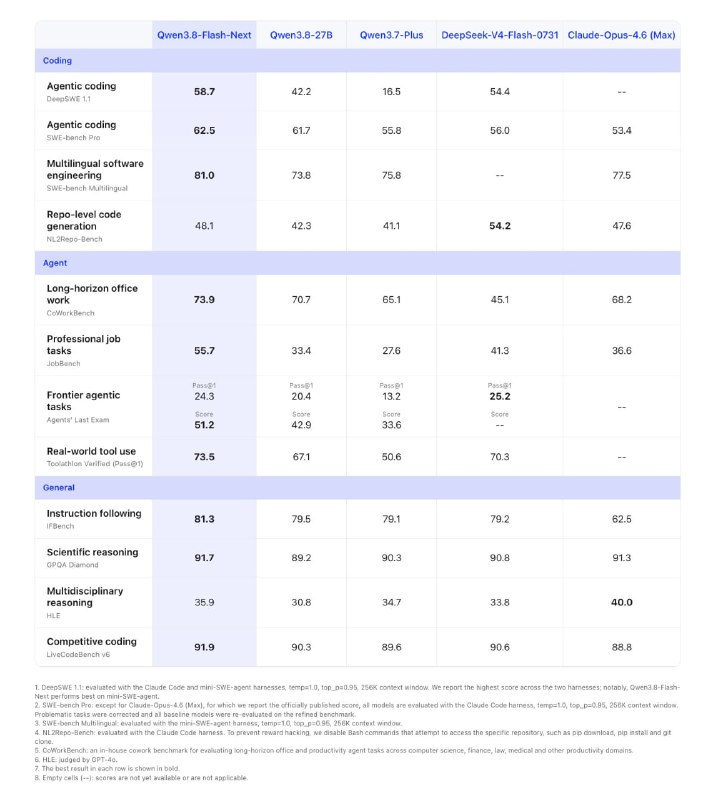
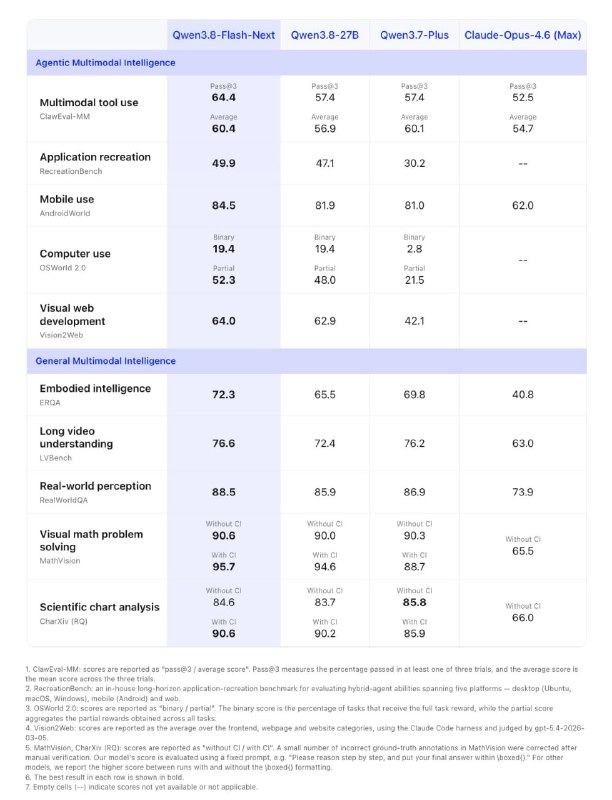
Alibaba lance le modèle Qwen3.8-Flash-Next, une architecture préliminaire à poids ouverts qui surpasse déjà Claude Opus 4.6 Max dans plusieurs benchmarks clés.
Alibaba a officiellement présenté Qwen3.8-Flash-Next, un nouveau modèle d'intelligence artificielle distribué avec des poids ouverts. Dès sa sortie, il démontre des performances supérieures à celles de Claude Opus 4.6 Max dans divers tests techniques.
Il ne s'agit pas encore de la version complète Qwen4, mais plutôt d'une avant-première prometteuse de l'architecture future.
Architecture et Efficacité
Le modèle se distingue par une conception hybride :
- 125 milliards de paramètres pour le modèle principal.
- 51 milliards de paramètres dédiés aux représentations n-gram.
- Seuls 6 milliards de paramètres sont activés par token, optimisant ainsi les ressources.
Les coûts d'entraînement ont été réduits d'environ 9 fois par rapport au Qwen3.7-Plus, tout en offrant une robustesse accrue pour les tâches de programmation et de bureau.
Résultats Clés (Benchmarks)
Voici les scores obtenus par Qwen3.8-Flash-Next comparés à ceux de Claude Opus 4.6 Max :
| Benchmark | Score Qwen3.8-Flash-Next | Référence (Claude Opus 4.6 Max) |
|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 |
| SWE-bench Multilingual | 81.0 | - |
| CoWorkBench | 73.9 | - |
| JobBench | 55.7 | - |
| Toolathlon | 73.5 | - |
| LiveCodeBench | 91.9 | - |
| GPQA Diamond | 91.7 | - |
| IFBench | 81.3 | - |
Contexte et Performance Technique
- Contexte natif : 256K tokens, extensible jusqu'à 1 million de tokens via la technologie YaRN.
- Vitesse : Avec un contexte d'un million de tokens, la prétraitement est accéléré de 7,6x et la génération de 4,9x.
- Efficacité : Malgré seulement 6 milliards de paramètres actifs par token, les performances rivalisent avec celles d'Opus dans les tâches agentiques et le codage.
Disponibilité et Tarification
Le modèle sera prochainement accessible via API avec une tarification compétitive :
- $0.16 par million de tokens en entrée.
- $0.47 par million de tokens en sortie.
Pourquoi c'est important
AnalyseCette avancée marque un tournant majeur en rendant des modèles à haute performance accessibles avec des coûts d'infrastructure réduits, défiant directement la domination actuelle des modèles propriétaires comme Claude.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs