Architecture Qwen-4 : de nouvelles percées dans l'IA
Le modèle Qwen-4 promet des améliorations significatives grâce à une nouvelle architecture offrant haute performance et économie de ressources. Les recherches confirment que ces innovations réduisent considérablement les coûts d'entraînement tout en augmentant la capacité du modèle.
Architecture Qwen-4 : de nouvelles percées dans l'IA
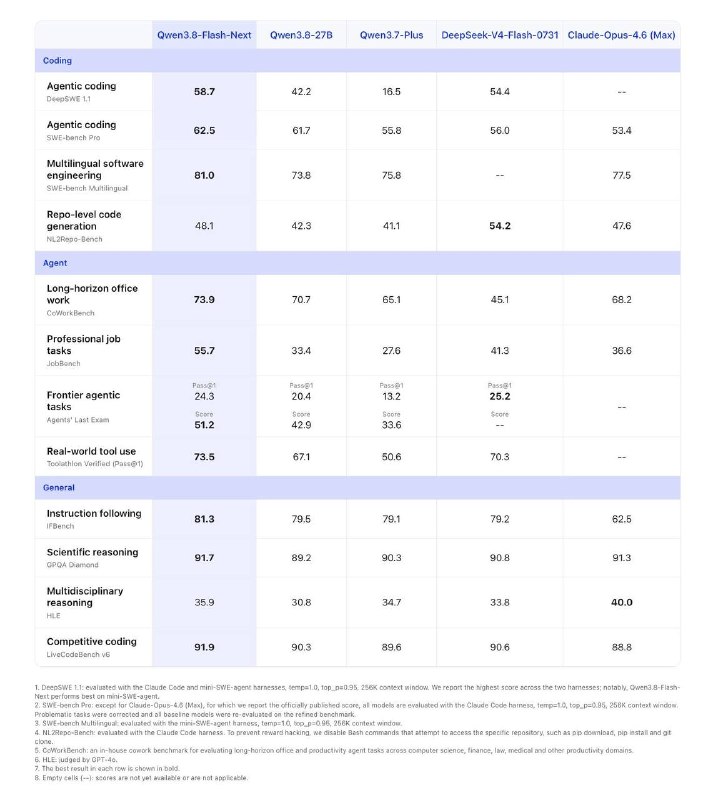
Model Scope a lancé le compte à rebours pour la sortie de Qwen3.8-Flash-Next. Sa publication est prévue sous un jour, marquant ainsi le premier modèle construit sur l'architecture de prochaine génération, qui servira également de base au futur Qwen-4.
Caractéristiques clés de Qwen-3.8 Flash-Next
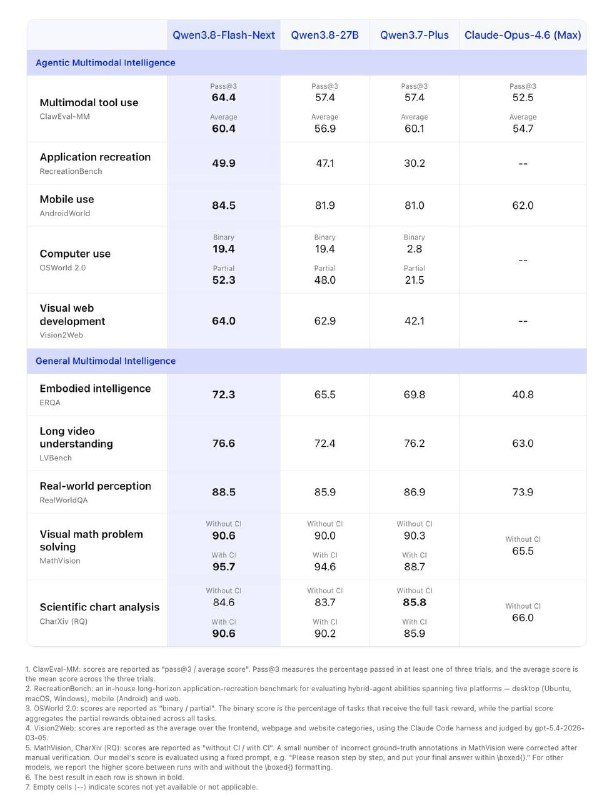
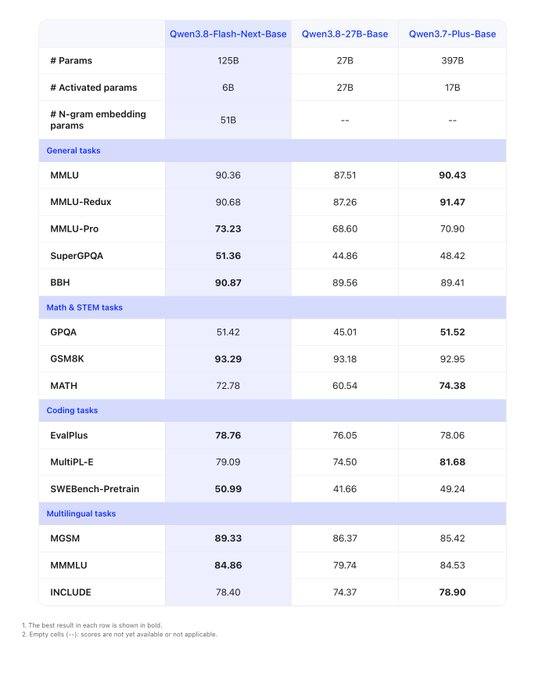
Ce modèle intègre une architecture MoE (Mixture of Experts) de 125B paramètres avec une table N-gram de 51B (dont seulement 6B sont actifs), surpassant Opus 4.6 Max sur 8 des 9 benchmarks testés ! Il dépasse également Qwen3.8-27B et DeepSeek-V4-Flash, tandis que les coûts d'entraînement ont été divisés par neuf par rapport à Qwen3.7-Plus.
Innovations majeures de l'architecture
Embeddings N-gram : Il s'agit d'une table indexée non pas par un token unique, mais par de courtes séquences. Le modèle mémorise directement sous forme de vecteurs les combinaisons locales typiques de tokens, ce qui réduit les calculs par token et augmente la capacité globale du modèle.
Gated DeltaNet + Attention Sparse Qwen : Le modèle sélectionne les blocs de contexte pertinents et ne traite que ceux-ci. Gated DeltaNet est un mécanisme d'attention linéaire doté de portes qui contrôlent ce que le modèle retient ou oublie. Résultat : sur un contexte de 1 million de tokens, la phase de préfilling est devenue 7,6 fois plus rapide et le décodage 4,9 fois plus rapide.
Connexions résiduelles à portes (Gated Residual connections) : Des portes intégrées aux connexions résiduelles déterminent la quantité d'information à transmettre.
Optimiseur Muon : Ce nouvel optimiseur permet une réduction des coûts d'entraînement par un facteur de neuf.
Conclusion
En somme, l'entraînement devient moins coûteux, le nombre de paramètres augmente, tandis que les calculs par token diminuent. Cela représente une nouvelle réussite majeure pour l'écosystème open source chinois.
Pourquoi c'est important
AnalyseCette avancée est cruciale car la nouvelle architecture Qwen-4 pourrait transformer fondamentalement les approches de développement des modèles d'IA, en réduisant drastiquement les coûts d'entraînement tout en boostant les performances.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs