Архітектура Qwen-4: нові досягнення в AI
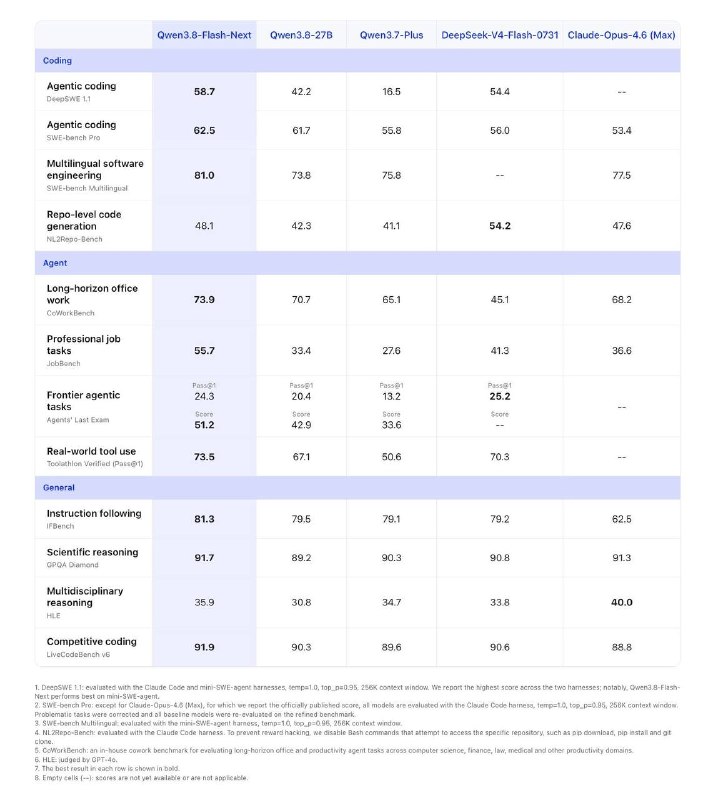
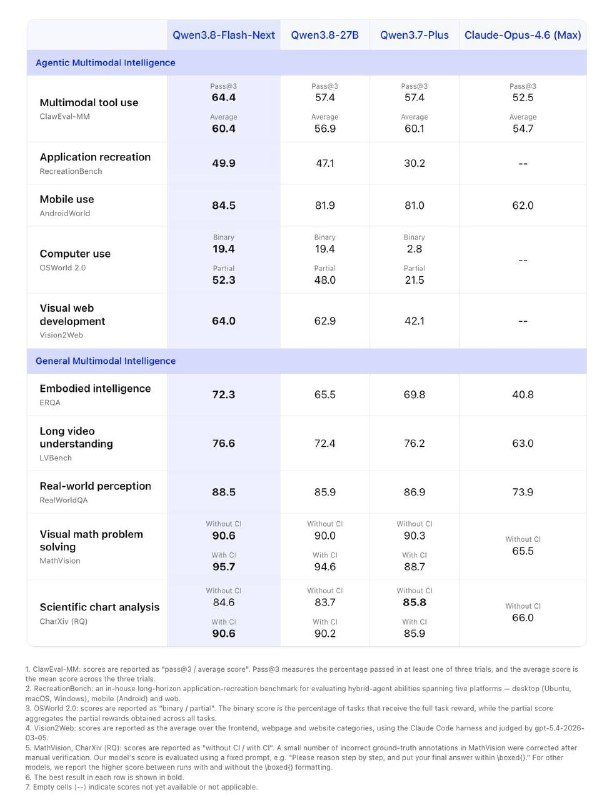
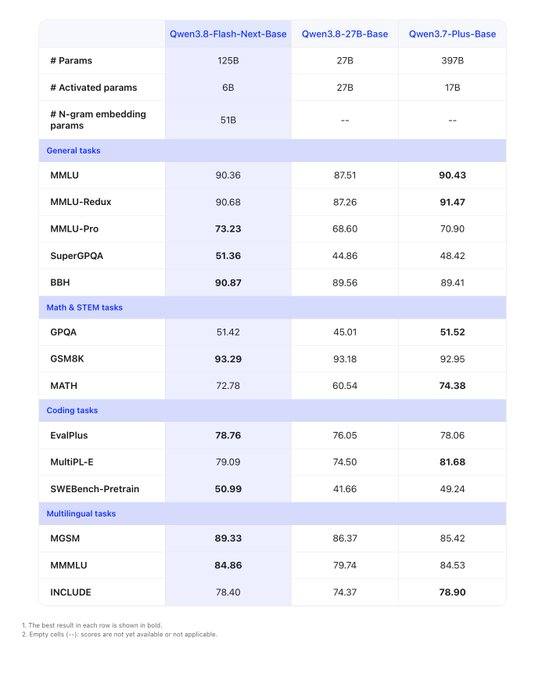
Модель Qwen-4 обіцяє значні покращення в порівнянні з попередніми версіями завдяки новим технологіям. Дослідження показують, що нова архітектура забезпечує високу продуктивність і економію ресурсів.
Архітектура Qwen-4: нові досягнення в AI
Модель Scope запустила відлік до виходу Qwen3.8-Flash-Next. Її реліз відбудеться через добу, і це буде перша модель, побудована на архітектурі наступного покоління, на якій також буде засновано Qwen-4.
Основні характеристики Qwen-3.8 Flash-Next
Ця модель має MoE 125B + 51B N-gram таблицю (активних всього 6B), яка перевершує Opus 4.6 Max на 8 з 9 бенчмарків! Вона також перевершує Qwen3.8-27B і DeepSeek-V4-Flash, при цьому навчання коштувало в 9 разів дешевше, ніж Qwen3.7-Plus.
Ключові новшества архітектури
N-gram ембеддинги: Це таблиця, яка індексується не по одному токену, а по коротким послідовностям. Модель запам'ятовує типові локальні комбінації токенів у вигляді векторів, що дозволяє зменшити обчислення на токен і збільшити загальну ємність моделі.
Gated DeltaNet + Qwen Sparse Attention: Модель вибирає релевантні блоки контексту і працює тільки з ними. Gated DeltaNet – це лінійний механізм уваги з гейтами, які контролюють, що модель запам'ятовує, а що забуває. Результат: на 1М контексту prefill став в 7.6 разів швидшим, а decode – в 4.9 разів.
Gated Residual connections: Гейти в residual-зв'язках визначають, скільки інформації пропустити далі.
Оптимізатор Muon: Цей новий оптимізатор забезпечує 9-кратну економію на навчанні.
Висновок
В результаті навчання стало дешевшим, параметрів більше, а обчислень на токен менше. Це чергове досягнення китайського опенсорсу.
Чому це важливо
АналітикаЦя новина важлива, оскільки нова архітектура Qwen-4 може суттєво змінити підходи до розробки AI-моделей, знижуючи витрати на навчання та підвищуючи продуктивність.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
GPT-6 Astra змінила ваги іншої ШІ-моделі без донавчання
За заявою, GPT-6 Astra змінила лише 0,016% ваг Qwen3.5-0.8B без обчислення градієнтів і донавчання, нібито усунувши зациклення міркувань і покращивши математичні результати та дотримання інструкцій.
Дослідники MIT CSAIL показали Weight-Space Programming: ШІ без навчання редагує ваги Qwen3.5-0.8B
Розробники з MIT CSAIL описали Weight-Space Programming: модель Astra без градієнтного спуску читала ваги Qwen3.5-0.8B і покращила її результати на математичних бенчмарках.
Промпт-гайд по генеративним моделям GPT Image
Моделі генерації зображень gpt-image від OpenAI створені для отримання візуалів виробничої якості та повністю керованих творчих процесів. Вони підходять як для професійних дизайн-з...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?