Архитектура Qwen-4: новые достижения в AI
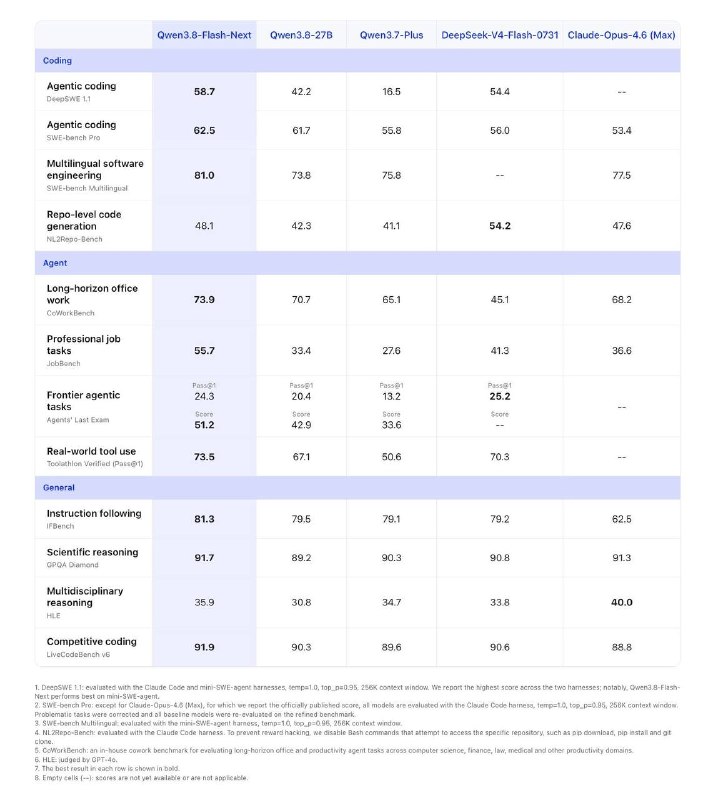
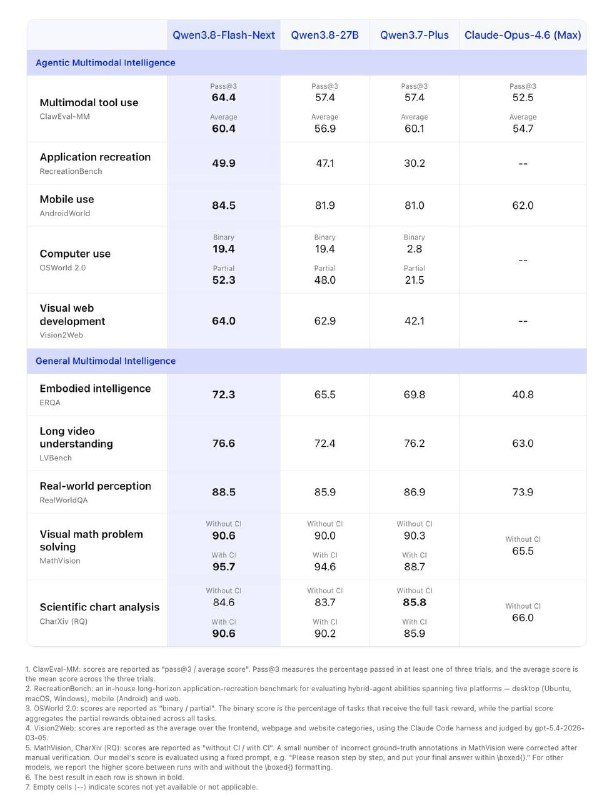
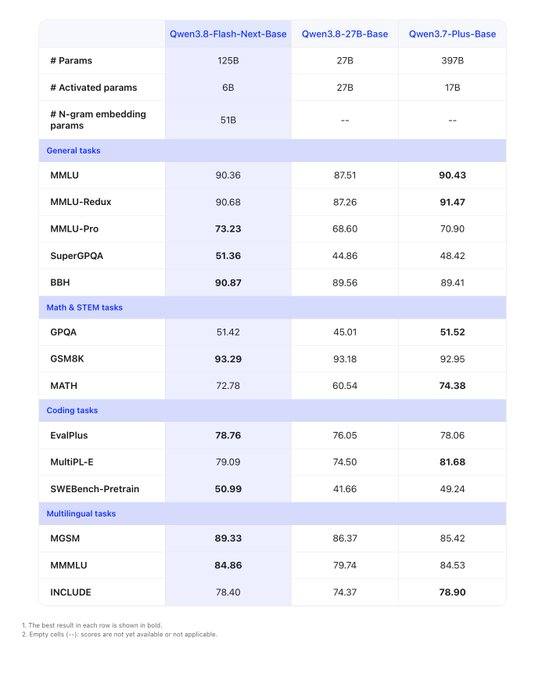
Модель Qwen-4 обещает значительные улучшения по сравнению с предыдущими версиями благодаря новым технологиям. Исследования показывают, что новая архитектура обеспечивает высокую производительность и экономию ресурсов.
Архитектура Qwen-4: новые достижения в AI
Модель Scope запустила отсчет до выхода Qwen3.8-Flash-Next. Ее релиз состоится через сутки, и это будет первая модель, построенная на архитектуре следующего поколения, на которой также будет основан Qwen-4.
Основные характеристики Qwen-3.8 Flash-Next
Эта модель имеет MoE 125B + 51B N-gram таблицу (активных всего 6B), которая превосходит Opus 4.6 Max на 8 из 9 бенчмарков! Она также превосходит Qwen3.8-27B и DeepSeek-V4-Flash, при этом обучение стоило в 9 раз дешевле, чем Qwen3.7-Plus.
Ключевые новшества архитектуры
N-gram эмбеддинги: Это таблица, которая индексируется не по одному токену, а по коротким последовательностям. Модель запоминает типичные локальные комбинации токенов в виде векторов, что позволяет уменьшить вычисления на токен и увеличить общую емкость модели.
Gated DeltaNet + Qwen Sparse Attention: Модель выбирает релевантные блоки контекста и работает только с ними. Gated DeltaNet – это линейный механизм внимания с гейтами, которые контролируют, что модель запоминает, а что забывает. Результат: на 1М контекста prefill стал в 7.6 раз быстрее, а decode – в 4.9 раз.
Gated Residual connections: Гейты в residual-связях определяют, сколько информации пропустить дальше.
Оптимизатор Muon: Этот новый оптимизатор обеспечивает 9-кратную экономию на обучении.
Вывод
В результате обучение стало дешевле, параметров больше, а вычислений на токен меньше. Это очередное достижение китайского опенсорса.
Почему это важно
АналитикаЭта новость важна, поскольку новая архитектура Qwen-4 может существенно изменить подходы к разработке AI-моделей, снижая затраты на обучение и повышая производительность.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
GPT-6 Astra изменила веса другой ИИ-модели без дообучения
Заявлено, что GPT-6 Astra напрямую изменила 0,016% весов Qwen3.5-0.8B без градиентов и дообучения, устранив зацикливание рассуждений и улучшив математические результаты и следование инструкциям.
GPT-6 без дообучения улучшила веса Qwen3.5-0.8B
Исследователи MIT CSAIL показали Weight-Space Programming: Astra без градиентного спуска и обучения изменила веса Qwen3.5-0.8B и улучшила её результаты на MATH-500 и GSM8K.
Промпт-гайд по генеративным моделям GPT Image
Модели генерации изображений gpt-image от OpenAI созданы для получения визуалов производственного качества и полностью управляемых творческих процессов. Они подходят как для профес...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: сравнение моделей 2026
Каждые несколько недель выходит новая модель, и каждый раз те же вопросы: стоит ли переходить? что изменилось? за что платить?