Qwen-4-Architektur: Neue Meilensteine in der KI
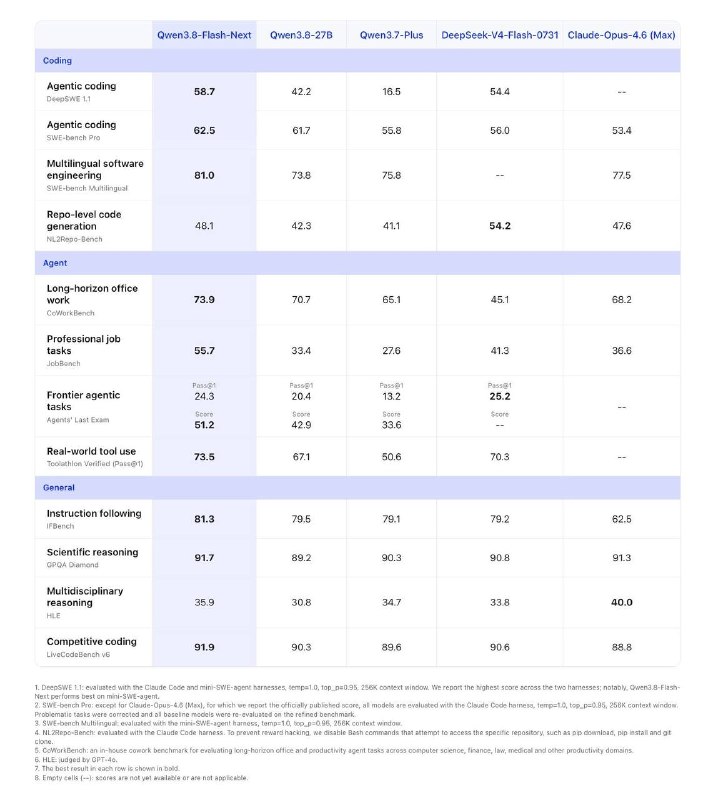
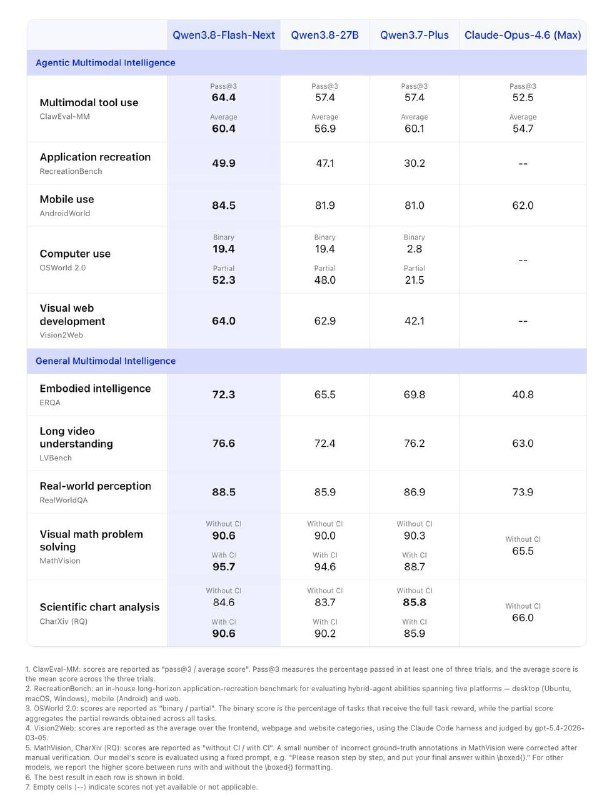
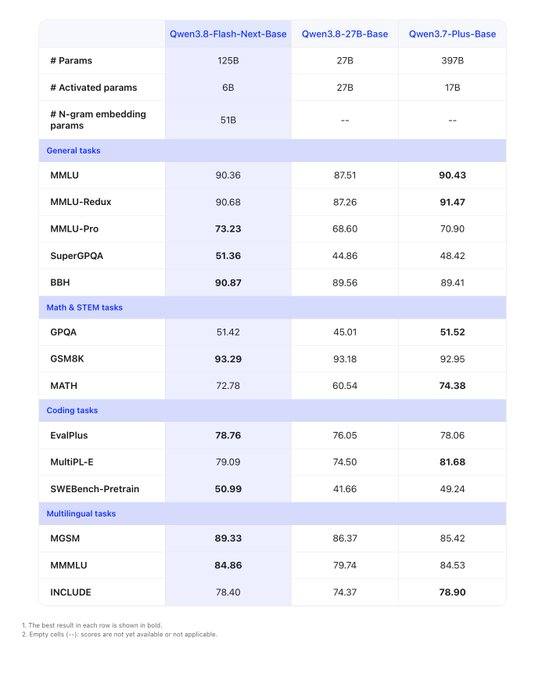
Das Qwen-4-Modell verspricht dank innovativer Technologien erhebliche Verbesserungen gegenüber früheren Versionen. Forschungsergebnisse belegen, dass die neue Architektur hohe Leistungsfähigkeit mit signifikanten Ressourceneinsparungen kombiniert.
Qwen-4-Architektur: Neue Meilensteine in der KI
Model Scope hat den Countdown für die Veröffentlichung von Qwen3.8-Flash-Next gestartet. Die Freigabe erfolgt innerhalb eines Tages und markiert das erste Modell, das auf der Architektur der nächsten Generation basiert – welche zugleich die Grundlage für Qwen-4 bilden wird.
Hauptmerkmale von Qwen-3.8 Flash-Next
Dieses Modell nutzt eine MoE-Struktur (Mixture of Experts) mit 125B Parametern plus einer 51B N-Gramm-Tabelle (wobei nur 6B Parameter aktiv sind). Es übertrifft Opus 4.6 Max bei 8 von 9 Benchmarks! Zudem schlägt es Qwen3.8-27B und DeepSeek-V4-Flash, während die Trainingskosten um den Faktor 9 niedriger ausfielen als bei Qwen3.7-Plus.
Zentrale Innovationen in der Architektur
N-Gramm-Einbettungen: Dies ist eine Tabelle, die nicht nach einzelnen Tokens, sondern nach kurzen Sequenzen indiziert ist. Das Modell speichert typische lokale Token-Kombinationen direkt als Vektoren, was die Berechnungen pro Token reduziert und die Gesamtkapazität des Modells erhöht.
Gated DeltaNet + Qwen Sparse Attention: Das Modell wählt relevante Kontextblöcke aus und verarbeitet ausschließlich diese. Gated DeltaNet ist ein linearer Aufmerksamkeitsmechanismus mit Gates, die steuern, was sich das Modell merkt und was es vergisst. Ergebnis: Bei einem 1-Million-Token-Kontext wurde das Prefilling 7,6-mal schneller und das Decoding 4,9-mal schneller.
Gated Residual Connections: Gates in den residuellen Verbindungen bestimmen, wie viel Information weitergegeben wird.
Muon-Optimizer: Dieser neue Optimierer sorgt für eine neunkfache Einsparung der Trainingskosten.
Fazit
Insgesamt führt dies zu günstigerem Training, mehr Parametern und weniger Berechnungen pro Token. Dies stellt einen weiteren Erfolg im chinesischen Open-Source-Bereich dar.
Warum das wichtig ist
AnalyseDiese Entwicklung ist bedeutsam, da die neue Qwen-4-Architektur Ansätze zur KI-Modellentwicklung grundlegend verändern könnte, indem sie Trainingskosten senkt und gleichzeitig die Leistungsfähigkeit steigert.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
GPT-6 Astra soll Gewichte eines anderen KI-Modells ohne Nachtraining geändert haben
GPT-6 Astra soll nur 0,016 % der Gewichte von Qwen3.5-0.8B ohne Gradienten oder Nachtraining verändert haben, um Reasoning-Schleifen, Mathematikergebnisse und Instruction Following zu verbessern.
Prompt-Leitfaden für GPT-Bildgenerierungsmodelle
Die Bildgenerierungsmodelle gpt-image von OpenAI sind darauf ausgelegt, Visuals in Produktionsqualität und vollständig steuerbare kreative Prozesse zu erzeugen. Sie eignen sich sowohl für professionelle Design-...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Modellvergleich 2026
Alle paar Wochen erscheint ein neues Modell, und jedes Mal stellen sich dieselben Fragen: Lohnt sich der Wechsel? Was hat sich geändert? Wofür lohnt sich die Investition?
Binance veröffentlicht Untersuchung zum Diebstahl von 6,3 Mrd. US-Dollar
Die Untersuchung verbindet den Diebstahl mit einem manipulierten Homebrew, einem gefälschten Interview und dem Missbrauch eines internen KI-Tools von Binance.