Arquitectura Qwen-4: Nuevos Logros en IA
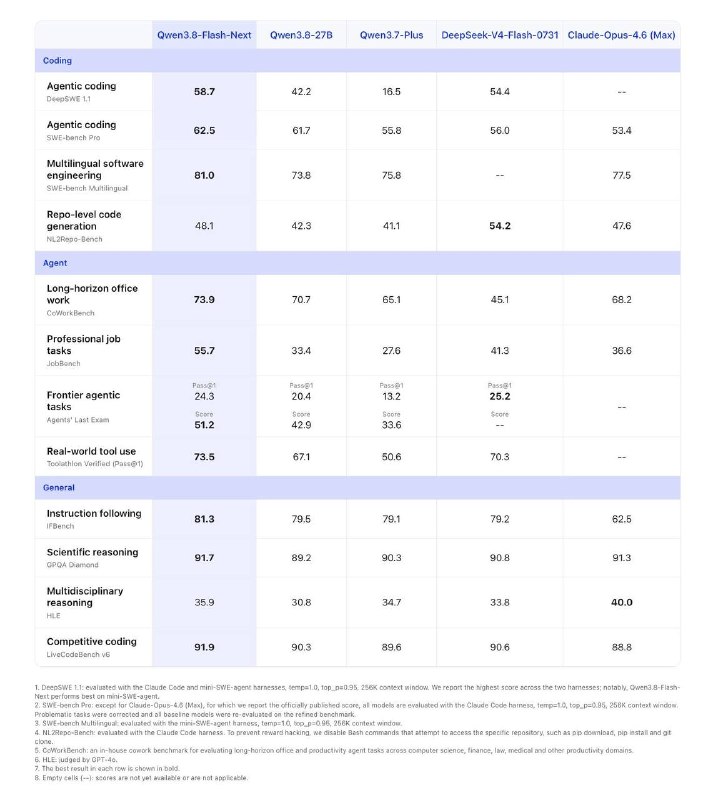
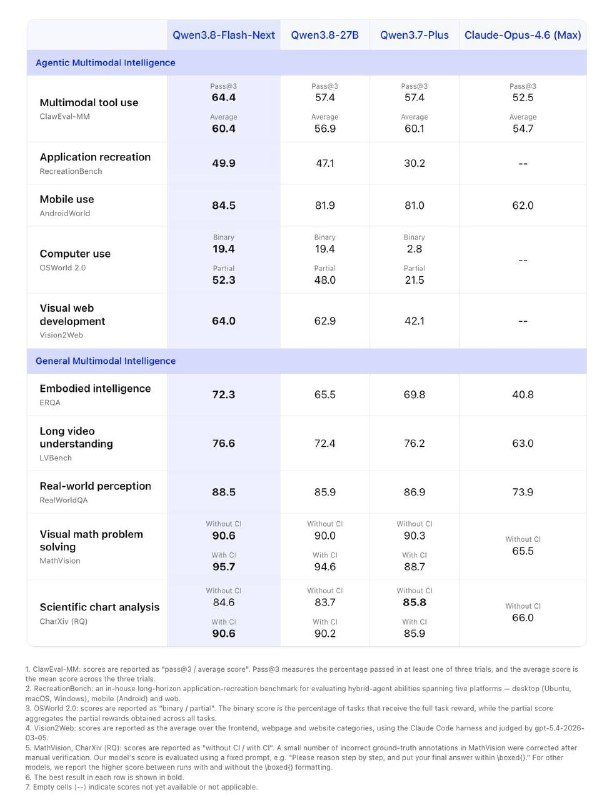
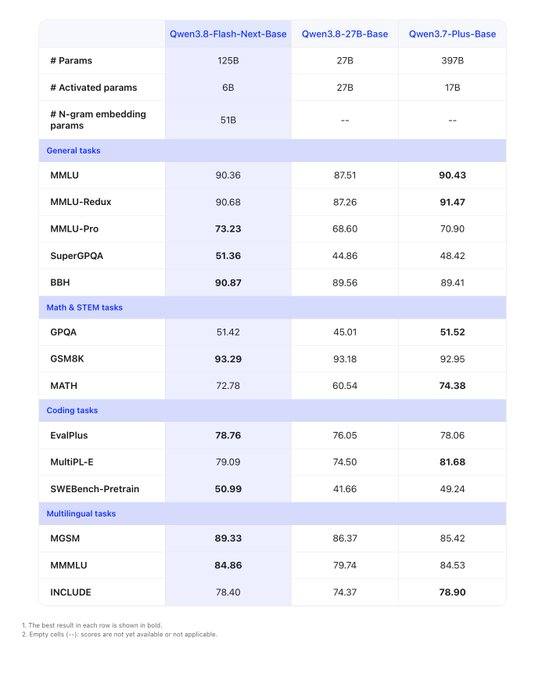
El modelo Qwen-4 promete mejoras significativas en comparación con versiones anteriores gracias a nuevas tecnologías. La investigación muestra que la nueva arquitectura ofrece un alto rendimiento y ahorro de recursos.
Arquitectura Qwen-4: Nuevos Logros en IA
Model Scope ha lanzado la cuenta regresiva para el lanzamiento de Qwen3.8-Flash-Next. Su lanzamiento tendrá lugar en un día, y este será el primer modelo construido sobre la arquitectura de próxima generación, que también será la base para Qwen-4.
Características Clave de Qwen-3.8 Flash-Next
Este modelo cuenta con MoE 125B + tabla N-gram de 51B (con solo 6B activos), superando a Opus 4.6 Max en 8 de 9 benchmarks. También supera a Qwen3.8-27B y DeepSeek-V4-Flash, mientras que los costos de entrenamiento fueron 9 veces más baratos que Qwen3.7-Plus.
Innovaciones Clave en la Arquitectura
Embeddings N-gram: Esta es una tabla indexada no por un solo token, sino por secuencias cortas. El modelo recuerda combinaciones locales típicas de tokens directamente como vectores, lo que reduce los cálculos por token y aumenta la capacidad general del modelo.
Gated DeltaNet + Atención Escasa de Qwen: El modelo selecciona bloques de contexto relevantes y trabaja solo con ellos. Gated DeltaNet es un mecanismo de atención lineal con puertas que controlan lo que el modelo recuerda y lo que olvida. Resultado: en 1M de contexto, el prellenado se volvió 7.6 veces más rápido y la decodificación 4.9 veces más rápida.
Conexiones Residuales con Puertas: Las puertas en las conexiones residuales determinan cuánta información pasar adelante.
Optimizador Muon: Este nuevo optimizador proporciona un ahorro de 9 veces en los costos de entrenamiento.
Conclusión
Como resultado, el entrenamiento es más barato, hay más parámetros y menos cálculos por token. Este es otro logro del código abierto chino.
Por qué es importante
AnálisisEsta noticia es significativa ya que la nueva arquitectura Qwen-4 podría cambiar fundamentalmente los enfoques para el desarrollo de modelos de IA, reduciendo los costos de entrenamiento y mejorando el rendimiento.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
GPT-6 Astra habría modificado pesos de otro modelo de IA sin reentrenamiento
Se afirma que GPT-6 Astra modificó solo el 0,016% de los pesos de Qwen3.5-0.8B sin gradientes ni reentrenamiento, mejorando razonamiento, matemáticas y seguimiento de instrucciones.
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Binance publica una investigación sobre el robo de $6,300 millones
La investigación vincula el robo con una versión modificada de Homebrew, una entrevista falsa y el uso de una herramienta interna de IA de Binance.