Alibaba presenta Qwen3.8-Flash-Next con pesos abiertos
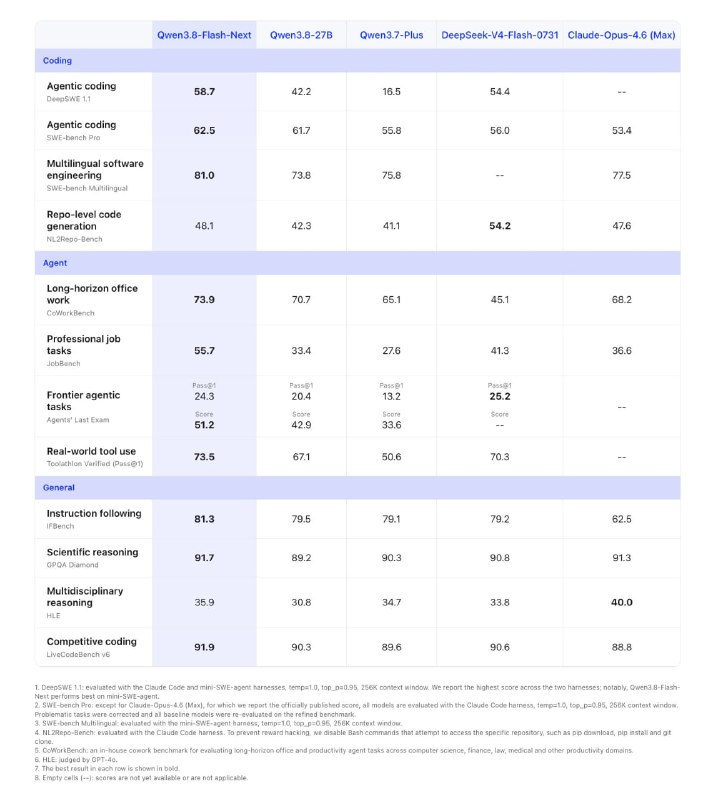
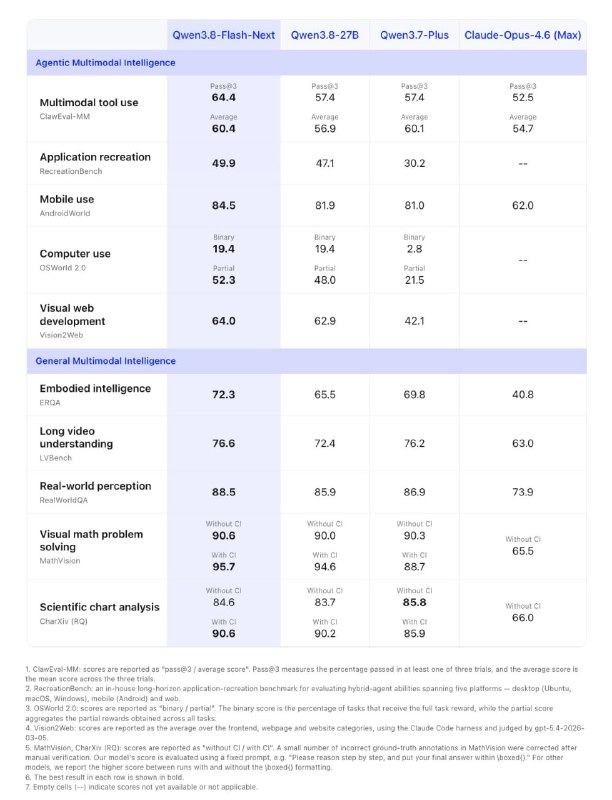
Alibaba ha presentado el nuevo modelo Qwen3.8-Flash-Next, que muestra resultados impresionantes en pruebas, superando a Claude Opus 4.6 Max.
Alibaba ha presentado Qwen3.8-Flash-Next con pesos abiertos, y ya está superando a Claude Opus 4.6 Max en varias pruebas.
Esto aún no es un Qwen4 completo, sino un adelanto temprano de su arquitectura.
El modelo cuenta con 125 mil millones de parámetros para el modelo principal más 51 mil millones de parámetros para representaciones de n-gramas, activando solo 6 mil millones de parámetros por token.
El costo de entrenamiento fue aproximadamente 9 veces más barato que Qwen3.7-Plus, pero el modelo demostró ser más fuerte en programación y tareas de oficina.
Resultados clave:
- SWE-bench Pro — 62.5 frente a 53.4 para Claude Opus 4.6 Max
- SWE-bench Multilingual — 81.0
- CoWorkBench — 73.9
- JobBench — 55.7
- Toolathlon — 73.5
- LiveCodeBench — 91.9
- GPQA Diamond — 91.7
- IFBench — 81.3
El contexto nativo es de 256K tokens, ampliable a 1 millón a través de YaRN.
Con un contexto de 1 millón de tokens, el preprocesamiento se acelera hasta 7.6 veces, y la generación hasta 4.9 veces.
Un total de 6 mil millones de parámetros activos por token, con un rendimiento ya comparable al de Opus en tareas de agentes y programación.
Pronto, el modelo estará disponible a través de API, con un precio de $0.16 por 1 millón de tokens de entrada y $0.47 por 1 millón de tokens de salida.
Por qué es importante
AnálisisEsta noticia es significativa ya que el nuevo modelo Qwen3.8-Flash-Next demuestra mejoras sustanciales en comparación con versiones anteriores, lo que podría impactar el desarrollo de tecnologías de inteligencia artificial.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Guía de prompts para los modelos generativos GPT Image
Los modelos de generación de imágenes gpt-image de OpenAI están diseñados para obtener visuales de calidad de producción y procesos creativos totalmente controlables. Son adecuados...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Thinking Machines lanza Inkling 2 Small: un modelo MoE de 594B que puede afinar otros modelos
Thinking Machines presentó Inkling 2 Small, un modelo MoE de 594B parámetros con 17B activos que lidera entre modelos abiertos en varias tareas y demostró poder fine-tunear Qwen3.5-4B de forma autónoma.
La comunidad comenta bloqueos de Anthropic en la última semana
En comentarios se menciona a usuarios que reportan cuentas bloqueadas por Anthropic durante la última semana, sin detalles.