Alibaba представила Qwen3.8-Flash-Next з відкритими вагами
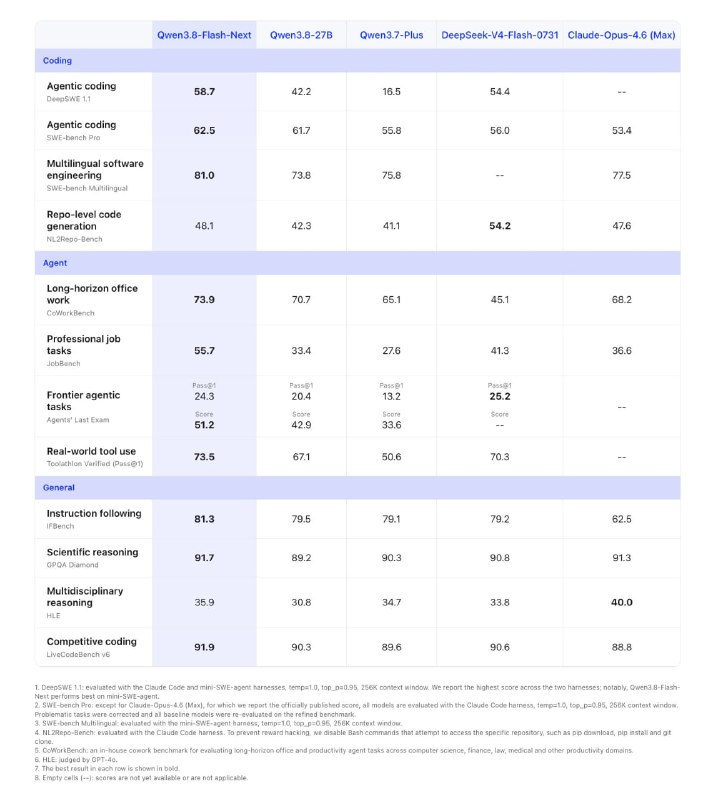
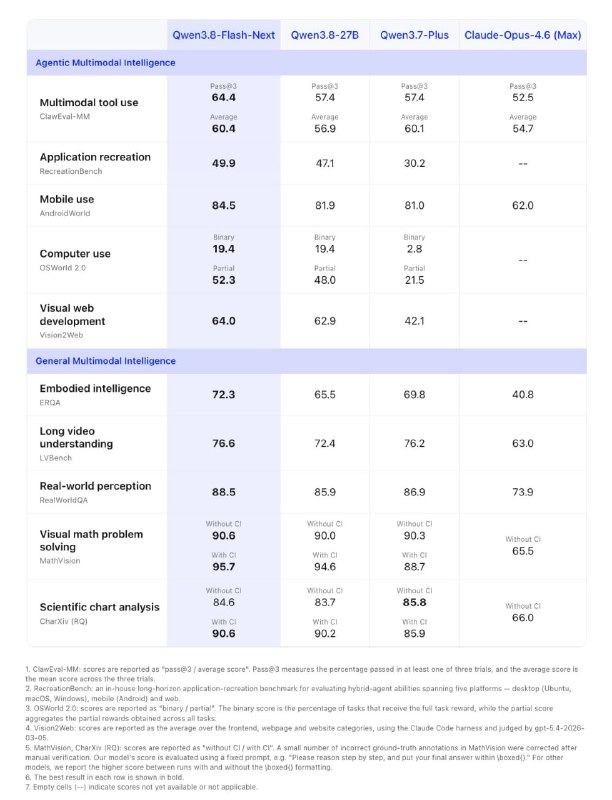
Alibaba представила нову модель Qwen3.8-Flash-Next, яка демонструє вражаючі результати в тестах, перевершуючи Claude Opus 4.6 Max.
Alibaba представила Qwen3.8-Flash-Next з відкритими вагами, і вона вже обганяє Claude Opus 4.6 Max у кількох тестах.
Це ще не повноцінна Qwen4, а раннє прев'ю її архітектури.
Модель має 125 млрд параметрів основної моделі плюс 51 млрд параметрів n-грамних представлень, при цьому на кожен токен активується всього 6 млрд параметрів.
Навчання обійшлося приблизно в 9 разів дешевше, ніж Qwen3.7-Plus, але в програмуванні та офісних задачах модель виявилася сильнішою.
Основні результати:
- SWE-bench Pro — 62,5 проти 53,4 у Claude Opus 4.6 Max
- SWE-bench Multilingual — 81,0
- CoWorkBench — 73,9
- JobBench — 55,7
- Toolathlon — 73,5
- LiveCodeBench — 91,9
- GPQA Diamond — 91,7
- IFBench — 81,3
Нативний контекст 256K токенів, через YaRN розширюється до 1 млн.
На контексті в 1 млн токенів попередня обробка прискорюється до 7,6 разів, а генерація — до 4,9 разів.
Всього 6 млрд активних параметрів на токен, а рівень вже порівнянний з Opus в агентських задачах і програмуванні.
Зовсім скоро модель з'явиться через API, по ціні $0,16 за 1 млн вхідних токенів і $0,47 за 1 млн вихідних.
Чому це важливо
АналітикаЦя новина важлива, оскільки нова модель Qwen3.8-Flash-Next демонструє значні покращення в порівнянні з попередніми версіями, що може вплинути на розвиток технологій штучного інтелекту.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
GPT-6 Astra змінила ваги іншої ШІ-моделі без донавчання
За заявою, GPT-6 Astra змінила лише 0,016% ваг Qwen3.5-0.8B без обчислення градієнтів і донавчання, нібито усунувши зациклення міркувань і покращивши математичні результати та дотримання інструкцій.
Дослідники MIT CSAIL показали Weight-Space Programming: ШІ без навчання редагує ваги Qwen3.5-0.8B
Розробники з MIT CSAIL описали Weight-Space Programming: модель Astra без градієнтного спуску читала ваги Qwen3.5-0.8B і покращила її результати на математичних бенчмарках.
Промпт-гайд по генеративним моделям GPT Image
Моделі генерації зображень gpt-image від OpenAI створені для отримання візуалів виробничої якості та повністю керованих творчих процесів. Вони підходять як для професійних дизайн-з...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: порівняння моделей 2026
Кожні кілька тижнів виходить нова модель, і щоразу ті самі запитання: чи варто переходити? що змінилося? за що платити?