Alibaba stellt Qwen3.8-Flash-Next mit offenen Gewichten vor
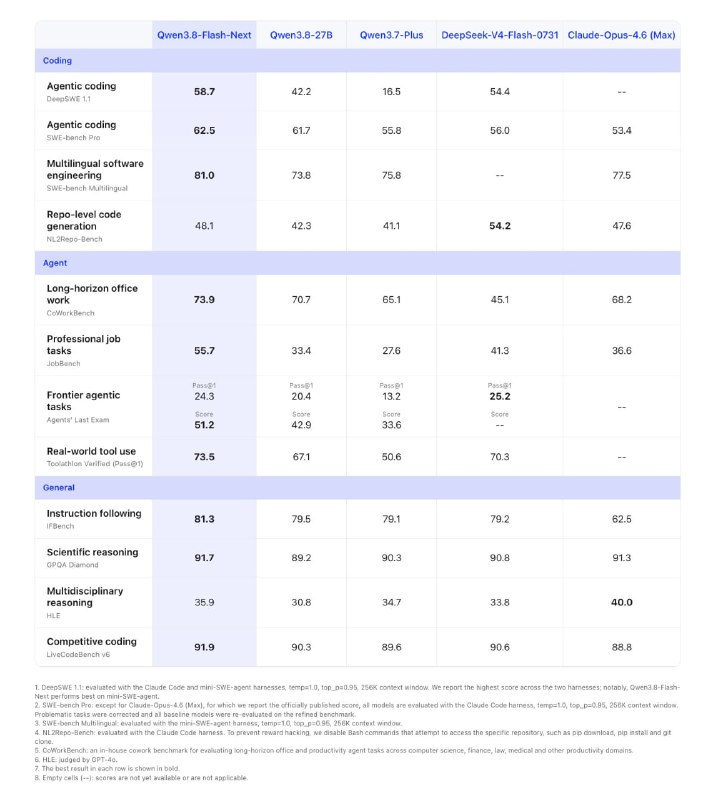
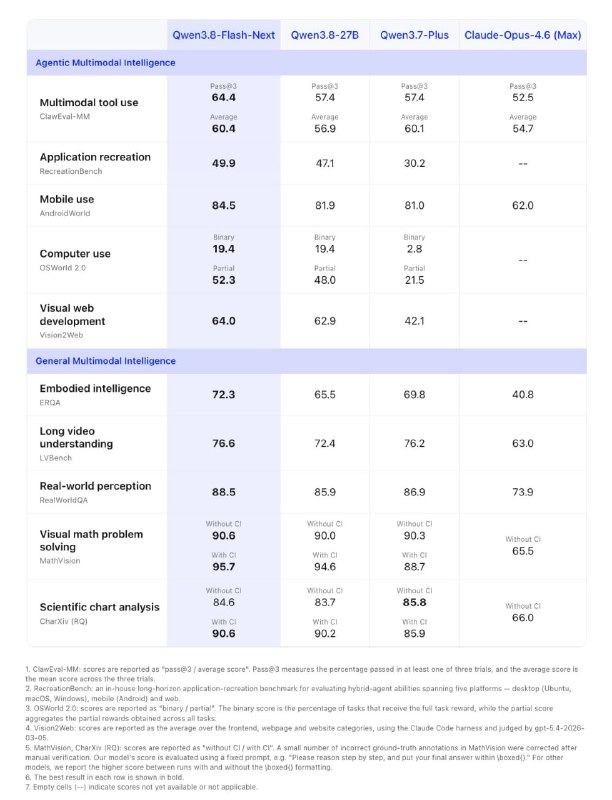
Alibaba hat das neue Modell Qwen3.8-Flash-Next eingeführt, das in Tests beeindruckende Ergebnisse erzielt und Claude Opus 4.6 Max übertrifft.
Alibaba hat Qwen3.8-Flash-Next mit offenen Gewichten vorgestellt, das bereits in mehreren Tests bessere Leistungen als Claude Opus 4.6 Max zeigt.
Es handelt sich noch nicht um ein vollständiges Qwen4, sondern um eine frühe Vorschau auf dessen Architektur.
Das Modell verfügt über 125 Milliarden Parameter im Hauptmodell sowie 51 Milliarden Parameter für N-Gramm-Darstellungen, wobei pro Token nur 6 Milliarden Parameter aktiviert werden.
Die Trainingskosten waren etwa neunmal günstiger als bei Qwen3.7-Plus, dennoch erwies sich das Modell in Programmier- und Büroaufgaben als leistungsfähiger.
Wichtige Ergebnisse:
- SWE-bench Pro — 62,5 vs. 53,4 für Claude Opus 4.6 Max
- SWE-bench Multilingual — 81,0
- CoWorkBench — 73,9
- JobBench — 55,7
- Toolathlon — 73,5
- LiveCodeBench — 91,9
- GPQA Diamond — 91,7
- IFBench — 81,3
Der native Kontext beträgt 256K Tokens und kann durch YaRN auf 1 Million erweitert werden.
Bei einem Kontext von 1 Million Tokens beschleunigt sich die Vorverarbeitung um das 7,6-Fache und die Generierung um das 4,9-Fache.
Mit insgesamt 6 Milliarden aktiven Parametern pro Token bietet es bereits eine Leistung, die mit Opus in Agentenaufgaben und beim Programmieren vergleichbar ist.
Das Modell wird bald über API verfügbar sein, zu einem Preis von 0,16 USD pro 1 Million Eingabe-Tokens und 0,47 USD pro 1 Million Ausgabe-Tokens.
Warum das wichtig ist
AnalyseDiese Nachricht ist von großer Bedeutung, da das neue Qwen3.8-Flash-Next-Modell erhebliche Verbesserungen gegenüber früheren Versionen demonstriert, was die Entwicklung von KI-Technologien beeinflussen könnte.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
GPT-6 Astra soll Gewichte eines anderen KI-Modells ohne Nachtraining geändert haben
GPT-6 Astra soll nur 0,016 % der Gewichte von Qwen3.5-0.8B ohne Gradienten oder Nachtraining verändert haben, um Reasoning-Schleifen, Mathematikergebnisse und Instruction Following zu verbessern.
Prompt-Leitfaden für GPT-Bildgenerierungsmodelle
Die Bildgenerierungsmodelle gpt-image von OpenAI sind darauf ausgelegt, Visuals in Produktionsqualität und vollständig steuerbare kreative Prozesse zu erzeugen. Sie eignen sich sowohl für professionelle Design-...
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Modellvergleich 2026
Alle paar Wochen erscheint ein neues Modell, und jedes Mal stellen sich dieselben Fragen: Lohnt sich der Wechsel? Was hat sich geändert? Wofür lohnt sich die Investition?
Binance veröffentlicht Untersuchung zum Diebstahl von 6,3 Mrd. US-Dollar
Die Untersuchung verbindet den Diebstahl mit einem manipulierten Homebrew, einem gefälschten Interview und dem Missbrauch eines internen KI-Tools von Binance.