Google lance EmbeddingGemma 2 : un modèle d'embedding multimodal
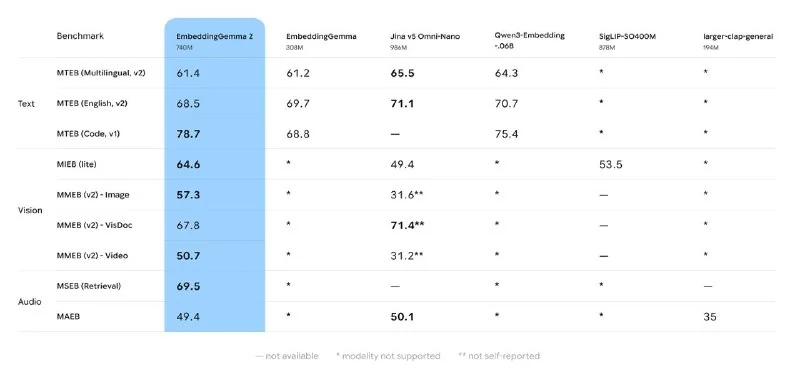
EmbeddingGemma 2 unifie le texte, le code, les images, la vidéo et l'audio dans un espace vectoriel unique, permettant désormais des entrées mixtes.
Google a dévoilé son nouveau modèle multimodal EmbeddingGemma 2. Contrairement à la première version limitée au texte, cette itération s'appuie sur Gemma 4 pour projeter le texte, le code, les images, la vidéo et l'audio dans un même espace vectoriel. Cette évolution permet désormais de traiter des données hétérogènes en entrée.
Le modèle compte 740 millions de paramètres, mais conserve une architecture modulaire. Le composant textuel représente 270 millions de paramètres, tandis que les encodeurs pour les images et l'audio sont chargés séparément selon les besoins. La fenêtre de contexte a été portée à 8 000 tokens, ce qui correspond environ à 5,5 minutes d'audio ou à 29 images traitées simultanément.
En matière de performance, la qualité reste comparable à celle de la première version pour les tâches textuelles, avec une amélioration notable du traitement du code. Google affirme obtenir les meilleurs résultats parmi les modèles d'embedding multimodaux comptant jusqu'à 1 milliard de paramètres.
Les poids sont disponibles sous licence Apache 2.0 : Hugging Face.
Annonce officielle : blog.google.
Pourquoi c'est important
AnalyseEmbeddingGemma 2 simplifie la récupération et la correspondance multimodale tout en restant compact et ouvert, facilitant ainsi son déploiement local.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Embeddings multimodaux (Multimodal Embeddings / CLIP)
Technologie permettant de projeter différents types de médias (texte, images, audio) dans un espace vectoriel multidimensionnel commun à l'aide d'architectures telles que OpenAI CLIP ou Google SigLIP. Elle permet de rechercher des photographies par descriptions textuelles ou de trouver une musique similaire à partir d'une image.
Google présente Gemini 4 Neon : le modèle dépasse Claude Opus 5.5 et GPT-6.2 Sol en code et en scénarios agentiques
Google a présenté Gemini 4 Neon, une nouvelle IA qui, selon les résultats annoncés, surpasse Claude Opus 5.5 et GPT-6.2 Sol dans la plupart des tests.
Jev et System One AI : guide pratique complet du modèle de décision TypeSafe
Analyse technique approfondie du modèle phare Jev : architecture System One vs LLM, primitives Choice/Score/Noul, parallélisme des requêtes, mathématiques de la confiance, études de cas vidéo, code et aperçu des alternatives open-weight locales (Laya, GLiNER2.5, CLM-8B).
Guide des prompts pour les modèles génératifs GPT Image
Les modèles de génération d'images gpt-image d'OpenAI sont conçus pour produire des visuels de qualité professionnelle et des processus créatifs entièrement maîtrisés. Ils conviennent aussi bien aux designers professionnels...