Google veröffentlicht multimodales EmbeddingGemma 2
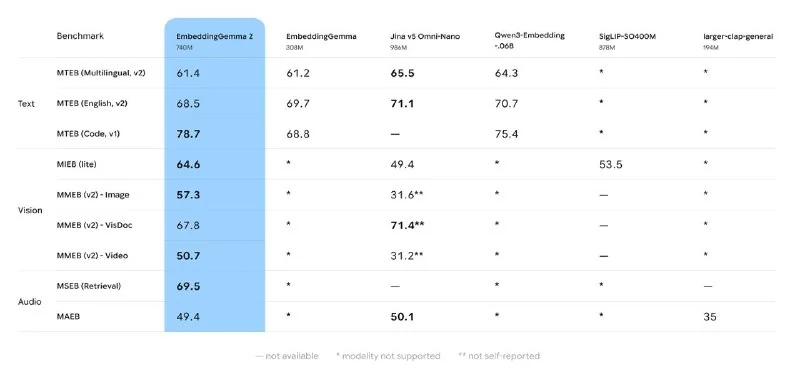
Das neue Modell bildet Text, Code, Bilder, Video und Audio in einem gemeinsamen Vektorraum ab und ermöglicht so die Verarbeitung gemischter Eingaben.
Google hat das multimodale Modell EmbeddingGemma 2 vorgestellt. Während die erste Version ausschließlich mit Texten arbeitete, basiert die zweite Generation auf Gemma 4 und integriert Text, Code, Bilder, Videos und Audio in einen einheitlichen Vektorraum. Dies erlaubt nun die direkte Nutzung von Mixed-Data als Eingabe.
Das Modell verfügt über 740 Millionen Parameter, ist jedoch modular aufgebaut: Der Textteil umfasst 270 Millionen Parameter, während Bild- und Audio-Encoder bei Bedarf separat geladen werden. Das Kontextfenster wurde auf 8K Tokens erweitert, was etwa 5,5 Minuten Audio oder der gleichzeitigen Verarbeitung von 29 Bildern entspricht.
Bei reinen Textaufgaben bleibt die Qualität auf dem Niveau der ersten Version, während die Leistung im Bereich Code deutlich verbessert wurde. Google beansprucht für das Modell die besten Ergebnisse unter allen multimodalen Embedding-Modellen mit bis zu 1 Milliarde Parametern.
Die Gewichte sind unter der Apache 2.0-Lizenz frei verfügbar: Hugging Face.
Offizielle Ankündigung: blog.google.
Warum das wichtig ist
AnalyseEmbeddingGemma 2 vereinfacht multimodale Such- und Matching-Prozesse erheblich, bleibt dabei kompakt und durch die offene Lizenz ideal für lokale Deployment-Szenarien.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern