Google udostępnia multimodalny model EmbeddingGemma 2
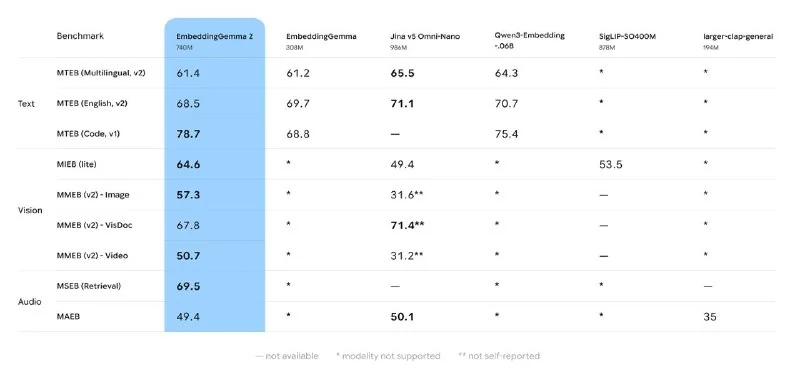
Nowa wersja modelu mapuje tekst, kod, obrazy, wideo i audio do jednej przestrzeni wektorowej, umożliwiając przetwarzanie danych mieszanych.
Google zaprezentował multimodalny model EmbeddingGemma 2. Podczas gdy pierwsza wersja obsługiwała wyłącznie tekst, druga opiera się na architekturze Gemma 4 i przekształca tekst, kod, obrazy, wideo oraz audio w pojedynczą przestrzeń wektorową. Oznacza to, że jako dane wejściowe można teraz wykorzystywać mieszane formaty.
Model posiada 740 mln parametrów, ale jego struktura jest modułowa. Część odpowiedzialna za tekst zajmuje 270 mln parametrów, natomiast enkodery obrazu i audio są ładowane osobno, w zależności od potrzeb. Okno kontekstowe zostało zwiększone do 8 tys. tokenów, co odpowiada około 5,5 minuty nagrania audio lub 29 obrazom jednocześnie.
W zadaniach związanych z tekstem jakość pozostała na poziomie pierwszej wersji, jednak wydajność w obszarze kodowania znacząco wzrosła. Google twierdzi, że osiągnięto najlepsze wyniki wśród multimodalnych modeli osadzania (embedding) o wielkości do 1 mld parametrów.
Wagi modelu są dostępne na licencji Apache 2.0: Hugging Face.
Oficjalne ogłoszenie: blog.google.
Dlaczego to ważne
AnalizaEmbeddingGemma 2 upraszcza procesy wyszukiwania i dopasowania multimodalnego, pozostając przy tym kompaktowym rozwiązaniem otwartym na lokalne wdrożenia.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami