Google Lança o EmbeddingGemma 2: Um Modelo Multimodal Unificado
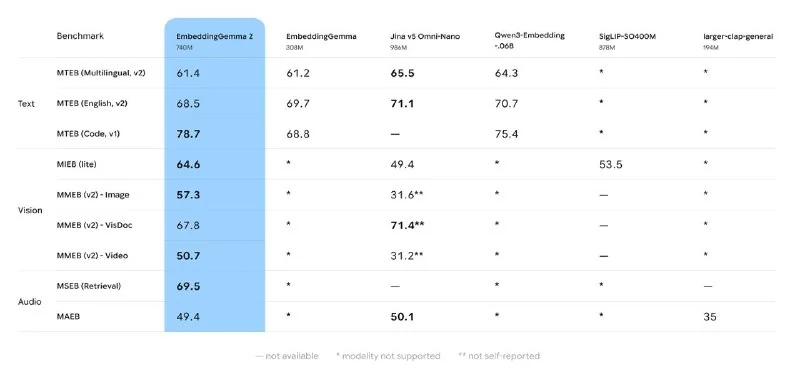
O novo modelo da Google integra texto, código, imagens, vídeo e áudio num único espaço vetorial, permitindo entradas mistas com eficiência.
A Google lançou o EmbeddingGemma 2, um modelo de incorporação multimodal. Enquanto a primeira versão operava exclusivamente com texto, a segunda é construída sobre a base do Gemma 4 e mapeia texto, código, imagens, vídeo e áudio para um único espaço vetorial, viabilizando o uso de dados mistos como entrada.
O modelo possui 740 milhões de parâmetros, mas adota uma arquitetura modular. A componente de texto consome 270 milhões de parâmetros, enquanto os codificadores de imagem e áudio são carregados separadamente conforme necessário. A janela de contexto foi ampliada para 8K tokens, o que equivale aproximadamente a 5,5 minutos de áudio ou 29 imagens processadas simultaneamente.
Em tarefas de texto, a qualidade manteve-se ao nível da primeira versão, enquanto o desempenho em código melhorou significativamente. A Google afirma alcançar o melhor resultado entre modelos de incorporação multimodal com até 1 bilhão de parâmetros.
Os pesos estão disponíveis sob a licença Apache 2.0: Hugging Face.
Anúncio oficial: blog.google.
Por que isso importa
AnáliseO EmbeddingGemma 2 simplifica a recuperação e correspondência multimodal, mantendo-se compacto e aberto para implementação local.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores