Google lanza EmbeddingGemma 2 multimodal
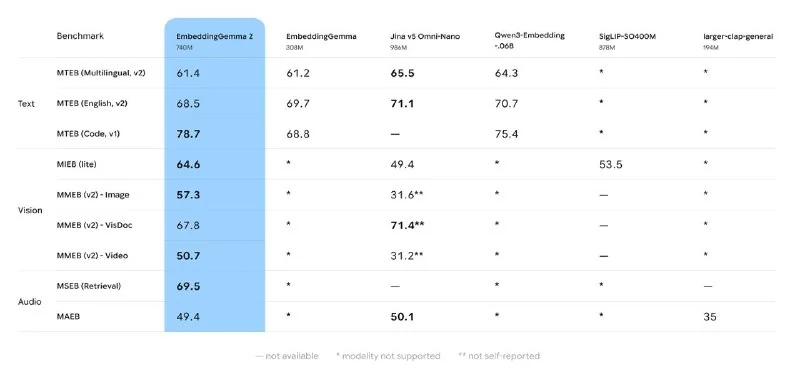
EmbeddingGemma 2 convierte texto, código, imágenes, video y audio en un único espacio vectorial y admite entradas mixtas.
Google ha lanzado el modelo multimodal EmbeddingGemma 2. La primera versión solo funcionaba con texto, mientras que la segunda está construida sobre Gemma 4 y convierte texto, código, imágenes, video y audio en un único espacio vectorial. Ahora se pueden usar datos mixtos como entrada.
El modelo tiene 740M de parámetros, pero está diseñado de forma modular. La parte de texto ocupa 270M, mientras que los codificadores de imagen y audio se cargan por separado cuando es necesario. El contexto aumentó a 8K tokens, lo que equivale a unos 5,5 minutos de audio o 29 imágenes a la vez.
En tareas de texto, la calidad se mantuvo en el nivel de la primera versión, mientras que en código mejoró notablemente. Google afirma que es el mejor resultado entre los modelos de embeddings multimodales de hasta 1B de parámetros.
Los pesos están abiertos bajo la licencia Apache 2.0: Hugging Face.
Anuncio oficial: blog.google.
Por qué es importante
AnálisisEmbeddingGemma 2 simplifica la búsqueda y el emparejamiento multimodal manteniendo el modelo compacto y abierto para despliegue local.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Gemini Flash & Pro (Google Gemini)
Familia de modelos multimodales de Google DeepMind que combina una ventana de contexto récord (hasta 2 millones de tokens), velocidad de generación extrema (más de 150 tokens/s) y percepción nativa de video y audio.
Google AI Studio: Claves API Gratis de Gemini
Sandbox oficial de Google: cómo obtener una clave API gratis de Gemini 2.0/1.5 sin tarjeta, configurar prompts del sistema y contexto de 2M. Guía 2026.
Google presenta Gemini 4 Neon: supera a Claude Opus 5.5 y GPT-6.2 Sol en código y agentes
Google presentó Gemini 4 Neon, una nueva IA que, según los resultados anunciados, supera a Claude Opus 5.5 y GPT-6.2 Sol en la mayoría de pruebas.
Jev y System One AI: guía práctica completa del modelo de decisiones de TypeSafe
Análisis ingenieril profundo del modelo insignia Jev: arquitectura System One frente a LLM, primitivas Choice/Score/Noul, paralelismo de consultas, matemática de la confianza, casos de vídeo, código y revisión de alternativas open-weight locales (Laya, GLiNER2.5, CLM-8B).