Google lance EmbeddingGemma 2 : un modèle d'embedding multimodal
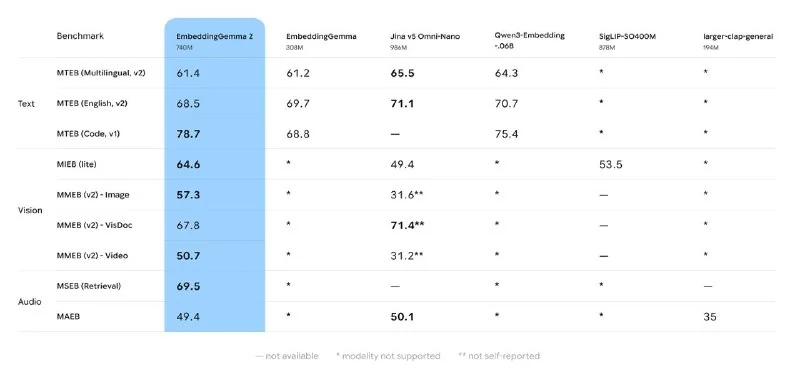
EmbeddingGemma 2 unifie le texte, le code, les images, la vidéo et l'audio dans un espace vectoriel unique, permettant désormais des entrées mixtes.
Google a dévoilé son nouveau modèle multimodal EmbeddingGemma 2. Contrairement à la première version limitée au texte, cette itération s'appuie sur Gemma 4 pour projeter le texte, le code, les images, la vidéo et l'audio dans un même espace vectoriel. Cette évolution permet désormais de traiter des données hétérogènes en entrée.
Le modèle compte 740 millions de paramètres, mais conserve une architecture modulaire. Le composant textuel représente 270 millions de paramètres, tandis que les encodeurs pour les images et l'audio sont chargés séparément selon les besoins. La fenêtre de contexte a été portée à 8 000 tokens, ce qui correspond environ à 5,5 minutes d'audio ou à 29 images traitées simultanément.
En matière de performance, la qualité reste comparable à celle de la première version pour les tâches textuelles, avec une amélioration notable du traitement du code. Google affirme obtenir les meilleurs résultats parmi les modèles d'embedding multimodaux comptant jusqu'à 1 milliard de paramètres.
Les poids sont disponibles sous licence Apache 2.0 : Hugging Face.
Annonce officielle : blog.google.
Pourquoi c'est important
AnalyseEmbeddingGemma 2 simplifie la récupération et la correspondance multimodale tout en restant compact et ouvert, facilitant ainsi son déploiement local.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs