Google Lança o EmbeddingGemma 2: Um Modelo Multimodal Unificado
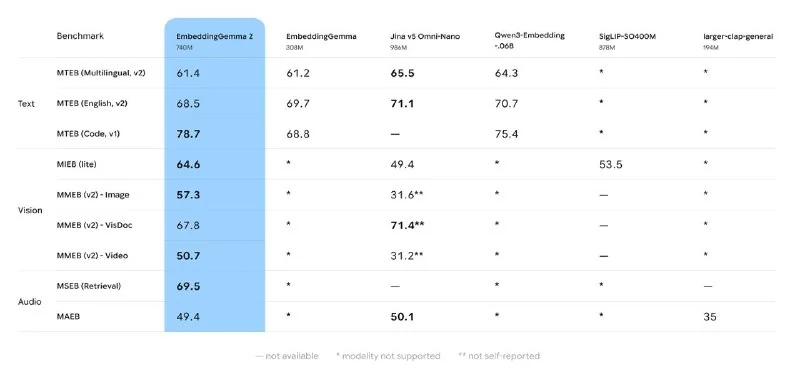
O novo modelo da Google integra texto, código, imagens, vídeo e áudio num único espaço vetorial, permitindo entradas mistas com eficiência.
A Google lançou o EmbeddingGemma 2, um modelo de incorporação multimodal. Enquanto a primeira versão operava exclusivamente com texto, a segunda é construída sobre a base do Gemma 4 e mapeia texto, código, imagens, vídeo e áudio para um único espaço vetorial, viabilizando o uso de dados mistos como entrada.
O modelo possui 740 milhões de parâmetros, mas adota uma arquitetura modular. A componente de texto consome 270 milhões de parâmetros, enquanto os codificadores de imagem e áudio são carregados separadamente conforme necessário. A janela de contexto foi ampliada para 8K tokens, o que equivale aproximadamente a 5,5 minutos de áudio ou 29 imagens processadas simultaneamente.
Em tarefas de texto, a qualidade manteve-se ao nível da primeira versão, enquanto o desempenho em código melhorou significativamente. A Google afirma alcançar o melhor resultado entre modelos de incorporação multimodal com até 1 bilhão de parâmetros.
Os pesos estão disponíveis sob a licença Apache 2.0: Hugging Face.
Anúncio oficial: blog.google.
Por que isso importa
AnáliseO EmbeddingGemma 2 simplifica a recuperação e correspondência multimodal, mantendo-se compacto e aberto para implementação local.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Google apresenta Gemini 4 Neon: modelo supera Claude Opus 5.5 e GPT-6.2 Sol em código e agentes
O Google apresentou a Gemini 4 Neon, uma nova IA que, segundo os resultados divulgados, supera a Claude Opus 5.5 e a GPT-6.2 Sol na maioria dos testes.
Jev e System One AI: guia prático completo sobre o modelo de decisão da TypeSafe
Análise técnica aprofundada do modelo principal Jev: arquitetura System One versus LLM, primitivos Choice/Score/Noul, paralelismo de requisições, matemática da confiança, casos de vídeo, código e visão geral de alternativas open-weight locais (Laya, GLiNER2.5, CLM-8B).
Guia de prompts para modelos generativos GPT Image
Os modelos de geração de imagens gpt-image da OpenAI foram criados para obter visuais de qualidade de produção e processos criativos totalmente controláveis. São adequados tanto para design profissional...
Vetores Multimodais (Multimodal Embeddings / CLIP)
Tecnologia de mapeamento de diferentes tipos de mídia (texto, imagens, áudio) para um único espaço vetorial multidimensional comum, utilizando arquiteturas como OpenAI CLIP ou Google SigLIP. Permite buscar fotografias por descrições textuais ou encontrar músicas semelhantes a partir de uma imagem.