Google veröffentlicht multimodales EmbeddingGemma 2
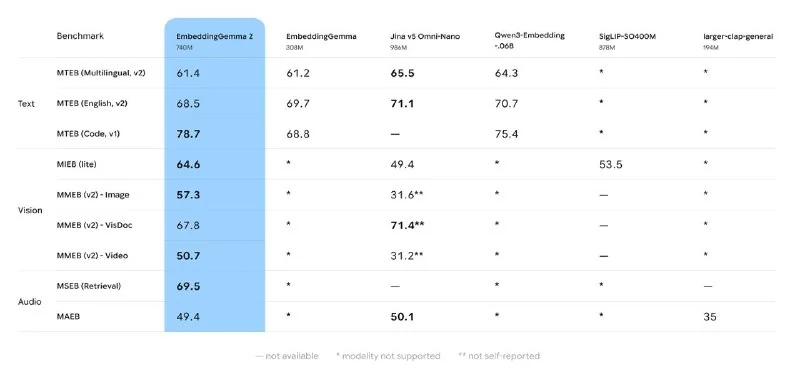
Das neue Modell bildet Text, Code, Bilder, Video und Audio in einem gemeinsamen Vektorraum ab und ermöglicht so die Verarbeitung gemischter Eingaben.
Google hat das multimodale Modell EmbeddingGemma 2 vorgestellt. Während die erste Version ausschließlich mit Texten arbeitete, basiert die zweite Generation auf Gemma 4 und integriert Text, Code, Bilder, Videos und Audio in einen einheitlichen Vektorraum. Dies erlaubt nun die direkte Nutzung von Mixed-Data als Eingabe.
Das Modell verfügt über 740 Millionen Parameter, ist jedoch modular aufgebaut: Der Textteil umfasst 270 Millionen Parameter, während Bild- und Audio-Encoder bei Bedarf separat geladen werden. Das Kontextfenster wurde auf 8K Tokens erweitert, was etwa 5,5 Minuten Audio oder der gleichzeitigen Verarbeitung von 29 Bildern entspricht.
Bei reinen Textaufgaben bleibt die Qualität auf dem Niveau der ersten Version, während die Leistung im Bereich Code deutlich verbessert wurde. Google beansprucht für das Modell die besten Ergebnisse unter allen multimodalen Embedding-Modellen mit bis zu 1 Milliarde Parametern.
Die Gewichte sind unter der Apache 2.0-Lizenz frei verfügbar: Hugging Face.
Offizielle Ankündigung: blog.google.
Warum das wichtig ist
AnalyseEmbeddingGemma 2 vereinfacht multimodale Such- und Matching-Prozesse erheblich, bleibt dabei kompakt und durch die offene Lizenz ideal für lokale Deployment-Szenarien.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Gemini Flash & Pro (Google Gemini)
Eine Familie multimodaler Modelle von Google DeepMind, die ein rekordverdächtiges Kontextfenster (bis zu 2 Millionen Tokens), extreme Generierungsgeschwindigkeit (über 150 Tokens/Sekunde) und natives Verständnis für Video und Audio kombiniert.
Google AI Studio: Kostenlose Gemini-API-Schlüssel
Offizielle Google-Sandbox: So erhalten Sie einen kostenlosen Gemini-API-Schlüssel ohne Kreditkarte, konfigurieren System-Prompts und nutzen Kontextlimits von 2 Mio. Tokens.
Google stellt Gemini 4 Neon vor: Modell übertrifft Claude Opus 5.5 und GPT-6.2 Sol bei Coding und Agenten
Google hat Gemini 4 Neon vorgestellt — ein neues KI-Modell, das laut Ankündigung Claude Opus 5.5 und GPT-6.2 Sol in den meisten Tests schlägt.
Jev und System One AI: Ein umfassender praktischer Leitfaden zum Entscheidungsmodell von TypeSafe
Tiefgehende technische Analyse des Flaggschiff-Modells Jev: Architektur von System One im Vergleich zu LLMs, Choice/Score/Noul-Primitiven, Anfrageparallelität, Unsicherheitsmathematik, Video-Anwendungsfälle, Code sowie Überblick über lokale Open-Weight-Alternativen (Laya, GLiNER2.5, CLM-8B).