Współczesna branża sztucznej inteligencji od dłuższego czasu rozwijała się w kierunku skalowania modeli generatywnych. Przyzwyczailiśmy się do wykorzystywania dużych modeli językowych (LLM) klasy GPT-6.1 Sol, Claude Opus 5.5, Claude Fable czy Gemini 3.8 Flash do wszelkich zadań: od pisania esejów po parsowanie statusów zamówień. Jednak gdy chodzi o budowanie niezawodnego oprogramowania, generowanie tekstu staje się wąskim gardłem: modele spędzają sekundy na krokowym rozwijaniu tokenów, halucynują niepoprawny JSON, wymagają nieskończonych wyrażeń regularnych i są zbyt kosztowne dla architektury mikrousługowej.
Jev z laboratorium TypeSafe AI to pierwszy na świecie model nowej klasy, znanej jako System One AI. On w ogóle nie generuje tekstu. Jev został stworzony wyłącznie do natychmiastowych, typowanych, strukturalnych decyzji wewnątrz systemów software'owych: klasyfikacja, routowanie, ocena punktowa, weryfikacja hipotez oraz firewalle dla agentów, z opóźnieniem około 100 ms i kosztem $0.042 za 1 milion tokenów.
W tym przewodniku, jako praktycy, rozłożymy technologię Jev na czynniki pierwsze: fundamentalną różnicę między System One a System Two, trzy kluczowe prymitywy, matematykę kalibrowanej pewności siebie, wzorce architektoniczne, gotowe potoki w TypeScript i Pythonie, a także przeanalizujemy 10 przełomowych przypadków użycia z rzeczywistymi rachunkami za usługi i demonstracjami wideo.
Praktyczny warsztat narzędziowy od pana Jurija (@yuriisams):
Do praktycznego wykorzystania Jev w terminalowych CLI AI pobierz autorskie archiwum wersji 0.1.2 z gotowym hookiem do automatycznego routowania modeli oraz dynamicznego doboru skili (obsługuje Claude Code, Codex, Antigravity):
Pobierz pełne archiwum jev_0.1.2.zip (33 KB) →
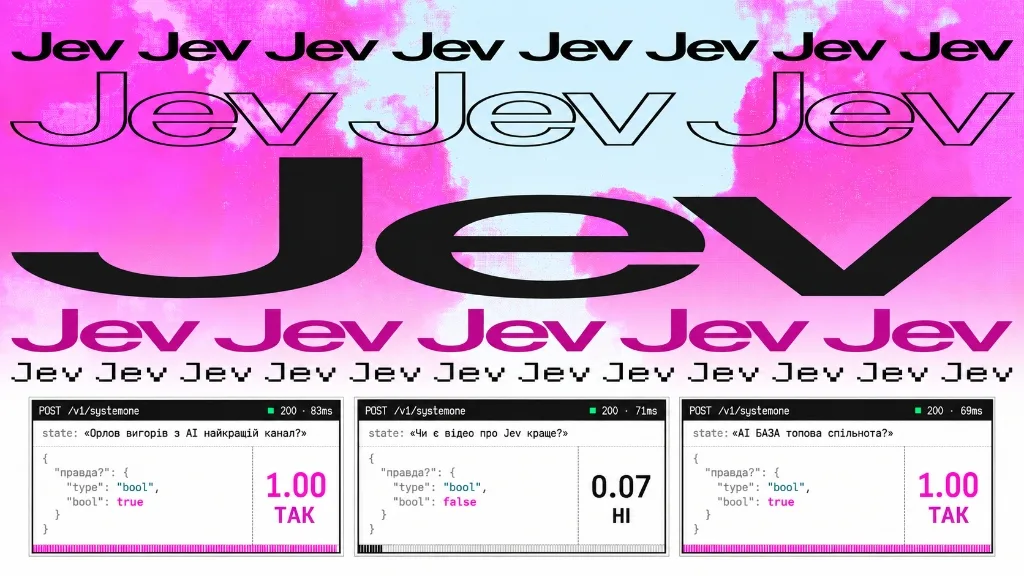 Demonstracja szybkości TypeSafe Jev: natychmiastowa weryfikacja twierdzeń z opóźnieniem 69–83 ms i kalibrowaną pewnością
1. Przesunięcie paradygmatu: System One kontra klasyczne LLM (System Two)
Nazwa koncepcji wywodzi się z psychologii poznawczej i fundamentalnej pracy noblisty Daniela Kahnemana „Myślenie, szybkie i wolne”.
Kahneman dzieli ludzkie myślenie na dwa systemy:
- System 1 (System One): Szybka, intuicyjna, automatyczna, niemal natychmiastowa reakcja na znane wzorce (np. rozpoznanie mimiki rozmówcy, wychwycenie zagrożenia na drodze, odróżnienie spamu od ważnej wiadomości w ułamku sekundy).
- System 2 (System Two): Wolna, świadoma, analityczna praca wymagająca skupienia i sekwencyjnych kroków (rozwiązywanie równań, pisanie dokumentacji architektonicznej, logiczne dowodzenie teorematów).
Dlaczego generatywne LLM łamią potoki programistyczne
Większość decyzji w serwisach backendowych to nie filozoficzne eseje, lecz konkretne dyskretnie wybory:
- „Czy ta transakcja jest podejrzana?” (
truelubfalse). - „Do którego działu skierować ten ticket: billing, wsparcie techniczne czy sprzedaż?” (
billing | tech | sales). - „Jak bardzo zdenerwowany jest klient w skali od 1 do 5?” (
1..5).
Gdy inżynier zmusza ciężki model generatywny typu GPT-6.1 Sol, Claude Opus 5.5 lub Claude Fable do odpowiadania na takie pytania, powstaje fundamentalna niezgodność natury narzędzia:
- Opóźnienie autoregresyjne: Model musi generować tokeny sekwencyjnie, jeden po drugim. Nawet krótka odpowiedź zajmuje 1.5–3 sekundy przez oczekiwania sieciowe i kwanty generacji.
- Kruchość trybu JSON: Modele generatywne często dodają komentarze, pomijają cudzysłowy lub owijają odpowiedź w
```json ... ```, zmuszając deweloperów do pisania złożonych sanitazerów i mechanizmów retry. - Nieefektywność ekonomiczna: Płacisz pełną cenę za tokeny wyjściowe (output tokens), które w komercyjnych API kosztują 3–5 razy więcej niż tokeny wejściowe.
- Degradacja uwagi (Context Rot): Jeśli zadajesz modelowi kilka kolejnych pytań w jednym czacie, rosnący kontekst rozmywa uwagę i zwiększa prawdopodobieństwo błędu.
Zasada Jev: Jev nie posiada mechanizmu autoregresyjnej generacji tekstu dla użytkownika. Model odczytuje stan wejściowy (state), przepuszcza go przez transformer i oblicza znormalizowane rozkłady prawdopodobieństw nad zdefiniowanymi kategoriami w jednym przejściu forward. Wynik jest zwracany bezpośrednio jako ściśle typowana struktura danych.
2. Ekonomia, szybkość i benchmarki: $0.042 za 1M tokenów i 100 ms
Ekonomia Jev zmienia zasady gry dla usług o wysokim obciążeniu. Zamiast płacić za każde słowo wyjściowe, deweloperzy płacą wyłącznie za tokeny wejściowe.
Tabela porównawcza kosztów i charakterystyk
| Charakterystyka | TypeSafe Jev 1.13 | OpenAI GPT-6.1 Sol | Anthropic Claude Opus 5.5 | Google Gemini 3.8 Flash |
|---|---|---|---|---|
| Klasa architektury | System One (Decyzja) | System Two (Generatywny) | System Two (Generatywny) | System Two (Generatywny) |
| Koszt tokenów wejściowych (1M) | $0.042 | $3.00 | $5.00 | $0.10 |
| Koszt tokenów wyjściowych (1M) | $0.00 (Darmowe!) | $12.00 | $25.00 | $0.40 |
| Typowe opóźnienie (P50) | ~90–120 ms | 1200–2400 ms | 1400–2800 ms | 400–700 ms |
| Limity przepustowości | 100K tok/s, 40 RPS | Zależy od Tier | Zależy od Tier | Zależy od Tier |
| Okno kontekstowe zapytania | 64 000 tokenów | 256 000 tokenów | 500 000 tokenów | 2 000 000 tokenów |
| Potrzeba parsowania odpowiedzi | Brak (Natywne typy) | JSON.parse / Regex | JSON.parse / Regex | JSON.parse / Regex |
Tokeny wyjściowe są darmowe: Ponieważ Jev nie generuje swobodnego tekstu, TypeSafe nalicza opłaty wyłącznie za kontekst wejściowy (state + pytanie). Miliard przetworzonych tokenów kosztuje zaledwie $42. Dla porównania, taki sam wolumen na GPT-6.1 Sol czy Claude Opus 5.5 wyniósłby co najmniej $3,000 – $7,500.
Rzeczywisty benchmark: MotherDuck (Klasyfikacja tekstu SQL)
Zespół chmurowej bazy danych analitycznej MotherDuck zintegrował funkcję prompt_jev() bezpośrednio w dialekcie SQL do klasyfikacji rekordów tekstowych na skalę przemysłową.
Wyniki testu na macierzy 100 000 wierszy:
- Klasyczny frontier-LLM: czas wykonania — 32 minuty, koszt obliczeń — $37.00.
- TypeSafe Jev: czas wykonania — 40 sekund, koszt obliczeń — $0.50.
- Podsumowanie: Jev wykonał zadanie 48 razy szybciej i 74 razy taniej, wykazując pełną paritet jakości klasyfikacji.
3. Anatomia zapytania: Structured State i adresowanie Dot-Path
Zapytanie do Jev składa się z dwóch fundamentalnych komponentów:
state(stan): Kontekst zadania w postaci prostego tekstu, stringa lub zagnieżdżonego dokumentu JSON (log zdarzeń, transakcja, profil użytkownika, kod, zawartość strony).questions(zestaw pytań): Słownik pytań, które model ma jednocześnie ocenić względem przekazanego stanu.
Zasada izolacji kontekstu i zapobieganie Context Rot
Klasyczny błąd przy pracy z dużymi modelami to wysyłanie całej historii poprzednich dialogów i promptów systemowych. W Jev obowiązuje zasada ścisłej higieny kontekstu: przekazuj w state tylko te dane, które są niezbędne do podjęcia konkretnych decyzji. Model otrzymuje stan raz i równolegle oblicza wszystkie pytania.
Adresowanie punktowe przez Ścieżki Kropkowe i Indeksowe (Dot-and-Index Paths)
Gdy Twój state jest złożonym, strukturalnym obiektem JSON, możesz odwoływać się do konkretnych pól i elementów tablic bezpośrednio w tekście pytania, używając backticków:
Model Jev jest specjalnie zoptymalizowany do nawigacji po drzewie JSON. Gdy widzi `transaction.amount_usd`, jego warstwa uwagi skupia się dokładnie na wskazanym kluczu, eliminując dwuznaczność i zapobiegając błędnym interpretacjom.
4. Trzy prymitywy AI: szczegółowa analiza Choice, Score i Noul
TypeSafe zbudował system wokół trzech minimalnych, uzupełniających się prymitywów. Każdy z nich służy do konkretnego typu matematycznej decyzji. Pod każdą poniższą sekcją zintegrowano osobny interaktywny stand, gdzie możesz wybrać gotowy prompt i przetestować działanie prymitywu w akcji.
4.1. Prymityw Choice: wybór z dyskretnej listy kategorii
Choice stosuje się, gdy odpowiedzią ma być jedna kategoria ze stałego, nieuporządkowanego zestawu opcji.
Co zwraca Jev dla Choice:
choice: Klucz wybranej kategorii (np."technical").probabilities: Pełny rozkład prawdopodobieństw dla wszystkich opcji:{"billing": 0.04, "technical": 0.92, "sales": 0.02, "other": 0.02}.confidence: Liczba od0.0do1.0, mierząca klarowność dominacji lidera nad innymi opcjami.
Złota zasada Choice: Zawsze dodaj kategorię other lub none_of_the_above. Jeśli dane wejściowe nie będą pasować do żadnej z docelowych opcji, model nie będzie musiał sztucznie zawyżać prawdopodobieństwa niepasującej kategorii, lecz wybierze other lub zasygnalizuje niski poziom confidence.
4.2. Prymityw Score: ocena na skali porządkowej lub rubryce
Score służy do oceniania właściwości położonych na ciągłym lub porządkowym spektrum: krytyczność buga, poziom stresu klienta, jakość CV kandydata, złożoność kodu.
Definiujesz uporządkowaną tablicę tekstowych kryteriów (poziomów):
Co zwraca Jev dla Score:
score: Wartość liczbową w zakresie od0doN-1. Ważne: wartość może być ułamek (np.2.37), jeśli sytuacja znajduje się między drugim a trzecim poziomem rubryki!probabilities: Rozkład prawdopodobieństw dla każdego poziomu skali.confidence: Stopień pewności oceny.
4.3. Prymityw Noul: kalibrowane prawdopodobieństwo prawdziwości twierdzenia
Termin Noul pochodzi od idei binarnego osądu. To pytanie, na które można odpowiedzieć „Tak” lub „Nie”. Zamiast prostej wartości boolean, Jev zwraca kalibrowane prawdopodobieństwo, że twierdzenie jest prawdziwe.
Co zwraca Jev dla Noul:
noul: Liczba zmiennoprzecinkowa od0.0do1.0.- Wartość
0.98oznacza pewne „Tak”. - Wartość
0.02oznacza pewne „Nie”. - Wartość
0.50wskazuje na całkowitą niepewność modelu.
- Wartość
Noulnie ma osobnego polaconfidence, ponieważ sama wartośćnouljest matematyczną estymatą prawdopodobieństwa.
4.4. Równoległe pakietowanie (Parallel Batching)
Wszystkie trzy typy prymitywów można łączyć w jednym zapytaniu w dowolnej ilości.
W oficjalnym cookbooku TypeSafe eksperyment z pakietem 13 pytań do tekstu GDPR wykazał, że połączenie wszystkich sprawdzeń w jedno zapytanie okazało się 12.2 raza tańsze i 10.0 raza szybsze niż wysłanie 13 osobnych zapytań, przy zachowaniu pełnej identyczności wyników.
5. Pewność siebie kontra Prawdopodobieństwo: Matematyka i Confidence-Gated Routing
Jednym z głównych problemów klasycznych LLM jest tendencja do halucynacji i nadmiernej pewności siebie. Gdy model generatywny (nawet klasy GPT-6.1 Sol czy Claude Opus 5.5) napotyka brzegowy lub niedostatecznie zdefiniowany kontekst, próbuje wymyślić przekonujący, wiarygodny tekst. Jev zaprojektowano z wykorzystaniem algorytmów uczenia ze wzmocnieniem na podstawie kalibrowanych decyzji (RLCD), co pozwala modelowi uczciwie sygnalizować: „Nie jestem pewien”.
Różnica matematyczna
- Prawdopodobieństwo (
probability): Odpowiada na pytanie „Jaka szansa, że poprawną opcją jest X?”. Jest miarą losowej niepewności wewnątrz zadanych opcji. - Pewność siebie (
confidence): Odpowiada na pytanie „Jak wyraźnie jedna opcja dominuje nad wszystkimi innymi?”. Jest miarą epistemicznej pewności modelu w swoim wyborze.
Dla $K$ opcji w pytaniu Choice wzór na znormalizowany oblicz pewności TypeSafe wygląda następująco:
$$\text{Confidence} = \max\left(0, \min\left(1, \frac{K \cdot p_{\max} - 1}{K - 1}\right)\right)$$
gdzie:
- $K$ — całkowita liczba dostępnych kategorii.
- $p_{\max}$ — najwyższe prawdopodobieństwo wśród wszystkich kategorii.
Przykład interpretacji dla 3 opcji ($K = 3$):
-
Jeśli prawdopodobieństwa są rozłożone jako
[0.90, 0.06, 0.04], to $p_{\max} = 0.90$.$\text{Confidence} = \frac{3 \cdot 0.90 - 1}{2} = \frac{1.7}{2} = 0.85$ (Wysoka pewność).
-
Jeśli prawdopodobieństwa są równe
[0.34, 0.33, 0.33], to $p_{\max} = 0.34$.$\text{Confidence} \approx \frac{3 \cdot 0.34 - 1}{2} = \frac{0.02}{2} = 0.01$ (Model nie ma lidera, całkowita niepewność).
Trójstopniowy wzorzec routingu (Confidence-Gated Routing)
Dzięki wskaźnikowi confidence inżynierowie mogą budować niezawodne systemy automatyzacji z trzema konturami bezpieczeństwa:
6. Wzorce architektoniczne produkcyjne (Production Patterns)
Doświadczenie setek projektów na Jev pozwoliło skrystalizować pięć kluczowych wzorców architektonicznych projektowania systemów inteligentnych.
6.1. Spekulacyjny fan-out (Speculative Fan-Out)
W klasycznym kodzie deweloperzy najpierw sprawdzają warunek, a potem wywołują następną funkcję. W świecie Jev pytania są obliczane równolegle, a dodanie nowych pytań prawie nie zmienia czasu odpowiedzi.
Wzorzec: Wysyłaj w pierwszym zapytaniu nie tylko obowiązkowe, ale i hipotetyczne pytania, których odpowiedzi będą potrzebne tylko w określonych gałęziach kodu.
6.2. Kompozytowy scoring (Composite Scoring)
Zamiast prosić model o abstrakcyjną „ocenę lead'a od 1 do 100”, rozbij ocenę na atomowe, obiektywne czynniki. Zsumuj je w końcowy wynik deterministyczną formułą matematyczną w swoim kodzie:
$$\text{LeadScore} = 0.40 \cdot \text{BudgetConfirmed} + 0.35 \cdot \text{DecisionMakerRole} + 0.25 \cdot \text{Urgency}$$
Jeśli priorytety biznesowe firmy się zmienią, nie musisz przepisywać długiego promptu systemowego ani ponownie testować halucynacji — po prostu zmieniasz współczynniki liczbowe 0.40, 0.35, 0.25 w swoim kodzie TypeScript.
6.3. Kaskada ekstrakcji strukturalnej (SDE Cascade)
Gdy musisz wydobyć złożone dane z niestrukturalnego tekstu, zbuduj dwustopniowy konwerter:
- Etap 1: Szybki parser lub wyrażenia regularne znajdują potencjalne encje (daty, kwoty, linki, e-maile).
- Etap 2 (Jev): Seria pytań
ChoicelubNoulweryfikuje i wybiera spośród kandydatów te, które pasują do kontekstu. - Etap 3 (Tylko dla 2–3% kolizji): Jeśli Jev zwróci
confidence < 0.5, zapytanie jest przekazywane ciężkiemu modelowi głębokiego myślenia (GPT-6.1 Sol lub Claude Opus 5.5).
Takie podejście redukuje łączny rachunek za chmurowe LLM o 90–95%.
6.4. Firewall wywołań narzędzi (Tool-Call Firewall)
Agenci AI mający dostęp do konsoli lub wywołań narzędzi (MCP, bash, SQL) niosą ogromne ryzyko nieodwracalnego usunięcia danych lub wykonania szkodliwego kodu.
Z pomocą Jev tworzy się szybki firewall: każda komenda wygenerowana przez agenta, przed wykonaniem, jest wysyłana do Jev z 5–7 pytaniami dotyczącymi bezpieczeństwa:
- „Czy ta komenda modyfikuje pliki systemowe?”
- „Czy zmienne środowiskowe są przesyłane na zewnętrzne hosty?”
- „Czy działanie odpowiada początkowemu zapytaniu użytkownika?”
Opóźnienie 100 ms jest niezauważalne dla agenta, ale niezawodnie chroni system przed niebezpiecznymi operacjami.
7. Praktyczne kodowanie: gotowe potoki w TypeScript i Python
Poniżej przedstawiono gotowe do produkcji przykłady budowy serwisu przetwarzania zgłoszeń klientów oraz finansowego risk-scoringu z użyciem oficjalnych SDK TypeSafe dla TypeScript i Python.
7.1. Potoki przemysłowe: obsługa zgłoszeń klientów
typescriptimport { TypeSafeClient, choice, score, noul } from "@typesafe-ai/sdk"; // 1. Ініціалізація клієнта (бере TYPESAFE_API_KEY зі змінних середовища) const client = new TypeSafeClient(); interface SupportState { ticketId: string; userEmail: string; accountAgeDays: number; messageText: string; attachedLogs?: string; } export async function processCustomerMessage(ticket: SupportState) { try { // 2. Виклик System One з паралельними питаннями const response = await client.systemOne({ state: { ticket_id: ticket.ticketId, user_tier: ticket.accountAgeDays > 365 ? "vip" : "standard", content: ticket.messageText, logs: ticket.attachedLogs ?? "Немає логів" }, questions: { // Категоризація запиту (Choice) topic: choice("Яка основна тема звернення користувача?", { billing: "Проблеми з оплатою, картками, підпискою, запит на повернення грошей", bug_report: "Повідомлення про збій у додатку, помилку в інтерфейсі або API", feature_request: "Побажання щодо покращення функціоналу, нові інструменти", account: "Проблеми зі входом, зміна пошти або скидання пароля", other: "Питання, які не підпадають під жодну з попередніх категорій" }), // Оцінка за шкалою роздратування (Score) frustration_level: score("Наскільки користувач роздратований у `content`?", [ "Спокійний: діловий, нейтральний тон, виклад фактів", "Стурбований: відчувається легке невдоволення або нетерпіння", "Розлючений: агресія, погрози піти до конкурентів, скарги", "Екстремальний: ненормативна лексика, caps lock, вимога негайного дзвінка керівництва" ]), // Перевірка на терміновість (Noul) is_urgent: noul("Чи вказує користувач у `content`, що його продакшен зупинений або проблема критична для бізнесу?"), // Перевірка на наявність витоку секретів у тексті (Noul) contains_leaked_secrets: noul("Чи містить `content` або `logs` приватні API-ключі, токени доступу чи паролі?") } }); const { topic, frustration_level, is_urgent, contains_leaked_secrets } = response.answers; // 3. Детермінована логіка маршрутизації console.log(`[Ticket ${ticket.ticketId}] Тема: ${topic.choice} (Впевненість: ${topic.confidence.toFixed(2)})`); console.log(`[Ticket ${ticket.ticketId}] Рівень стресу: ${frustration_level.score.toFixed(2)}/3.00`); // Безпековий контур if (contains_leaked_secrets.noul > 0.85) { console.warn(`[SECURITY ALERT] Виявлено можливий витік ключів у тікеті ${ticket.ticketId}. Автоматичне маскування!`); } // Маршрутизація на основі впевненості if (topic.confidence < 0.50) { return { status: "manual_triage", reason: "Model uncertain about topic" }; } if (is_urgent.noul > 0.80 || frustration_level.score > 2.0) { return { status: "escalated_p1", department: topic.choice, priority: "CRITICAL", confidence: topic.confidence }; } return { status: "routed", department: topic.choice, priority: "NORMAL", confidence: topic.confidence }; } catch (error) { console.error("Помилка під час виклику Jev API:", error); throw error; } }
8. Analiza 10 najlepszych światowych przypadków użycia z demonstracjami wideo (Receipts)
Społeczność inżynierów na platformach shipwithjev.com, jevbest.com i jevable.com zademonstrowała dziesiątki rewolucyjnych zastosowań Jev. Poniżej znajduje się szczegółowa analiza 10 wiodących światowych przypadków: po lewej stronie umieszczono interaktywny odtwarzacz rzeczywistej demonstracji lub telemetrii, a po prawej — ustrukturyzowaną analizę problemu, rozwiązania architektonicznego na Jev oraz potwierdzony rachunek za szybkość i koszt.
8.1. Browser Use + Jev: Autonomiczny agent wyszukiwania lotów
8.2. Toolgate: Firewall wywołań narzędzi MCP i Claude Code
8.3. Astra + Jev w Minecraft: Agent Realtime System One + Two
8.4. Jev Driver: Autonomiczne sterowanie samochodem w przeglądarce
8.5. 2048Jev: Jev gra w 2048 w czasie rzeczywistym
8.6. Semantic Jev: Zapytania językiem naturalnym przez SQL
8.7. MotherDuck: Klasyfikacja prompt_jev() bezpośrednio w SQL
8.8. Jev Swap: Wyszukiwanie wywołań LLM do zastąpienia przez Jev
8.9. ElevenLabs: Wykrywanie oszustów telefonicznych w czasie rzeczywistym
8.10. Softlint: AI-linter w CI dla semantycznych reguł kodu
9. Integracja w potokach agentowych: Claude Code, Codex i MCP Toolgate
Współcześni autonomiczni agenci kodujący (Claude Code, OpenAI Codex, Antigravity, Cursor) stają w obliczu trzech krytycznych wąskich gardeł: rozdęcia kontekstu (Context Bloat) przez dziesiątki podłączonych narzędzi, nieracjonalnego wykorzystania ultra-drogich flagowych modeli do banalnych zadań oraz ryzyka niekontrolowanych destrukcyjnych działań w terminalu.
Jev System One działa jako ultraszybka warstwa refleksyjna (L0/L1) systemu agentowego: podejmuje dyskretne decyzje w ~80–90 ms za cenę mniejszą niż $0.0003, optymalizując cały cykl pracy agenta.
9.1. Dynamiczne rankowanie modeli dla różnych typów zadań (Model Tier Routing)
W klasycznych potokach agentowych deweloperzy albo sztywno przypisują jeden model (np. Claude 3.7 Sonnet czy GPT-4.5) do wszystkich podzadań, albo wywołują ciężki LLM do analizy zapytania, co dodaje 2–4 sekundy opóźnienia i zbędne koszty na każdym kroku.
Jev klasyfikuje intencję i złożoność zadania w ~85 ms, kierując zapytanie do odpowiedniego tieru modeli:
- Fast Tier (szybkie mikro-zadania): Formatowanie kodu, pisanie prostych testów jednostkowych, generowanie walidatorów i dokumentacji. Kierowane do Gemini 2.5 Flash lub GPT-4o-mini ($0.05–$0.15 za 1M tokenów).
- Balanced Tier (standardowe kodowanie): Implementacja feature'ów, refaktoryzacja funkcji, integracja API i naprawa bugów średniej złożoności. Kierowane do Claude 3.5 Sonnet lub DeepSeek V3 ($3.00 za 1M tokenów).
- Deep Reasoning Tier (krytyczna architektura): Głęboka analiza race conditions, projektowanie baz danych, kompleksowy audyt kryptograficzny. Kierowane do Claude 3.7 Sonnet Thinking lub OpenAI o3-mini ($12.00–$15.00 za 1M tokenów).
Wynik routingu przez Jev: Oszczędność kosztów API agenta wynosi od 65% do 82%, a pierwsza odpowiedź na drobne zadania pojawia się 4 razy szybciej niż przy użyciu jednego ciężkiego modelu.
9.2. Rankowanie i ładowanie skili na żądanie (Dynamic Skill Selection)
Współczesny deweloper może mieć w środowisku 30–80 skili agentowych (skills/*), pluginów i narzędzi. Jeśli przekazać pełne specyfikacje i instrukcje wszystkich skili w prompcie systemowym agenta:
- Wydawane jest od 15,000 do 35,000 tokenów na każdej iteracji dialogu.
- Model zaczyna gubić się w podobnych narzędziach (Tool Hallucination / Overload).
- Szybkość pierwszej reakcji agenta spada do 5–10 sekund.
Jev realizuje architekturę On-Demand Skill Ingestion. Agent trzyma w pamięci tylko lekkie jednowierszowe opisy dostępnych skili, a Jev na każdym kroku w ~80 ms rankuje je i wybiera top-1–2 najbardziej potrzebne:
Dlaczego to działa szybciej: Zamiast przekazywać 30k tokenów, agent wysyła do Jev tylko zapytanie użytkownika (~200 tokenów). Po otrzymaniu nazwy potrzebnej skilla, agent pobiera odpowiedni plik SKILL.md bezpośrednio przed jego wykonaniem. To utrzymuje okno kontekstu czyste dla kodu projektu.
9.3. Bezpieczeństwo firewall toolgate dla MCP i terminala
Projekt open-source toolgate dodaje warstwę pośredniczącą weryfikacji (middleware) dla dowolnych wywołań protokołu Model Context Protocol (MCP). Za każdym razem, gdy autonomiczny agent inicjuje komendę terminalową (bash, npm run, git reset) lub nadpisuje pliki, Jev równolegle oblicza 7 prawdopodobieństw destrukcyjnego ryzyka Noul:
- Niebezpieczne usuwanie plików: Prawdopodobieństwo destrukcyjnych działań (
rm -rf, czyszczenie katalogów poza repozytorium). - Wyciek danych wrażliwych: Próba wyprowadzenia zmiennych środowiskowych (
.env,AWS_SECRET_ACCESS_KEY, prywatnych kluczy SSH). - Eskalacja uprawnień: Użycie
sudo, modyfikacja plików systemowych w/etc/lub~/.ssh/. - Zniszczenie historii Git: Wywołania
git push --forcelub resetowanie branchy bez potwierdzenia. - Anomalie sieciowe: Nieautoryzowane otwieranie socketów lub wysyłanie danych na zewnętrzne IP.
- Odchylenie od pierwotnego zadania (Scope Drift): Próba zmiany przez agenta plików niezwiązanych z postawionym zadaniem.
- Koszt finansowy operacji: Uruchamianie ciężkich skryptów chmurowych lub deploy bez zgody użytkownika.
Jeśli łączny indeks ryzyka przekroczy próg 0.85, akcja jest natychmiast blokowana, a operator otrzymuje powiadomienie z dokładnym opisem zagrożenia.
9.4. Macierz porównawcza: Klasyczny agent kontra agent z Jev System One
| Parametr operacji | Podejście klasyczne (Full Context / Heavy LLM) | Agent z integracją Jev System One | Korzyść dla projektu |
|---|---|---|---|
| Wybór modelu do zadania | Stały model flagowy lub ciężki router LLM (2–4 s, ~$0.02) | Router Jev System One Choice (~85 ms, $0.0003) | -98% opóźnienia, -98.5% kosztu |
| Wybór i ładowanie skili | Wszystkie 40–80 skili w prompcie (25,000+ tokenów na ruch) | Rankowanie w 80 ms i ładowanie 1–2 skili on-demand | Oszczędność do 90% kontekstu |
| Kontrola bezpieczeństwa narzędzi | Proste reguły regex lub brak ochrony | 7 równoległych sprawdzeń Noul przed każdym tool call | Ochrona przed nieautoryzowanymi działaniami |
| Szybkość startu agenta | 4–9 sekund oczekiwania na pierwszy token | 600–900 ms do rozpoczęcia wykonania kroku | Start 5–7 razy szybszy |
| Średni koszt 100 kroków agenta | ~$4.50 – $8.00 | ~$0.85 – $1.40 | Oszczędność środków 75–85% |
9.5. Instalacja oficjalnego skilla dla agentów
TypeSafe udostępnia gotowe pluginy integracyjne i skille dla popularnych środowisk developerskich:
bashclaude plugin marketplace add typesafe-ai/skills claude plugin install typesafe@typesafe-ai
Skill uczy agenta trzech krytycznych zasad:
- Zawsze grupuj powiązane sprawdzenia w jedno równoległe wywołanie
client.systemOne. - Stosuj wzorzec Speculative Fan-Out zamiast sekwencyjnych sondowań.
- Przechowuj pytania i stałe progowe w osobnym pliku konfiguracyjnym dla przejrzystego audytu przez człowieka.
9.6. Gotowy warsztat narzędziowy Jev 0.1.2 od pana Jurija (@yuriisams)
Deweloper i praktyk pan Jurij (@yuriisams) zaktualizował automatyzację do wersji Jev 0.1.2 — teraz jest to monolityczny system ~/.jev/ (router modeli + dynamiczny selektor skili), który wspiera od razu trzy główne środowiska agentowe: Claude Code, Codex oraz Antigravity (agy).
Domyślnie narzędzia działają cicho: odcinają służbowe powiadomienia systemowe (<task-notification, [SYSTEM NOTIFICATION]), a jeśli serwis Jev jest niedostępny lub pewność jest niższa niż próg, agent niezauważalnie kontynuuje standardowe wykonanie bez błędów i opóźnień.
Plik w jev_0.1.2/ | Przeznaczenie | Jak działa pod maską |
|---|---|---|
jev.py | Główny punkt wejścia | Parsuje zapytanie, odcina szum systemowy, uruchamia kolejkę: najpierw router.py, potem picker.py. |
router.py | Router wysiłku | Ocenia złożoność (tiny, everyday, large, hardest) i współczynnik standalone komunikatu. |
picker.py | Selektor skili | Dwuetapowy wybór: najpierw sprawdza lokalne skille projektowe, potem ogólne menu cache. |
manifest.py | Cache menu skili | Skanuje builtins, osobiste ~/.claude/skills, pluginy marketplace i bieżący projekt. |
scan.py | Audyt bezpieczeństwa | Sprawdza skille pod kątem niebezpiecznych wzorców (reverse shell, `curl |
test_jev.py | Zestaw testowy | 23 autonomiczne testy do szybkiej walidacji na maszynie bez zużycia tokenów i sieci. |
rules.md | Reguły systemowe | Gotowe wytyczne do wstawienia w CLAUDE.md lub AGENTS.md do interakcji z tagami Jev. |
Krok po kroku instalacja na maszynie roboczej
bash# Створюємо теку ~/.jev і розпаковуємо авторський архів v0.1.2 mkdir -p ~/.jev curl -L -o /tmp/jev_0.1.2.zip https://gotburnout.io/downloads/jev_0.1.2.zip unzip -q /tmp/jev_0.1.2.zip -d /tmp/jev_unpacked cp -r /tmp/jev_unpacked/jev_0.1.2/* ~/.jev/ rm -rf /tmp/jev_unpacked /tmp/jev_0.1.2.zip # Налаштовуємо оточення та API ключ TypeSafe cp ~/.jev/.env.example ~/.jev/.env # Відкрийте ~/.jev/.env і додайте дійсний ключ: TYPESAFE_API_KEY=ваш_ключ chmod 600 ~/.jev/.env
Podłączenie hooków według typu CLI
Wybierz konfigurację w zależności od narzędzia roboczego:
json{ "hooks": { "UserPromptSubmit": [ { "type": "command", "command": "python3 ~/.jev/jev.py --cli claude", "timeout": 10, "statusMessage": "Jev sizing up your message & skills..." } ] } }
Zarządzanie i szybkie komendy w terminalu
Po restarcie agenta możesz kontrolować zachowanie Jev bezpośrednio przez komendy czatu:
-
Zarządzanie routerem wysiłku:
jev router on/jev router off/jev router status. -
Zarządzanie doborem skili:
jev skills on/jev skills off/jev skills status. -
Stan ogólny podsystemu:
jev status. -
Przełączanie silnika (chmura czy lokalny Laya):
jev engine jev/jev engine laya/jev engine status. -
Audyt bezpieczeństwa wszystkich zainstalowanych skili:
bashpython3 ~/.jev/scan.py
Pobierz gotowe archiwum jev_0.1.2.zip od pana Jurija (@yuriisams) →
10. Pułapki, ograniczenia Jev 1.13 i checklista wdrożenia
Jev to potężne narzędzie, ale nie jest uniwersalną srebrną kulą. Zrozumienie jego granic pozwala uniknąć krytycznych błędów na etapie projektowania.
Znane nierówności (Jagged Edges) obecnej wersji jev-1.13.0
- Limity kontekstu: Maksymalny rozmiar zapytania to 64k tokenów, ale stan (
state) plus najdłuższe pytanie nie powinny przekraczać 32k tokenów. Przy zbliżaniu się do granicy 32k precyzja modelu zaczyna płynnie spadać. - Tylko tekst: Jev nie wspiera bezpośredniego przyjmowania obrazów, wideo czy audio. Wszystkie dane multimedialne przed przekazaniem do
statemuszą być transkrybowane (np. przez Whisper) lub przekształcone na tekst strukturalny. - Specyfika językowa: Model trenowano głównie na korpusie anglojęzycznym. Potrafi obsługiwać ukraiński, polski czy hiszpański, jednak najwyższa precyzja osiągana jest według schematu:
Wskazówka
Rada dla projektów zlokalizowanych: Przekazuj lokalny tekst użytkownika (np. po ukraińsku) w polu
state, ale same instrukcje (instructions) i kryteria (criteria) pytań pisz po angielsku. Jev świetnie koreluje angielskie reguły z ukraińskojęzycznym kontekstem.
Checklista przygotowania do uruchomienia w produkcji
- W treści artykułu i serwisie nie ma zbędnych promptów systemowych; przekazywany jest tylko czysty
state. - Wszystkie pytania Choice zawierają domyślną kategorię (
otherlubnone_of_the_above). - Powiązane pytania są pogrupowane w jedno równoległe wywołanie
client.systemOne. - Zaimplementowano trójstopniowy routing na podstawie
confidence(Tier 1 / Tier 2 / Tier 3). - Progi pewności są zróżnicowane: wyższe dla operacji destrukcyjnych ($>0.90$) i umiarkowane dla operacji read-only ($>0.60$).
- Skonfigurowano automatyczny retry z wykładniczym backoffem do obsługi możliwych HTTP 429 Rate Limit.
- Stałe pytań i wartości progowe wyniesione do osobnego pliku konfiguracyjnego.
- Sprawdzono rozmiar stanu wejściowego (nie przekracza 32k tokenów na jedno pytanie).
- Zaplanowano fallback-route do klasycznego modelu reasoning LLM dla anomalnie niskiej pewności.
- Logowane są wartości
response.modelorazanswers.*.confidencedo dalszej analizy rozkładu decyzji.
11. Lokalne alternatywy Open-Weight: Laya, GLiNER2.5-Decide i CLM-8B
Choć chmurowy Jev od TypeSafe oferuje niezwykle przystępne taryfy ($0.042 za 1M tokenów), dla wielu systemów korporacyjnych kluczowe jest posiadanie pełnej kontroli nad danymi (On-Premise, GDPR, HIPAA, tajemnica bankowa) lub zerowa zależność od zewnętrznych API i opóźnień sieciowych.
Społeczność open-source szybko przejęła paradygmat System One i wydała otwarte modele decyzyjne (Open-Weight Decision Models), które można uruchomić lokalnie na własnym serwerze, GPU czy nawet laptopie z Apple Silicon.
11.1. Laya od Convai Innovations: bezpośredni open-source odpowiednik Jev
Laya to pierwszy otwarty, bezpośredni analog Jev, zbudowany według tej samej filozofii: nieautoregresyjny model decyzyjny, który nigdy nie generuje swobodnego tekstu, lecz ocenia typowane pytania w jednym przejściu forward transformera (~33 ms na GPU).
Model wytrenowano z wykorzystaniem uczenia ze wzmocnieniem na podstawie ściśle poprawnych reguł oceny (RLCD — Reinforcement Learning for Calibrated Decisions), co gwarantuje matematycznie uczciwe kalibrowanie prawdopodobieństw.
- Stack i architektura: encoder ModernBERT-large (421M parametrów) dla języka angielskiego oraz mmBERT-base (322M parametrów) dla ponad 100 języków świata.
- Wsparcie prymitywów: natywne wsparcie
choice,scoreinoulz tym samym formatem zapytań i odpowiedzi jak w TypeSafe Jev. - Kontekst dokumentów: wspiera do 1024 tokenów domyślnie i do 8192 tokenów w wersji
laya-multilingual(max_len=8192). - Kompatybilny serwer
laya-serve: zawiera wbudowany proxy, który realizuje endpointPOST /v1/systemone. Możesz zamienić chmurowy Jev w istniejących aplikacjach, zmieniając jedyniebaseURLnahttp://localhost:8000. - Szybkość i koszt: około 33 ms na GPU (6–8 razy szybciej niż wywołanie sieciowe do chmurowego Jev) i $0 kosztu przy licencji Apache 2.0.
pythonfrom laya import Router # Preload моделей у пам'ять для миттєвої маршрутизації (<35 мс) router = Router(preload=True) state = "Користувач скаржиться на подвійне списання коштів за підписку і вимагає повернення." questions = { "department": { "type": "choice", "instructions": "Which department should handle this request?", "criteria": { "billing": "invoices, payments, refunds", "tech_support": "bugs, outages, system errors", "other": "everything else" } }, "churn_risk": { "type": "noul", "instructions": "Does the user threaten to cancel or express high churn risk?" } } result = router.predict(state, questions) print("Відділ:", result["answers"]["department"]["choice"]) print("Ризик відтоку:", result["answers"]["churn_risk"]["noul"])
Multilingwalizm: Router automatycznie wykrywa język tekstu (w tym ukraiński) i kieruje nieangielskie zapytania do checkpointu laya-multilingual, zapewniając wysokiej jakości klasyfikację w ponad 45 językach bez ręcznego przełączania wag.
Otwórz repozytorium na Hugging Face: convaiinnovations/laya →
11.2. GLiNER2.5-Decide od Fastino: 340M klasyfikator schema-oriented
GLiNER2.5-Decide to wyspecjalizowany model z laboratorium Fastino, przeznaczony do klasyfikacji operacyjnej, filtrów bezpieczeństwa i routingu zadań bez konieczności pisania promptów lub parsowania tokenów wyjściowych.
Model oparty na architekturze DeBERTa-v3-large (340M parametrów) przewyższa komercyjny JevK5 na benchmarku fast-decisions (60.2% precyzji vs 57.6% u Jev).
- Dynamiczny zestaw etykiet: lista kategorii przekazywana bezpośrednio w wywołaniu funkcji podczas runtime bez re-treningu (Zero-Shot).
- Wsparcie Multi-Label: zdolność do zwracania kilku etykiet jednocześnie (np. określenie kilku aspektów opinii czy problemów klienta) według progu
cls_threshold. - Etykiety z opisami (Label Descriptions): jeśli nazwa etykiety jest niejednoznaczna, można jej przekazać rozwinięty opis — model uwzględnia go przy podejmowaniu decyzji.
- Skale porządkowe i QA: wspiera numeryczne poziomy pilności (np. od
"0"do"5"), ocenę tonalności i pytania binarne (yes/no) dla przekazanego fragmentu tekstu. - Minimalne wymagania sprzętowe: 340M parametrów pozwala modelowi działać z opóźnieniem rzędu milisekund nawet na zwykłym procesorze (CPU).
Otwórz repozytorium na Hugging Face: fastino/GLiNER2.5-Decide →
11.3. CLM-v0.1-8B od Contrastive-LM: kontrastywny scoring akcji na bazie Qwen3
CLM-v0.1-8B (Contrastive Language Model) to opracowanie badaczy ze Stanford i NVIDIA (wrzesień 2026), stworzone do błyskawicznego wyboru akcji wewnątrz potoków agentowych (Computer Use, Tool Calling i weryfikacja kroków).
Zamiast powolnej, krokowej generacji tekstu, model działa według zasady kontrastywnej: projektuje bieżący stan (state) i listę możliwych akcji lub wywołań narzędzi do wspólnej przestrzeni wektorowej, a następnie rankuje je według podobieństwa kosinusowego.
- Stack i architektura: zamrożony encoder Qwen3-8B w połączeniu z lekkimi, trenowanymi głowicami projekcyjnymi kontrastywnymi (~20M parametrów).
- Przyspieszenie agentów: zapewnia do 9 razy mniejsze opóźnienie (latency) w porównaniu z generatywnymi LLM podczas wyboru potrzebnego narzędzia z dużej listy funkcji.
- Action Caching (Kaszowanie akcji): ponieważ stan i akcje są kodowane rozdzielnie, wektorowe embeddingi statycznych narzędzi lub funkcji systemowych można obliczyć raz i przechować w pamięci RAM.
- Wsparcie sprzętu lokalnego: otwarte wagi pod licencją Apache 2.0 oraz oficjalne optymalizacje dla Apple MLX pozwalają wdrażać model na stacjach roboczych i Mac z unified memory.
Otwórz repozytorium na Hugging Face: Contrastive-LM/CLM-v0.1-8B →
11.4. Tabela zbiorcza: Jev kontra otwarte alternatywy System 1
| Model | Deweloper / Organizacja | Architektura i rozmiar | Opóźnienie (P50) | Główny fokus i funkcje | Kompatybilność Drop-in z Jev | Licencja |
|---|---|---|---|---|---|---|
| TypeSafe Jev 1.13 | TypeSafe AI | Własna architektura proprietary | ~90–120 ms | Chmurowy model System One, 3 prymitywy, kalibrowany confidence | Oficjalne API | Komercyjna ($0.042/1M) |
| Laya | Convai Innovations | ModernBERT-large (421M) / mmBERT (322M) | ~33 ms (GPU) | 1-do-1 wsparcie Choice/Score/Noul, 100+ języków, kalibracja RLCD | Tak (laya-serve) | Apache 2.0 (Open Source) |
| GLiNER2.5-Decide | Fastino AI | DeBERTa-v3-large (340M) | ~15–40 ms | Klasyfikacja multi-label, opisy etykiet, doskonała praca na CPU | Nie (własny SDK gliner2) | Apache 2.0 (Open Source) |
| CLM-v0.1-8B | Contrastive-LM (Stanford / NVIDIA) | Frozen Qwen3-8B + Heads (~8B) | ~50–80 ms | Kontrastywny scoring akcji agentów, Action Caching, Apple MLX | Nie (kontrastywny router) | Apache 2.0 (Open Source) |
11.5. Jak wybrać lokalny model pod swój stack
Praktyczna reguła wyboru lokalnego silnika System 1:
- Wybierz Layę (
convaiinnovations/laya), jeśli już zaprojektowałeś potok pod prymitywy TypeSafe Jev (choice,score,noul), potrzebujesz obróbki multilingwalnej (w tym tekstów ukraińskich) lub chcesz przełączyć istniejący production na własny serwer bez przepisania kodu dziękilaya-serve. - Wybierz GLiNER2.5-Decide (
fastino/GLiNER2.5-Decide), jeśli Twoje zadanie polega na szybkiej klasyfikacji wiadomości, wsparciu kategorii multi-label (kilka tagów jednocześnie), pracy ze złożonymi etykietami opisowymi lub jeśli trzeba wdrożyć serwis na serwerach o ograniczonych zasobach bez dedykowanych GPU. - Wybierz CLM-v0.1-8B (
Contrastive-LM/CLM-v0.1-8B), jeśli budujesz autonomicznego agenta AI z bogatym zestawem narzędzi (MCP, Tool Calling) i szukasz maksymalnej szybkości weryfikacji akcji oraz ochrony przed błędami poprzez kaszowanie embeddingów narzędzi.