L'industrie de l'intelligence artificielle a longtemps progressé par l'augmentation de la taille des modèles génératifs. Nous avons pris l'habitude d'utiliser de grands modèles de langage (LLM) de niveau GPT-6.1 Sol, Claude Opus 5.5, Claude Fable ou Gemini 3.8 Flash pour toutes les tâches : de la rédaction d'essais à l'analyse des statuts de commandes. Cependant, lorsqu'il s'agit de construire des logiciels fiables, la génération de texte devient un goulot d'étranglement : les modèles passent des secondes à dérouler les tokens étape par étape, hallucinent du JSON invalide, exigent des expressions régulières interminables et coûtent trop cher pour une architecture microservices.
Jev, issu du laboratoire TypeSafe AI, est le premier modèle au monde d'une nouvelle classe connue sous le nom de System One AI. Il ne génère absolument aucun texte. Jev est conçu exclusivement pour des décisions instantanées, typées et structurelles au sein des systèmes logiciels : classification, routage, évaluation sur barème, vérification d'hypothèses et pare-feu pour agents, avec une latence d'environ 100 ms et un coût de 0,042 $ par million de tokens.
Dans ce guide, nous décortiquerons la technologie Jev dans ses moindres détails en tant que praticiens : la différence fondamentale entre System One et System Two, les trois primitives clés, la mathématique de la confiance calibrée, les patterns architecturaux, les pipelines prêts à l'emploi en TypeScript et Python, ainsi que l'étude de 10 cas d'usage réels révolutionnaires accompagnés de factures de coûts et de démonstrations vidéo.
Boîte à outils pratique de Yuriy (@yuriisams) :
Pour utiliser Jev concrètement dans des CLI IA terminaux, téléchargez l'archive auteur de la version 0.1.2 incluant un hook prêt à l'emploi pour le routage automatique des modèles et la sélection dynamique de skills (compatible avec Claude Code, Codex, Antigravity) :
Télécharger l'archive complète jev_0.1.2.zip (33 Ko) →
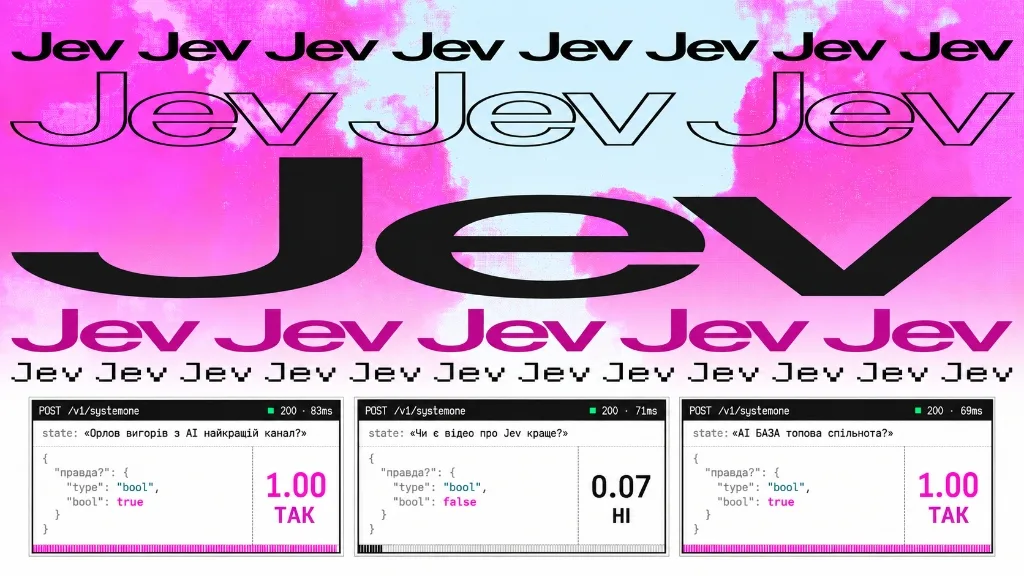 Démonstration de la vitesse de TypeSafe Jev : vérification instantanée des affirmations avec une latence de 69–83 ms et une confiance calibrée
1. Le changement de paradigme : System One contre LLM classiques (System Two)
Le nom de la concept provient de la psychologie cognitive et des travaux fondamentaux du prix Nobel Daniel Kahneman, « Thinking, Fast and Slow ».
Kahneman divise la pensée humaine en deux systèmes :
- Système 1 (System One) : Réaction rapide, intuitive, automatique, quasi-instantanée face aux motifs familiers (par exemple, identifier l'expression faciale d'un interlocuteur, détecter un danger sur la route, distinguer le spam d'un message important en une fraction de seconde).
- Système 2 (System Two) : Travail lent, conscient, analytique nécessitant une concentration soutenue et des étapes séquentielles (résoudre une équation, rédiger un document d'architecture, prouver logiquement un théorème).
Pourquoi les LLM génératifs cassent les pipelines logiciels
La plupart des décisions dans les services backend ne sont pas des essais philosophiques, mais des choix discrets concrets :
- « Cette transaction est-elle suspecte ? » (
trueoufalse). - « Vers quel service diriger ce ticket : facturation, support technique ou ventes ? » (
billing | tech | sales). - « À quel point le client est-il irrité sur une échelle de 1 à 5 ? » (
1..5).
Lorsqu'un ingénieur force un modèle génératif lourd comme GPT-6.1 Sol, Claude Opus 5.5 ou Claude Fable à répondre à ces questions, une inadéquation fondamentale de la nature de l'outil apparaît :
- Latence autorégressive : Le modèle doit générer les tokens séquentiellement, l'un après l'autre. Même une réponse courte prend 1,5 à 3 secondes en raison des attentes réseau et des quantiles de génération.
- Fragilité du Mode JSON : Les modèles génératifs ajoutent souvent des commentaires, omettent des guillemets ou enveloppent la réponse dans
```json ... ```, obligeant les développeurs à écrire des assainisseurs complexes et des mécanismes de retry. - Inefficacité économique : Vous payez le plein tarif des tokens de sortie (output tokens), qui coûtent 3 à 5 fois plus cher que les tokens d'entrée dans les API commerciales.
- Dégradation de l'attention (Context Rot) : Si vous posez plusieurs questions consécutives à un modèle dans un même chat, le contexte croissant dilue l'attention et augmente la probabilité d'erreur.
Principe de Jev : Jev ne possède pas de mécanisme de génération de texte autorégressive pour l'utilisateur. Le modèle lit l'état d'entrée (state), le passe à travers un transformer et calcule des distributions de probabilités normalisées sur des catégories prédéfinies en un seul passage avant. Le résultat est immédiatement renvoyé sous forme de structure de données strictement typée.
2. Économie, vitesse et benchmarks : 0,042 $ pour 1M de tokens et 100 ms
L'économie de Jev change les règles du jeu pour les services à forte charge. Au lieu de payer pour chaque mot de sortie, les développeurs paient uniquement pour les tokens d'entrée.
Tableau comparatif des coûts et caractéristiques
| Caractéristique | TypeSafe Jev 1.13 | OpenAI GPT-6.1 Sol | Anthropic Claude Opus 5.5 | Google Gemini 3.8 Flash |
|---|---|---|---|---|
| Classe d'architecture | System One (Décision) | System Two (Génératif) | System Two (Génératif) | System Two (Génératif) |
| Coût des tokens d'entrée (1M) | 0,042 $ | 3,00 $ | 5,00 $ | 0,10 $ |
| Coût des tokens de sortie (1M) | 0,00 $ (Gratuit !) | 12,00 $ | 25,00 $ | 0,40 $ |
| Latence typique (P50) | ~90–120 ms | 1200–2400 ms | 1400–2800 ms | 400–700 ms |
| Limites de débit | 100K tok/s, 40 RPS | Dépend du Tier | Dépend du Tier | Dépend du Tier |
| Fenêtre de contexte requête | 64 000 tokens | 256 000 tokens | 500 000 tokens | 2 000 000 tokens |
| Besoin de parsing des réponses | Aucun (Types natifs) | JSON.parse / Regex | JSON.parse / Regex | JSON.parse / Regex |
Tokens de sortie gratuits : Puisque Jev ne génère pas de texte libre, TypeSafe facture uniquement le contexte d'entrée (state + question). Un milliard de tokens traités coûte seulement 42 $. Pour comparaison, le même volume sur GPT-6.1 Sol ou Claude Opus 5.5 coûterait au minimum 3 000 $ – 7 500 $.
Benchmark réel : MotherDuck (Classification de texte SQL)
L'équipe de la base de données cloud analytique MotherDuck a intégré la fonction prompt_jev() directement dans le dialecte SQL pour la classification d'enregistrements textuels à l'échelle industrielle.
Résultats du test sur un tableau de 100 000 lignes :
- Frontier-LLM classique : temps d'exécution — 32 minutes, coût de calcul — 37,00 $.
- TypeSafe Jev : temps d'exécution — 40 secondes, coût de calcul — 0,50 $.
- Bilan : Jev a exécuté la tâche 48 fois plus vite et 74 fois moins cher, démontrant une parité totale en qualité de classification.
3. Anatomie de la requête : Structured State et adressage précis via Dot-Path
Une requête vers Jev se compose de deux composants fondamentaux :
state(état) : Le contexte de la tâche sous forme de texte simple, de chaîne ou de document JSON imbriqué (journal d'événements, transaction, profil utilisateur, code, contenu de page).questions(jeu de questions) : Un dictionnaire de questions que le modèle doit évaluer simultanément sur l'état transmis.
Principe d'isolation du contexte et prévention du Context Rot
L'erreur classique lors de l'utilisation de grands modèles est d'envoyer tout l'historique des dialogues précédents et les prompts système. Dans Jev, une règle stricte d'hygiène du contexte s'applique : transmettez dans state uniquement les données nécessaires à la prise de décision spécifique. Le modèle reçoit l'état une seule fois et calcule toutes les questions en parallèle.
Adressage précis via Dot-and-Index Paths
Lorsque votre state est un objet JSON structuré complexe, vous pouvez faire référence à des champs spécifiques et des éléments de tableau directement dans le texte de la question en utilisant des accents graves (backticks) :
Le modèle Jev est spécifiquement optimisé pour naviguer dans l'arbre JSON. Lorsqu'il voit `transaction.amount_usd`, sa couche d'attention se focalise précisément sur la clé indiquée, éliminant l'ambiguïté et prévenant les interprétations erronées.
4. Les trois primitives IA : analyse détaillée de Choice, Score et Noul
TypeSafe a construit son système autour de trois primitives minimales et complémentaires. Chacune est destinée à un type mathématique spécifique de décision. Sous chaque sous-section ci-dessous, un stand interactif distinct est intégré, où vous pouvez choisir un prompt prêt à l'emploi et tester le fonctionnement de la primitive en action.
4.1. Primitive Choice : sélection dans une liste discrète de catégories
Choice s'applique lorsque la réponse doit être une catégorie issue d'une liste fixe et non ordonnée d'options.
Ce que Jev retourne pour Choice :
choice: La clé de la catégorie choisie (par exemple,"technical").probabilities: La distribution complète des probabilités sur toutes les options :{"billing": 0.04, "technical": 0.92, "sales": 0.02, "other": 0.02}.confidence: Une valeur numérique entre0.0et1.0, mesurant la netteté de la domination du leader sur les autres options.
Règle d'or de Choice : Ajoutez toujours une catégorie other ou none_of_the_above. Si les données d'entrée ne correspondent à aucune des cibles, le modèle ne sera pas forcé de gonfler artificiellement la probabilité d'une catégorie inappropriée, mais sélectionnera other ou signalera un faible niveau de confidence.
4.2. Primitive Score : évaluation sur une échelle ordinale ou un barème
Score est destiné à évaluer des propriétés situées sur un spectre continu ou ordinal : criticité d'un bug, niveau de stress du client, qualité du CV d'un candidat, complexité du code.
Vous définissez un tableau trié de critères textuels (niveaux) :
Ce que Jev retourne pour Score :
score: Une valeur numérique comprise entre0etN-1. Important : la valeur peut être fractionnaire (par exemple,2.37) si la situation se situe entre le deuxième et le troisième niveau du barème !probabilities: La distribution des probabilités sur chaque niveau de l'échelle.confidence: Le degré de certitude de l'évaluation.
4.3. Primitive Noul : probabilité calibrée de vérité d'une affirmation
Le terme Noul vient de l'idée de jugement binaire. C'est une question à laquelle on peut répondre par « Oui » ou « Non ». Au lieu d'une simple valeur booléenne, Jev retourne une probabilité calibrée que l'affirmation soit vraie.
Ce que Jev retourne pour Noul :
noul: Un nombre flottant entre0.0et1.0.- Une valeur de
0.98signifie un « Oui » confiant. - Une valeur de
0.02signifie un « Non » confiant. - Une valeur de
0.50indique une incertitude totale du modèle.
- Une valeur de
Nouln'a pas de champconfidenceséparé, car la valeurnoulelle-même est l'estimation mathématique de la probabilité.
4.4. Mise en lot parallèle (Parallel Batching)
Les trois types de primitives peuvent être combinés dans une seule requête en n'importe quelle quantité.
Dans le cookbook officiel de TypeSafe, une expérimentation avec un lot de 13 questions sur un texte RGPD a démontré que regrouper toutes les vérifications en une seule requête était 12,2 fois moins cher et 10,0 fois plus rapide que l'envoi de 13 requêtes individuelles, avec une identité parfaite des résultats obtenus.
5. Confiance contre Probabilité : Mathématiques et Routage à seuil de confiance (Confidence-Gated Routing)
L'un des principaux problèmes des LLM classiques est leur tendance aux hallucinations et à l'excès de confiance. Lorsqu'un modèle génératif (même de niveau GPT-6.1 Sol ou Claude Opus 5.5) rencontre un contexte limite ou insuffisamment défini, il tente d'inventer un texte plausible convaincant. Jev a été conçu à l'aide d'algorithmes d'apprentissage par renforcement basés sur des décisions calibrées (RLCD), permettant au modèle de signaler honnêtement : « Je ne suis pas sûr ».
Différence mathématique
- Probabilité (
probability) : Répond à la question « Quelle est la chance que l'option X soit correcte ? ». C'est une mesure de l'incertitude aléatoire au sein des options définies. - Confiance (
confidence) : Répond à la question « À quel point une option domine-t-elle clairement toutes les autres ? ». C'est une mesure de la certitude épistémique du modèle dans son choix.
Pour $K$ options dans une question Choice, la formule de calcul normalisé de la confiance chez TypeSafe est :
$$\text{Confidence} = \max\left(0, \min\left(1, \frac{K \cdot p_{\max} - 1}{K - 1}\right)\right)$$
où :
- $K$ — le nombre total de catégories disponibles.
- $p_{\max}$ — la probabilité la plus élevée parmi toutes les catégories.
Exemple d'interprétation pour 3 options ($K = 3$) :
-
Si les probabilités sont réparties comme
[0.90, 0.06, 0.04], alors $p_{\max} = 0.90$.$\text{Confidence} = \frac{3 \cdot 0.90 - 1}{2} = \frac{1.7}{2} = 0.85$ (Confiance élevée).
-
Si les probabilités sont uniformes
[0.34, 0.33, 0.33], alors $p_{\max} = 0.34$.$\text{Confidence} \approx \frac{3 \cdot 0.34 - 1}{2} = \frac{0.02}{2} = 0.01$ (Le modèle n'a pas de leader, incertitude totale).
Pattern de routage à trois niveaux (Confidence-Gated Routing)
Grâce à l'indicateur confidence, les ingénieurs peuvent construire des systèmes d'automatisation fiables avec trois boucles de sécurité :
6. Patterns architecturaux de niveau production (Production Patterns)
L'expérience de centaines de projets sur Jev a permis de cristalliser cinq patterns architecturaux clés pour la conception de systèmes intelligents.
6.1. Ventilation spéculative (Speculative Fan-Out)
Dans le code classique, les développeurs effectuent d'abord une vérification conditionnelle, puis appellent la fonction suivante. Dans le monde de Jev, les questions sont calculées en parallèle, et l'ajout de nouvelles questions modifie à peine le temps de réponse.
Pattern : Envoyez dès la première requête non seulement les questions obligatoires, mais aussi les questions hypothétiques dont les réponses ne seront nécessaires que dans certaines branches du code.
6.2. Scoring composite (Composite Scoring)
Au lieu de demander au modèle d'évaluer abstraitement un prospect « de 1 à 100 », décomposez l'évaluation en facteurs atomiques et objectifs. Agrégez-les en un score final via une formule mathématique déterministe dans votre code :
$$\text{LeadScore} = 0.40 \cdot \text{BudgetConfirmed} + 0.35 \cdot \text{DecisionMakerRole} + 0.25 \cdot \text{Urgency}$$
Si les priorités commerciales de l'entreprise changent, vous n'avez pas besoin de réécrire un long prompt système ni de retester les hallucinations — vous modifiez simplement les coefficients numériques 0.40, 0.35, 0.25 dans votre code TypeScript.
6.3. Cascade d'extraction structurée (SDE Cascade)
Lorsque vous devez extraire des données complexes d'un texte non structuré, construisez un pipeline à deux étages :
- Étape 1 : Un parser rapide ou des expressions régulières trouvent les entités potentielles (dates, montants, liens, emails).
- Étape 2 (Jev) : Une série de questions
ChoiceouNoulvérifie et sélectionne parmi les candidats ceux qui correspondent au contexte. - Étape 3 (Uniquement pour 2–3 % des collisions) : Si Jev retourne
confidence < 0.5, la requête est transmise à un modèle lourd de raisonnement profond (GPT-6.1 Sol ou Claude Opus 5.5).
Cette approche réduit la facture globale des LLM cloud de 90 à 95 %.
6.4. Pare-feu d'appel d'outils (Tool-Call Firewall)
Les agents IA ayant accès à la console ou à l'appel d'outils (MCP, bash, SQL) présentent un risque énorme de suppression irréversible de données ou d'exécution de code malveillant.
À l'aide de Jev, un pare-feu rapide est créé : chaque commande générée par l'agent est envoyée à Jev avec 5 à 7 questions de sécurité avant exécution :
- « Cette commande modifie-t-elle des fichiers système ? »
- « Des variables d'environnement sensibles sont-elles transmises à des hôtes externes ? »
- « L'action correspond-elle à la demande initiale de l'utilisateur ? »
Une latence de 100 ms est imperceptible pour l'agent, mais protège solidement le système contre les opérations dangereuses.
7. Coding pratique : pipelines prêts à l'emploi en TypeScript et Python
Ci-dessous sont fournis des exemples prêts pour la production de construction d'un service de traitement des demandes entrantes clients et de scoring de risque financier à l'aide des SDK officiels TypeSafe pour TypeScript et Python.
7.1. Pipelines industriels : traitement des demandes clients
typescriptimport { TypeSafeClient, choice, score, noul } from "@typesafe-ai/sdk"; // 1. Ініціалізація клієнта (бере TYPESAFE_API_KEY зі змінних середовища) const client = new TypeSafeClient(); interface SupportState { ticketId: string; userEmail: string; accountAgeDays: number; messageText: string; attachedLogs?: string; } export async function processCustomerMessage(ticket: SupportState) { try { // 2. Виклик System One з паралельними питаннями const response = await client.systemOne({ state: { ticket_id: ticket.ticketId, user_tier: ticket.accountAgeDays > 365 ? "vip" : "standard", content: ticket.messageText, logs: ticket.attachedLogs ?? "Немає логів" }, questions: { // Категоризація запиту (Choice) topic: choice("Яка основна тема звернення користувача?", { billing: "Проблеми з оплатою, картками, підпискою, запит на повернення грошей", bug_report: "Повідомлення про збій у додатку, помилку в інтерфейсі або API", feature_request: "Побажання щодо покращення функціоналу, нові інструменти", account: "Проблеми зі входом, зміна пошти або скидання пароля", other: "Питання, які не підпадають під жодну з попередніх категорій" }), // Оцінка за шкалою роздратування (Score) frustration_level: score("Наскільки користувач роздратований у `content`?", [ "Спокійний: діловий, нейтральний тон, виклад фактів", "Стурбований: відчувається легке невдоволення або нетерпіння", "Розлючений: агресія, погрози піти до конкурентів, скарги", "Екстремальний: ненормативна лексика, caps lock, вимога негайного дзвінка керівництва" ]), // Перевірка на терміновість (Noul) is_urgent: noul("Чи вказує користувач у `content`, що його продакшен зупинений або проблема критична для бізнесу?"), // Перевірка на наявність витоку секретів у тексті (Noul) contains_leaked_secrets: noul("Чи містить `content` або `logs` приватні API-ключі, токени доступу чи паролі?") } }); const { topic, frustration_level, is_urgent, contains_leaked_secrets } = response.answers; // 3. Детермінована логіка маршрутизації console.log(`[Ticket ${ticket.ticketId}] Тема: ${topic.choice} (Впевненість: ${topic.confidence.toFixed(2)})`); console.log(`[Ticket ${ticket.ticketId}] Рівень стресу: ${frustration_level.score.toFixed(2)}/3.00`); // Безпековий контур if (contains_leaked_secrets.noul > 0.85) { console.warn(`[SECURITY ALERT] Виявлено можливий витік ключів у тікеті ${ticket.ticketId}. Автоматичне маскування!`); } // Маршрутизація на основі впевненості if (topic.confidence < 0.50) { return { status: "manual_triage", reason: "Model uncertain about topic" }; } if (is_urgent.noul > 0.80 || frustration_level.score > 2.0) { return { status: "escalated_p1", department: topic.choice, priority: "CRITICAL", confidence: topic.confidence }; } return { status: "routed", department: topic.choice, priority: "NORMAL", confidence: topic.confidence }; } catch (error) { console.error("Помилка під час виклику Jev API:", error); throw error; } }
8. Analyse des 10 meilleurs cas mondiaux avec démonstrations vidéo (Receipts)
La communauté d'ingénieurs sur les plateformes shipwithjev.com, jevbest.com et jevable.com a démontré des dizaines d'applications révolutionnaires de Jev. Ci-dessous est présenté l'analyse détaillée de 10 cas mondiaux leaders : à gauche se trouve un lecteur interactif de la démonstration réelle ou de la télémétrie, et à droite une analyse structurée du problème, de la solution architecturale basée sur Jev et de la facture confirmée de vitesse et de coût.
8.1. Browser Use + Jev : Agent autonome de recherche de billets d'avion
8.2. Toolgate : Pare-feu d'appel d'outils MCP et Claude Code
8.3. Astra + Jev dans Minecraft : Agent temps réel System One + Two
8.4. Jev Driver : Conduite autonome de voiture dans le navigateur
8.5. 2048Jev : Jev joue au 2048 en temps réel
8.6. Semantic Jev : Requêtes en langage naturel via SQL
8.7. MotherDuck : Classification prompt_jev() directement dans SQL
8.8. Jev Swap : Recherche des appels LLM à remplacer par Jev
8.9. ElevenLabs : Détection de fraudeurs téléphoniques en temps réel
8.10. Softlint : Linter IA dans le CI pour les règles sémantiques de code
9. Intégration dans les pipelines agentiques : Claude Code, Codex et MCP Toolgate
Les agents de codage autonomes modernes (Claude Code, OpenAI Codex, Antigravity, Cursor) font face à trois goulots d'étranglement critiques : le gonflement du contexte (Context Bloat) dû à des dizaines d'outils connectés, l'utilisation irrationnelle de modèles phares ultra-chers pour des tâches triviales et le risque d'actions destructrices incontrôlées dans le terminal.
Jev System One agit comme une couche réflexe ultra-rapide (L0/L1) du système agentique : il prend des décisions discrètes en ~80–90 ms pour un coût inférieur à 0,0003 $, optimisant l'ensemble du cycle de travail de l'agent.
9.1. Classement dynamique des modèles pour différents types de tâches (Model Tier Routing)
Dans les pipelines agentiques classiques, les développeurs fixent soit un seul modèle (par exemple, Claude 3.7 Sonnet ou GPT-4.5) pour toutes les sous-tâches, soit appellent un LLM lourd pour analyser la requête, ajoutant 2 à 4 secondes de latence et des coûts superflus à chaque étape.
Jev classe l'intention et la complexité de la tâche en ~85 ms, dirigeant la requête vers le tier de modèles approprié :
- Fast Tier (micro-tâches rapides) : Formatage de code, écriture de tests unitaires simples, génération de validateurs et de documentation. Dirigé vers Gemini 2.5 Flash ou GPT-4o-mini (0,05–0,15 $ pour 1M de tokens).
- Balanced Tier (codage standard) : Implémentation de fonctionnalités, refactoring de fonctions, intégration d'API et correction de bugs de complexité moyenne. Dirigé vers Claude 3.5 Sonnet ou DeepSeek V3 (3,00 $ pour 1M de tokens).
- Deep Reasoning Tier (architecture critique) : Analyse approfondie des race conditions, conception de bases de données, audit cryptographique complet. Dirigé vers Claude 3.7 Sonnet Thinking ou OpenAI o3-mini (12,00–15,00 $ pour 1M de tokens).
Résultat du routage via Jev : Les économies sur les coûts API de l'agent vont de 65 % à 82 %, et la première réponse aux petites tâches apparaît 4 fois plus vite qu'avec l'utilisation d'un seul modèle lourd.
9.2. Classement et chargement des skills à la demande (Dynamic Skill Selection)
Un développeur moderne peut avoir dans son environnement 30 à 80 skills agentiques (skills/*), plugins et outils. Si vous transmettez les spécifications complètes et les instructions de tous les skills dans le prompt système de l'agent :
- Entre 15 000 et 35 000 tokens sont gaspillés à chaque itération du dialogue.
- Le modèle commence à se mélanger dans les outils similaires (Hallucination/Surcharge d'outils).
- La vitesse de première réaction de l'agent chute à 5–10 secondes.
Jev implémente l'architecture On-Demand Skill Ingestion. L'agent garde en mémoire uniquement de légères descriptions d'une ligne des skills disponibles, et Jev, à chaque étape en ~80 ms, les classe et sélectionne le top 1–2 les plus nécessaires :
Pourquoi cela fonctionne plus vite : Au lieu de transmettre 30k tokens, l'agent envoie à Jev uniquement la requête utilisateur (~200 tokens). Ayant reçu le nom du skill requis, l'agent récupère le fichier SKILL.md correspondant juste avant son exécution. Cela maintient la fenêtre de contexte propre pour le code du projet.
9.3. Pare-feu de sécurité toolgate pour MCP et le terminal
Le projet open-source toolgate ajoute une couche de vérification intermédiaire (middleware) pour tout appel au protocole Model Context Protocol (MCP). Chaque fois qu'un agent autonome initie une commande terminal (bash, npm run, git reset) ou une réécriture de fichiers, Jev calcule en parallèle 7 probabilités de risque destructif Noul :
- Suppression dangereuse de fichiers : Probabilité d'actions destructives (
rm -rf, effacement de répertoires hors dépôt). - Fuite de données sensibles : Tentative d'affichage de variables d'environnement (
.env,AWS_SECRET_ACCESS_KEY, clés SSH privées). - Escalade de privilèges : Utilisation de
sudo, modification de fichiers système dans/etc/ou~/.ssh/. - Destruction de l'historique Git : Appels
git push --forceou réinitialisation de branches sans confirmation. - Anomalies réseau : Ouverture non autorisée de sockets ou envoi de données vers des IP tierces.
- Dérive du périmètre (Scope Drift) : Tentative de l'agent de modifier des fichiers sans rapport avec la tâche assignée.
- Coût financier de l'opération : Lancement de scripts cloud lourds ou déploiement sans accord de l'utilisateur.
Si l'indice de risque cumulé dépasse le seuil 0.85, l'action est bloquée instantanément, et l'opérateur reçoit une notification avec une description précise de la menace.
9.4. Matrice comparative : Agent classique contre Agent avec Jev System One
| Paramètre opérationnel | Approche classique (Full Context / Heavy LLM) | Agent avec intégration Jev System One | Avantage pour le projet |
|---|---|---|---|
| Choix du modèle par tâche | Modèle phare fixe ou routeur LLM lourd (2–4 s, ~0,02 $) | Routeur Choice Jev System One (~85 ms, 0,0003 $) | -98 % de latence, -98,5 % de coût |
| Sélection et chargement des skills | Tous les 40–80 skills dans le prompt (25 000+ tokens par tour) | Classement en 80 ms et chargement de 1–2 skills on-demand | Économie jusqu'à 90 % du contexte |
| Contrôle de sécurité des outils | Règles regex simples ou absence totale de protection | 7 vérifications Noul parallèles avant chaque tool call | Protection contre les actions non autorisées |
| Vitesse de démarrage de l'agent | 4–9 secondes d'attente du premier token | 600–900 ms avant le début de l'exécution de l'étape | Démarrage 5–7 fois plus rapide |
| Coût moyen de 100 étapes de l'agent | ~4,50 $ – 8,00 $ | ~0,85 $ – 1,40 $ | Économies de 75–85 % |
9.5. Installation du skill officiel pour les agents
TypeSafe fournit des plugins d'intégration et des skills prêts à l'emploi pour les environnements de développement populaires :
bashclaude plugin marketplace add typesafe-ai/skills claude plugin install typesafe@typesafe-ai
Le skill apprend à l'agent trois règles critiques :
- Toujours grouper les vérifications liées dans un seul appel parallèle
client.systemOne. - Utiliser le pattern Speculative Fan-Out au lieu d'interrogations séquentielles.
- Conserver les questions et les constantes de seuil dans un fichier de configuration séparé pour un audit humain transparent.
9.6. Boîte à outils prête Jev 0.1.2 de Yuriy (@yuriisams)
Le développeur et praticien Yuriy (@yuriisams) a mis à jour l'automatisation vers la version Jev 0.1.2 — c'est désormais un système monolithique unique ~/.jev/ (routeur de modèles + sélecteur dynamique de skills), qui supporte immédiatement les trois principaux environnements agentiques : Claude Code, Codex et Antigravity (agy).
Par défaut, les outils fonctionnent silencieusement : ils filtrent les notifications système de service (<task-notification, [SYSTEM NOTIFICATION]), et si le service Jev est indisponible ou si la confiance est inférieure au seuil, l'agent continue discrètement l'exécution normale sans erreurs ni retards.
Fichier dans jev_0.1.2/ | Destination | Fonctionnement interne |
|---|---|---|
jev.py | Point d'entrée principal | Parse la requête, filtre le bruit de service, lance la file : d'abord router.py, puis picker.py. |
router.py | Routeur d'efforts | Évalue la complexité (tiny, everyday, large, hardest) et le coefficient standalone du message. |
picker.py | Sélecteur de skills | Sélection en deux étapes : vérifie d'abord les skills locaux du projet, puis le menu global mis en cache. |
manifest.py | Cache du menu des skills | Scanne les builtins, les skills personnels ~/.claude/skills, les plugins du marketplace et le projet actuel. |
scan.py | Audit de sécurité | Vérifie les skills pour des patterns dangereux (reverse shell, `curl |
test_jev.py | Suite de tests | 23 tests autonomes pour une validation rapide sur machine sans consommation de tokens ni réseau. |
rules.md | Règles système | Directives prêtes à insérer dans CLAUDE.md ou AGENTS.md pour l'interaction avec les tags Jev. |
Installation étape par étape sur la machine de travail
bash# Створюємо теку ~/.jev і розпаковуємо авторський архів v0.1.2 mkdir -p ~/.jev curl -L -o /tmp/jev_0.1.2.zip https://gotburnout.io/downloads/jev_0.1.2.zip unzip -q /tmp/jev_0.1.2.zip -d /tmp/jev_unpacked cp -r /tmp/jev_unpacked/jev_0.1.2/* ~/.jev/ rm -rf /tmp/jev_unpacked /tmp/jev_0.1.2.zip # Налаштовуємо оточення та API ключ TypeSafe cp ~/.jev/.env.example ~/.jev/.env # Відкрийте ~/.jev/.env і додайте дійсний ключ: TYPESAFE_API_KEY=ваш_ключ chmod 600 ~/.jev/.env
Connexion des hooks par type de CLI
Choisissez la configuration selon l'outil de travail :
json{ "hooks": { "UserPromptSubmit": [ { "type": "command", "command": "python3 ~/.jev/jev.py --cli claude", "timeout": 10, "statusMessage": "Jev sizing up your message & skills..." } ] } }
Gestion et commandes rapides dans le terminal
Après le redémarrage de l'agent, vous pouvez contrôler le comportement de Jev directement via les commandes de chat :
-
Gestion du routeur d'efforts :
jev router on/jev router off/jev router status. -
Gestion de la sélection de skills :
jev skills on/jev skills off/jev skills status. -
État général du sous-système :
jev status. -
Changement de moteur (cloud ou Laya local) :
jev engine jev/jev engine laya/jev engine status. -
Audit de sécurité de tous les skills installés :
bashpython3 ~/.jev/scan.py
Télécharger l'archive prête jev_0.1.2.zip de Yuriy (@yuriisams) →
10. Pièges, limitations de Jev 1.13 et checklist de mise en œuvre
Jev est un outil puissant, mais ce n'est pas une solution universelle miracle. Comprendre ses limites permet d'éviter des erreurs critiques lors de la phase de conception.
Asperités connues (Jagged Edges) de la version actuelle jev-1.13.0
- Limites de contexte : La taille maximale de la requête est de 64k tokens, mais l'état (
state) plus la question la plus longue ne doivent pas dépasser 32k tokens. En approchant de la limite de 32k, la précision du modèle commence à diminuer progressivement. - Texte uniquement : Jev ne supporte pas la réception directe d'images, de vidéos ou d'audio. Toutes les données multimédias doivent être transcrites (par exemple, via Whisper) ou converties en texte structuré avant transmission dans
state. - Spécificité linguistique : Le modèle a été entraîné principalement sur un corpus anglophone. Il est capable de traiter l'ukrainien, le polonais ou l'espagnol, mais la précision la plus élevée est atteinte avec le schéma suivant :
Astuce
Conseil pour les projets localisés : Transmettez le texte local de l'utilisateur (par exemple, en ukrainien) dans le champ
state, mais rédigez les instructions (instructions) et les critères (criteria) des questions en anglais. Jev corrèle parfaitement les règles anglophones avec le contexte ukrainophone.
Checklist de préparation au lancement en production
- Il n'y a pas de prompts système superflus dans le corps de l'article et du service ; seul un
statepur est transmis. - Toutes les questions Choice contiennent une catégorie par défaut (
otherounone_of_the_above). - Les questions apparentées sont groupées dans un seul appel parallèle
client.systemOne. - Le routage à trois niveaux basé sur
confidenceest implémenté (Tier 1 / Tier 2 / Tier 3). - Les seuils de confiance sont différenciés : plus élevés pour les opérations destructives ($>0.90$) et modérés pour les opérations read-only ($>0.60$).
- Un retry automatique avec backoff exponentiel est configuré pour gérer les éventuels HTTP 429 Rate Limit.
- Les constantes de questions et les valeurs de seuil sont externalisées dans un fichier de configuration séparé.
- La taille de l'état d'entrée est vérifiée (ne dépasse pas 32k tokens par question).
- Une route de fallback vers un LLM de raisonnement classique est prévue pour une confiance anormalement basse.
- Les valeurs
response.modeletanswers.*.confidencesont journalisées pour l'analyse ultérieure de la distribution des décisions.
11. Alternatives locales Open-Weight : Laya, GLiNER2.5-Decide et CLM-8B
Bien que Jev cloud de TypeSafe offre des tarifs extrêmement accessibles (0,042 $ pour 1M de tokens), pour de nombreux systèmes d'entreprise, il est critique d'avoir un contrôle total des données (On-Premise, GDPR, HIPAA, secret bancaire) ou une dépendance nulle aux API tierces et aux latences réseau.
La communauté open-source a rapidement adopté le paradigme System One et publié des modèles de décision ouverts (Open-Weight Decision Models), pouvant être exécutés localement sur son propre serveur, GPU ou même un ordinateur portable avec Apple Silicon.
11.1. Laya de Convai Innovations : double direct open-source de Jev
Laya est le premier analogue ouvert direct de Jev, construit selon la même philosophie : un modèle de décision non-autorégressif qui ne génère jamais de texte libre, mais évalue des questions typées en un seul passage avant du transformer (~33 ms sur GPU).
Le modèle est entraîné via l'apprentissage par renforcement basé sur des règles d'évaluation strictement correctes (RLCD — Reinforcement Learning for Calibrated Decisions), garantissant un calibrage mathématiquement honnête des probabilités.
- Stack et architecture : encodeur ModernBERT-large (421M paramètres) pour l'anglais et mmBERT-base (322M paramètres) pour plus de 100 langues mondiales.
- Support des primitives : support natif de
choice,scoreetnoulavec le même format de requêtes et de réponses que TypeSafe Jev. - Contexte de documents : supporte jusqu'à 1024 tokens par défaut et jusqu'à 8192 tokens dans la version
laya-multilingual(max_len=8192). - Serveur compatible
laya-serve: contient un proxy intégré qui implémente l'endpointPOST /v1/systemone. Vous pouvez remplacer Jev cloud dans vos applications existantes simplement en changeantbaseURLenhttp://localhost:8000. - Vitesse et coût : environ 33 ms sur GPU (6 à 8 fois plus rapide qu'un appel réseau vers Jev cloud) et 0 $ de coût sous licence Apache 2.0.
pythonfrom laya import Router # Preload моделей у пам'ять для миттєвої маршрутизації (<35 мс) router = Router(preload=True) state = "Користувач скаржиться на подвійне списання коштів за підписку і вимагає повернення." questions = { "department": { "type": "choice", "instructions": "Which department should handle this request?", "criteria": { "billing": "invoices, payments, refunds", "tech_support": "bugs, outages, system errors", "other": "everything else" } }, "churn_risk": { "type": "noul", "instructions": "Does the user threaten to cancel or express high churn risk?" } } result = router.predict(state, questions) print("Відділ:", result["answers"]["department"]["choice"]) print("Ризик відтоку:", result["answers"]["churn_risk"]["noul"])
Multilinguisme : Le Router détecte automatiquement la langue du texte (notamment l'ukrainien) et dirige les requêtes non-anglaises vers le checkpoint laya-multilingual, assurant une classification qualitative dans plus de 45 langues sans commutation manuelle des poids.
Ouvrir le dépôt sur Hugging Face : convaiinnovations/laya →
11.2. GLiNER2.5-Decide de Fastino : classificateur orienté schéma de 340M
GLiNER2.5-Decide est un modèle spécialisé du laboratoire Fastino, destiné à la classification opérationnelle, aux filtres de sécurité et au routage de tâches sans nécessité d'écrire des prompts ou de parser les tokens de sortie.
Le modèle est basé sur l'architecture DeBERTa-v3-large (340M paramètres) et surpasse le JevK5 commercial sur le benchmark fast-decisions (60,2 % de précision contre 57,6 % pour Jev).
- Ensemble de labels dynamique : la liste des catégories est transmise directement dans l'appel de fonction à l'exécution sans réentraînement (Zero-Shot).
- Support Multi-Label : capable de retourner plusieurs labels simultanément (par exemple, déterminer plusieurs aspects d'un avis ou problèmes client) via un seuil
cls_threshold. - Labels avec descriptions : si le nom du label est ambigu, une description développée peut lui être associée — le modèle en tient compte lors de la prise de décision.
- Échelles ordinales et QA : supporte les niveaux numériques d'urgence (par exemple, de
"0"à"5"), l'évaluation de tonalité et les questions binaires (yes/no) sur l'extrait de texte transmis. - Exigences matérielles minimales : 340M paramètres permettent au modèle de fonctionner avec une latence de quelques millisecondes même sur un processeur standard (CPU).
Ouvrir le dépôt sur Hugging Face : fastino/GLiNER2.5-Decide →
11.3. CLM-v0.1-8B de Contrastive-LM : scoring contrastif d'actions basé sur Qwen3
CLM-v0.1-8B (Contrastive Language Model) est un développement de chercheurs de Stanford et NVIDIA (septembre 2026), créé pour la sélection éclair d'actions au sein des pipelines agentiques (Computer Use, Tool Calling et vérification d'étapes).
Au lieu d'une génération de texte lente étape par étape, le modèle fonctionne selon un principe contrastif : il projette l'état courant (state) et la liste des actions possibles ou appels d'outils dans un espace vectoriel commun, puis les classe par similarité cosinus.
- Stack et architecture : encodeur Qwen3-8B gelé combiné à des têtes de projection contrastives légères entraînées (~20M paramètres).
- Accélération des agents : assure jusqu'à 9 fois moins de latence comparé aux LLM génératifs lors de la sélection de l'outil nécessaire dans une grande liste de fonctions.
- Action Caching (Mise en cache des actions) : puisque l'état et les actions sont encodés séparément, les embeddings vectoriels des outils statiques ou des fonctions système peuvent être calculés une fois et stockés en mémoire vive.
- Support matériel local : les poids ouverts sous licence Apache 2.0 et les optimisations officielles pour Apple MLX permettent de déployer le modèle sur des stations de travail et des Mac avec mémoire unifiée.
Ouvrir le dépôt sur Hugging Face : Contrastive-LM/CLM-v0.1-8B →
11.4. Tableau récapitulatif : Jev contre alternatives System 1 ouvertes
| Modèle | Développeur / Organisation | Architecture et taille | Latence (P50) | Focus principal et fonctionnalités | Compatibilité Drop-in avec Jev | Licence |
|---|---|---|---|---|---|---|
| TypeSafe Jev 1.13 | TypeSafe AI | Architecture propriétaire | ~90–120 ms | Modèle System One cloud, 3 primitives, confidence calibrée | API officielle | Commerciale (0,042 $/1M) |
| Laya | Convai Innovations | ModernBERT-large (421M) / mmBERT (322M) | ~33 ms (GPU) | Support 1-pour-1 Choice/Score/Noul, 100+ langues, calibrage RLCD | Oui (laya-serve) | Apache 2.0 (Open Source) |
| GLiNER2.5-Decide | Fastino AI | DeBERTa-v3-large (340M) | ~15–40 ms | Classification multi-label, descriptions de labels, excellentes performances CPU | Non (SDK propre gliner2) | Apache 2.0 (Open Source) |
| CLM-v0.1-8B | Contrastive-LM (Stanford / NVIDIA) | Qwen3-8B gelé + Heads (~8B) | ~50–80 ms | Scoring contrastif d'actions d'agents, Action Caching, Apple MLX | Non (routeur contrastif) | Apache 2.0 (Open Source) |
11.5. Comment choisir le modèle local adapté à votre stack
Règle pratique de choix du moteur System 1 local :
- Choisissez Laya (
convaiinnovations/laya) si vous avez déjà conçu un pipeline pour les primitives TypeSafe Jev (choice,score,noul), si vous avez besoin d'un traitement multilingue (notamment textes ukrainophones) ou si vous souhaitez basculer votre production existante sur votre propre serveur sans réécriture de code grâce àlaya-serve. - Choisissez GLiNER2.5-Decide (
fastino/GLiNER2.5-Decide) si votre tâche consiste en une classification rapide de messages, le support de catégories multi-label (plusieurs tags simultanément), le travail avec des labels descriptifs complexes ou si vous devez déployer le service sur des serveurs à ressources limitées sans GPU dédiés. - Choisissez CLM-v0.1-8B (
Contrastive-LM/CLM-v0.1-8B) si vous construisez un agent IA autonome avec un riche ensemble d'outils (MCP, Tool Calling) et cherchez la vitesse maximale de vérification des actions et la protection contre les erreurs via la mise en cache des embeddings d'outils.