1. Czym jest format CSV: anatomia, specyfikacja RFC 4180 i struktura danych
CSV (Comma-Separated Values) to najpopularniejszy na świecie otwarty format tekstowy służący do przechowywania i wymiany dwuwymiarowych danych tabelarycznych. Jego oficjalna specyfikacja została ustandaryzowana w dokumencie IETF RFC 4180.
Z natury plik CSV jest zwykłym plikiem tekstowym pozbawionym formatowania graficznego: każdy wiersz pliku odpowiada jednemu wierszowi tabeli (rekordowi), a wartości kolumn są oddzielone przecinkami. Zazwyczaj pierwszy wiersz zarezerwowany jest dla nagłówków kolumn.
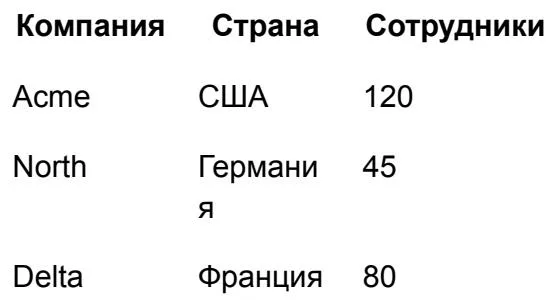 Wizualizacja danych tabelarycznych w dokumentach
Fundamentalne zasady formatowania zgodne z RFC 4180
- Separatory wierszy: Każdy rekord znajduje się w osobnym wierszu i kończy się znakiem nowej linii (
CRLFlubLF). - Obowiązkowe cudzysłowy: Jeśli wartość komórki zawiera przecinek, znak nowej linii lub podwójny cudzysłów, cała wartość musi być bezwzględnie objęta podwójnymi cudzysłowami:
"Kijów, Ukraina". - Eskapowanie cudzysłowów: Wewnętrzne cudzysłowy w tekście są escapowane poprzez ich podwojenie:
"Sp. z o.o. ""Technologies of the Future""". - Równa liczba kolumn: Każdy wiersz musi zawierać dokładnie taką samą liczbę pól jak pierwszy wiersz nagłówków.
CSV przechowuje wyłącznie czyste wartości. Nie zawiera informacji o fontach, kolorach komórek, szerokości kolumn ani formułach. To właśnie ta prostota czyni z CSV uniwersalny most łączący modele AI, bazy danych i usługi biznesowe.
2. Dlaczego CSV jest najbardziej efektywnym formatem dla LLM i agentów AI
Nowoczesne duże modele językowe (GPT-4o, Claude 3.5 Sonnet, Gemini 1.5 Pro) równie skutecznie przetwarzają zarówno dane w formacie CSV, jak i XLSX. Jednak w inżynieryjnych pipeline’ach oraz systemach agentowych to właśnie CSV stanowi domyślny standard.
Główne zalety CSV dla systemów sztucznej inteligencji
- Ekstremalna oszczędność tokenów: W przeciwieństwie do formatu XLSX (który jest skompresowanym archiwum ZIP zawierającym dziesiątki plików XML) czy JSON (gdzie każda nazwa pola jest duplikowana dla każdego obiektu), CSV przesyła nazwy pól tylko raz, w nagłówku.
- Niskie obciążenie poznawcze kontekstu: Modelom znacznie łatwiej orientować się w tabeli pozbawionej szumu XML, tagów technicznych oraz metadanych stylu.
- Wsparcie dla przesyłania strumieniowego (Streaming): AI może generować wiersze CSV jeden po drugim w czasie rzeczywistym, umożliwiając przetwarzanie milionów rekordów partiami (chunks) bez ładowania całego dokumentu do pamięci.
- Idealna kompatybilność z Code Interpreter: Środowiska wykonujące kod w ChatGPT lub Claude natychmiast odczytują CSV jednym wywołaniem
pandas.read_csv().
3. Analiza porównawcza: CSV vs XLSX i JSON
Wybór formatu zależy od tego, czy potrzebujesz wyłącznie „surowych” danych, pełnoprawnego skoroszytu z formułami, czy też złożonej hierarchii zagnieżdżonej.
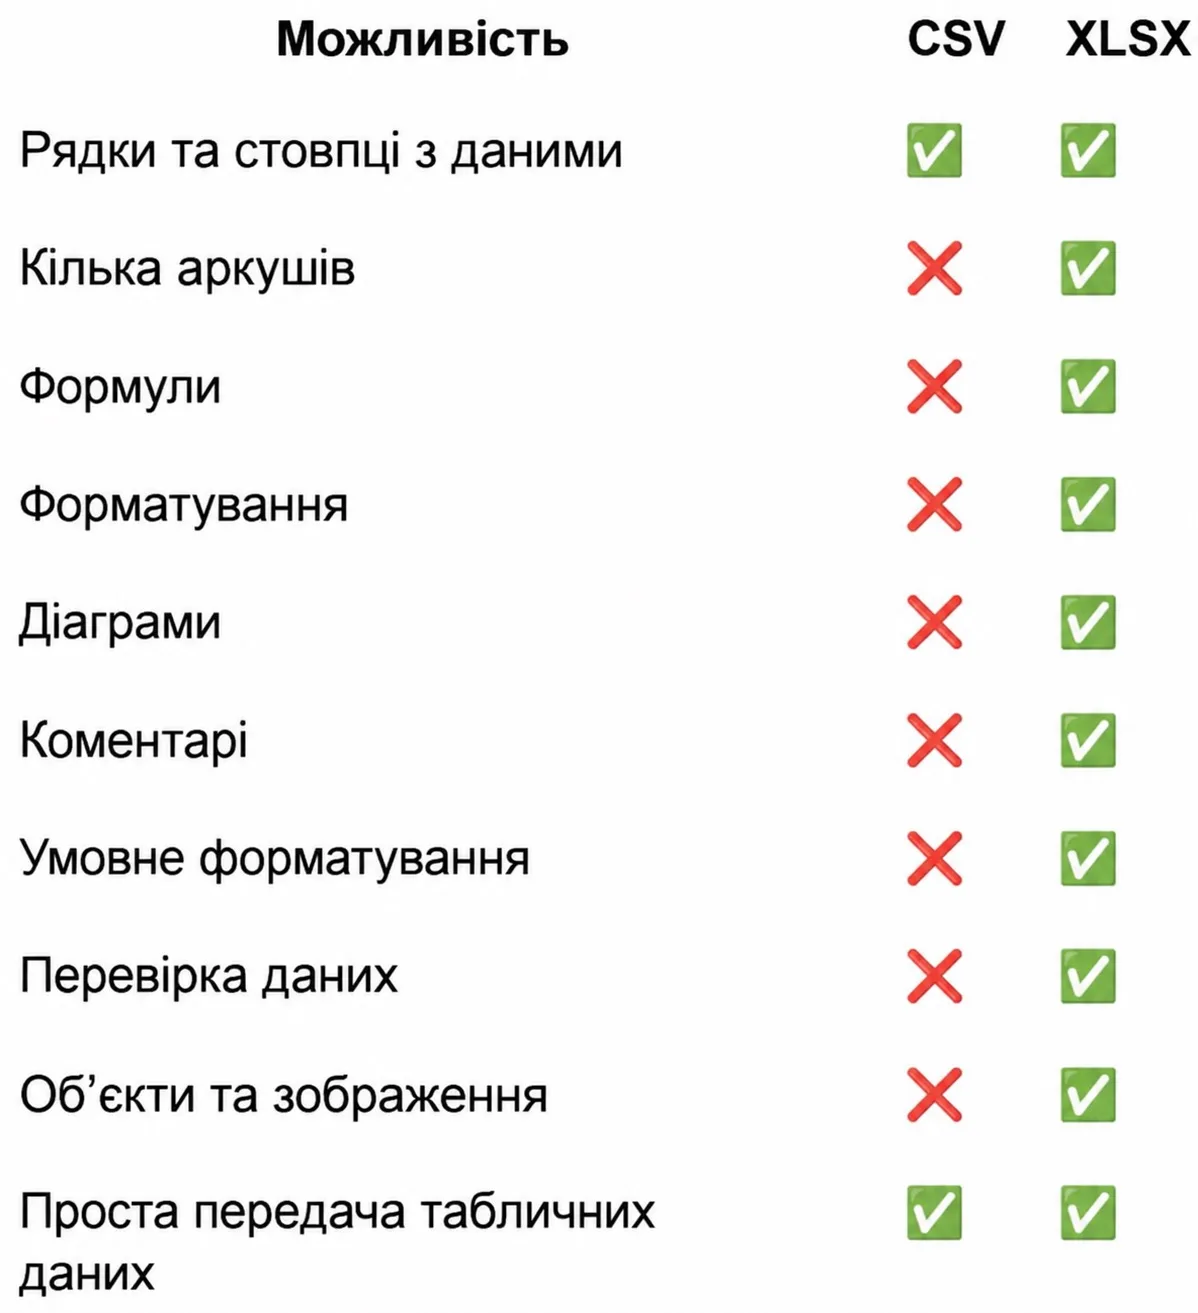 Macierz porównania możliwości CSV i XLSX
| Możliwość i kryterium | CSV | XLSX (Excel) | JSON |
|---|---|---|---|
| Wiersze i kolumny z danymi | ✓ Tak | ✓ Tak | Wymaga normalizacji |
| Wiele nazwanych arkuszy | ✗ Nie (tylko 1 arkusz) | ✓ Tak | ✓ Poprzez tablice zagnieżdżone |
| Formuły obliczeniowe | ✗ Nie | ✓ Tak (żywe formuły) | ✗ Nie |
| Formatowanie i stylizacja | ✗ Nie | ✓ Tak (kolory, fonty) | ✗ Nie |
| Zagnieżdżone struktury hierarchiczne | ✗ Trudno (dane płaskie) | ✗ Ograniczone | ✓ Idealnie (struktury drzewiaste) |
| Oszczędność tokenów dla AI | ⭐ Najwyższa | ⚠️ Niska (narzut XML) | 🟡 Średnia (powtarzanie kluczy) |
| Bezpośredni import do CRM / SQL | ✓ Jednym kliknięciem | ⚠️ Wymaga konwersji | ⚠️ Wymaga mapowania |
Jeśli Twoim celem jest przesłanie tablicy produktów do klasyfikacji lub eksport bazy leadów do wysyłki newslettera, użyj CSV. Natomiast jeśli musisz dostarczyć inwestorowi model finansowy z podsumowaniami obliczeń – pozostań przy XLSX.
4. Typowe pułapki składni CSV: separatory, cudzysłowy i kodowanie UTF-8
Choć format wydaje się prymitywny, w praktyce ponad 70% błędów automatyzacji wynika z trzech niuansów technicznych.
Konflikt przecinka i średnika (Lokalizacja Excela)
W krajach Europy i obszaru postsowieckiego separatorem dziesiętnym w liczbach jest przecinek (12,50). Z tego powodu europejskie wersje Microsoft Excel domyślnie eksportują CSV, używając jako separatora kolumn średnika (;), a nie przecinka (,).
- Jeśli AI oczekuje przecinka, a otrzymuje średnik – cała tabela scalona zostanie w jedną gigantyczną kolumnę.
- Zawsze jawnie wskazuj systemowi separator: „Używaj standardowego przecinka jako separatora kolumn”.
Znaki nowej linii wewnątrz komórki
Jeśli komórka z opisem zawiera kilka akapitów, niepoprawny parser potraktuje każdy akapit jako nowy rekord tabeli. Zgodnie ze standardem RFC 4180 takie pola muszą być zamknięte w podwójnych cudzysłowach:
Pułapka kodowania UTF-8 i znacznik BOM
Podczas otwierania pliku CSV z cyrylicą w programie Excel zamiast tekstu często pojawiają się „krzaczki”. Przyczyną jest brak sygnatury BOM (Byte Order Mark – bajty EF BB BF).
- Do importu do nowoczesnych baz danych i usług AI stosuj czysty UTF-8 without BOM.
- Aby zagwarantować poprawne otwarcie w desktopowym Microsoft Excel na Windows, zapisuj plik jako UTF-8 with BOM.
5. Przygotowanie CSV dla AI: zasady czystości i higieny danych
Im wyższa jakość wejściowego pliku CSV, tym dokładniejsze będą wnioski analityczne i transformacje przeprowadzane przez model językowy.
Przed i po obróbce sanitarnej
6. Masowa obróbka danych: czyszczenie, wzbogacanie i klasyfikacja przez AI
Największą wartość CSV wykazuje podczas masowych transformacji realizowanych przez ChatGPT Advanced Data Analysis lub Claude Code.
Główne scenariusze masowej automatyzacji
- Deduplikacja i łączenie baz: Wykrywanie ukrytych duplikatów (np.: «Google LLC» oraz «Google Polska»), czyszczenie z nieprawidłowych adresów e-mail.
- Semantyczne wzbogacanie (Enrichment): Dodawanie do istniejącej listy firm oceny ich skali, branży wg PKD lub linków do oficjalnych stron internetowych.
- Analiza sentymentu i kategoryzacja: Masowa analiza 10 000 tekstowych opinii klientów z nadawaniem tagów
Sentiment(Positive/Neutral/Negative) orazIssue_Type(Delivery/Billing/UX). - Normalizacja encji: Ujednolicanie dziesiątek różnorodnych zapisów krajów («USA», «U.S.», «United States», «Stany Zjednoczone») do jednego kodu ISO
US.
7. Kiedy CSV zdecydowanie NIE nadaje się: ograniczenia i alternatywy
CSV jest narzędziem wąsko wyspecjalizowanym. Próba wykorzystania go niezgodnie z przeznaczeniem niszczy procesy robocze.
Cztery bariery zastosowania CSV
- Relacje wielopoziomowe i listy: Jeśli jeden użytkownik ma 5 adresów dostawy, 3 karty bankowe i 20 zamówionych produktów, próba upchnięcia tego w jednym wierszu CSV spowoduje albo duplikację danych, albo nieczytelne komórki. Dla takich zadań standardem jest JSON.
- Analiza logiki formułowej: Jeśli musisz sprawdzić, jak zmiana stawki podatku w komórce
B2wpływa na zysk netto wG48, użyj XLSX. CSV niszczy formuły, pozostawiając jedynie utrwalone liczby. - Dokumenty prezentacyjne: Oferty handlowe, instrukcje i umowy wymagają stron tytułowych, układu stylistycznego i logo – do nich przeznaczony jest DOCX.
- Nieustrukturyzowana wiedza: Artykułów, prac naukowych i instrukcji nie da się sprowadzić do tabel bez utraty powiązań semantycznych – do nich stosuje się Markdown.
8. Automatyzacja programowa: praca z CSV w Python i TypeScript
W produkcyjnych agentach AI interakcja z CSV odbywa się poprzez szybkie biblioteki, które zapobiegają przepełnieniu pamięci operacyjnej.
9. Gotowa biblioteka promptów mistrzowskich do pracy z CSV
Korzystaj z tych gotowych szablonów inżynieryjnych do pracy z modelami językowymi bez utraty wierszy i struktury.
Prompt do generowania nowej bazy od zera
Prompt do czyszczenia i wzbogacania załadowanej tabeli
10. Podsumowujący checklist walidacji i ściągawka wyboru formatu
Zanim załadujesz wygenerowany plik CSV do CRM lub wyślesz go do systemu analitycznego, przeprowadź ekspresową walidację.
Checklist kontroli jakości CSV
- Integralność kolumn: Liczba przecinków w każdym wierszu zgadza się z liczbą kolumn w pierwszym wierszu nagłówków.
- Poprawne escapowanie: Wszystkie fragmenty tekstowe zawierające przecinki lub znaki nowej linii są zamknięte w podwójnych cudzysłowach
" ". - Brak zbędnych odstępów: Nie ma pustych wierszy separatora na początku, w środku ani na końcu pliku.
- Kodowanie pliku: Plik został zapisany w formacie UTF-8 (dla Excela zweryfikowano obecność BOM, jeśli wymagana).
- Jednorodność formatów: Daty mają jednolity standard (
YYYY-MM-DD), ułamki dziesiętne są zapisywane z kropką.