Classement des modèles d'IA : l'usage payant réel peut-il surpasser les benchmarks officiels ?
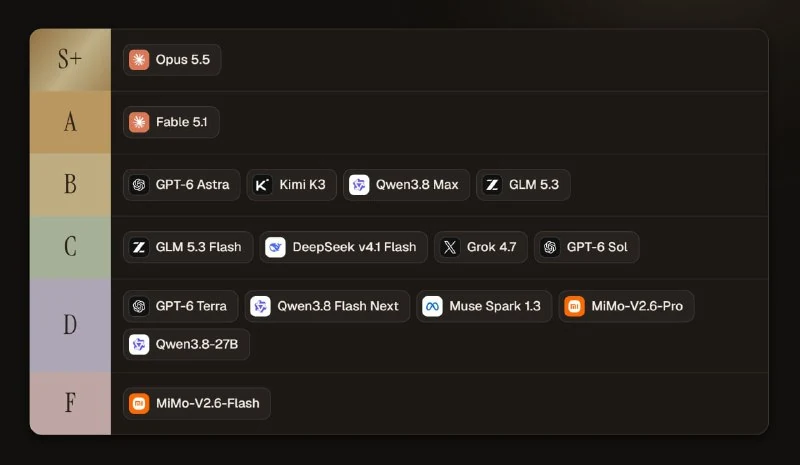
Un classement des modèles d'IA basé sur l'utilisation réelle et payante gagne en popularité, offrant une alternative potentiellement plus précise aux benchmarks officiels.
Classement des modèles d'IA : l'usage payant réel peut-il surpasser les benchmarks officiels ?
Un classement des modèles d'IA circule actuellement en ligne, suggérant qu'il pourrait être plus fiable que la plupart des benchmarks officiels.
La différence fondamentale réside dans le fait que ce classement ne repose pas sur des tâches de test synthétiques, mais sur une utilisation réelle impliquant des charges de travail payantes. Cela signifie que les classements sont façonnés non seulement par des métriques artificielles, mais aussi par l'utilité pratique, le coût et l'expérience concrète des utilisateurs.
Cela soulève une question naturelle : l'usage payant réel est-il un meilleur indicateur de la qualité des modèles d'IA que les standards de benchmarking actuels ?
Pourquoi c'est important
AnalyseL'usage payant réel met en lumière des forces que les tests synthétiques ignorent souvent, bien que cette approche soit difficile à reproduire et fortement dépendante de workflows spécifiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Qwen4-Max est disponible : 50 % moins de tokens et un coût par tâche réduit
Qwen4-Max introduit une architecture MoE, une fenêtre de contexte d’un million de tokens et une prise en charge intégrée des images.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro : Comparaison des modèles 2026
Chaque semaine ou presque, un nouveau modèle est lancé, et les mêmes questions reviennent inlassablement : faut-il changer de solution ? Qu'est-ce qui a évolué ? Pour quoi payer ?
Benchmarks pour agents : GAIA et SWE-bench
Nouvelle génération de benchmarks pratiques rigoureux pour évaluer l'autonomie de l'intelligence artificielle. GAIA teste des tâches multimodales sur le web ouvert avec fichiers et navigateur, tandis que SWE-bench vérifie la capacité des agents à trouver et corriger de vrais bugs dans de grands dépôts GitHub.
Contamination des benchmarks (Data Contamination)
Problème d'objectivité dans l'évaluation de l'intelligence artificielle, lorsque les questions et réponses issues de jeux de données de test standard (MMLU, HumanEval, GSM8K) sont accidentellement ou intentionnellement incluses dans les données d'entraînement du modèle, entraînant des scores artificiellement gonflés lors des présentations.