KI-Modell-Tierlist: Kann echte bezahlte Nutzung offizielle Benchmarks schlagen?
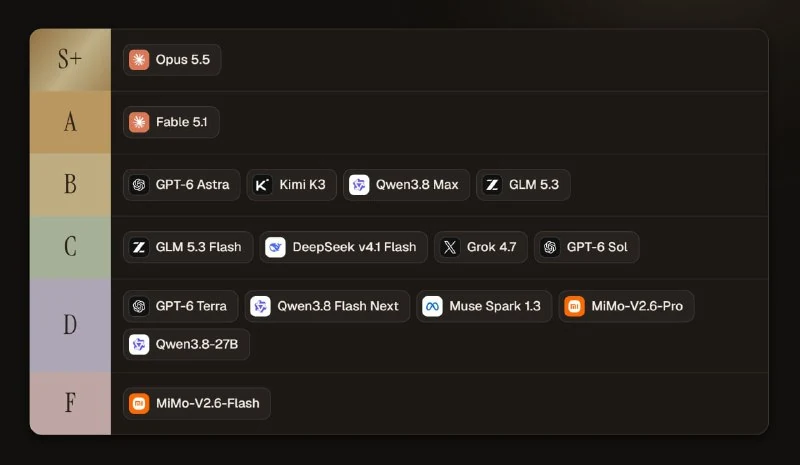
Eine im Umlauf befindliche Tierlist für KI-Modelle, basierend auf realer bezahlter Nutzung, könnte genauer sein als die meisten offiziellen Benchmarks.
KI-Modell-Tierlist: Kann echte bezahlte Nutzung offizielle Benchmarks schlagen?
Im Internet kursiert derzeit eine Tierlist für KI-Modelle, die möglicherweise präziser ist als die meisten offiziellen Benchmark-Ergebnisse.
Der entscheidende Unterschied liegt darin, dass diese Rangliste nicht auf synthetischen Testaufgaben basiert, sondern auf der tatsächlichen Nutzung mit bezahlten Workloads. Das bedeutet, dass die Platzierungen nicht nur durch künstliche Metriken bestimmt werden, sondern auch durch praktischen Nutzen, Kosten und direkte Erfahrungswerte.
Dies wirft die naheliegende Frage auf: Ist die reale bezahlte Nutzung ein besserer Indikator für die Qualität von KI-Modellen als Standard-Benchmarks?
Warum das wichtig ist
AnalyseEchte bezahlte Nutzung kann Stärken offenbaren, die in synthetischen Tests untergehen, ist jedoch schwerer zu reproduzieren und stark von spezifischen Arbeitsabläufen abhängig.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern