Classement des modèles d'IA : l'usage payant réel peut-il surpasser les benchmarks officiels ?
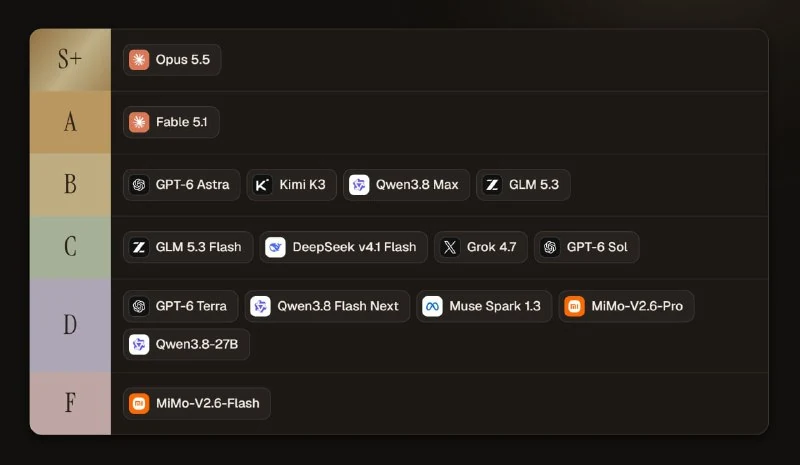
Un classement des modèles d'IA basé sur l'utilisation réelle et payante gagne en popularité, offrant une alternative potentiellement plus précise aux benchmarks officiels.
Classement des modèles d'IA : l'usage payant réel peut-il surpasser les benchmarks officiels ?
Un classement des modèles d'IA circule actuellement en ligne, suggérant qu'il pourrait être plus fiable que la plupart des benchmarks officiels.
La différence fondamentale réside dans le fait que ce classement ne repose pas sur des tâches de test synthétiques, mais sur une utilisation réelle impliquant des charges de travail payantes. Cela signifie que les classements sont façonnés non seulement par des métriques artificielles, mais aussi par l'utilité pratique, le coût et l'expérience concrète des utilisateurs.
Cela soulève une question naturelle : l'usage payant réel est-il un meilleur indicateur de la qualité des modèles d'IA que les standards de benchmarking actuels ?
Pourquoi c'est important
AnalyseL'usage payant réel met en lumière des forces que les tests synthétiques ignorent souvent, bien que cette approche soit difficile à reproduire et fortement dépendante de workflows spécifiques.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs