Ranking modeli AI: czy rzeczywiste płatne użycie przewyższa oficjalne benchmarki?
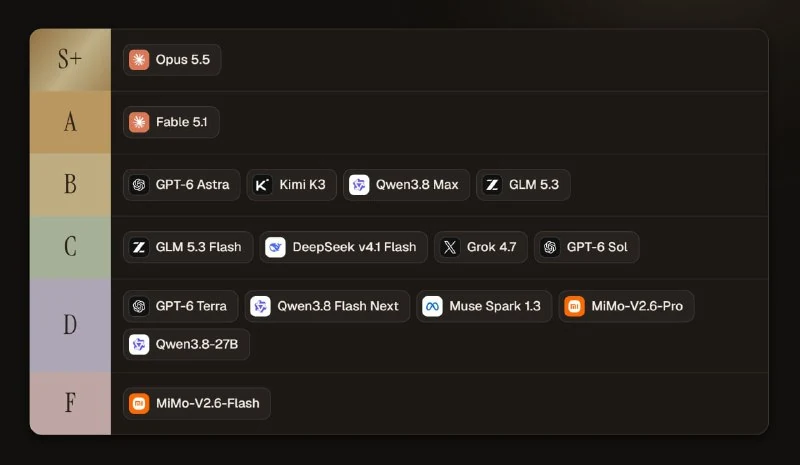
W sieci krąży nowy ranking modeli AI oparty na realnych, płatnych zastosowaniach, który może być trafniejszy niż standardowe testy. Metoda ta uwzględnia praktyczną użyteczność i koszty, a nie tylko syntetyczne metryki.
Ranking modeli AI: czy rzeczywiste płatne użycie przewyższa oficjalne benchmarki?
W internecie pojawił się nowy ranking modeli sztucznej inteligencji, który według wielu ekspertów może być bardziej precyzyjny niż większość oficjalnych benchmarków.
Kluczowa różnica polega na tym, że zestawienie to nie opiera się na zadaniach testowych, lecz na rzeczywistym użytkowaniu przy obciążeniach płatnych. Oznacza to, że pozycje w rankingu kształtują nie tylko syntetyczne wskaźniki, ale także praktyczna użyteczność, koszty oraz doświadczenia użytkowników.
Nasuwają się naturalne pytania: czy rzeczywiste, płatne wykorzystanie jest lepszym wyznacznikiem jakości modelu AI niż standardowe benchmarki?
Dlaczego to ważne
AnalizaRzeczywiste płatne użycie ujawnia mocne strony pomijane przez testy syntetyczne, jednak jego wyniki są trudne do powtórzenia i silnie zależne od specyficznych przepływów pracy.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami