Тир-лист ИИ-моделей: может ли реальное использование за деньги быть точнее бенчмарков?
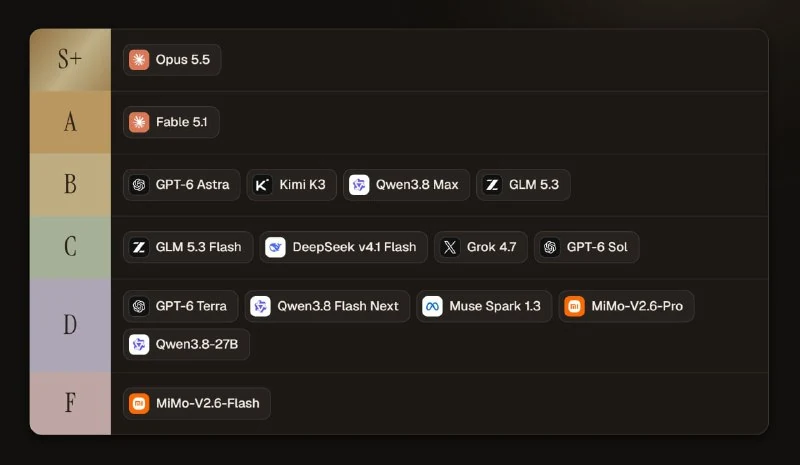
Обсуждается тир-лист ИИ-моделей, составленный не по тестовым задачам, а по реальному использованию за деньги.
Этот тир-лист ИИ-моделей, возможно, точнее большинства официальных бенчмарков.
Потому что он составлен не по результатам тестовых задач, а на основе реального использования за деньги.
С чем согласны, а с чем нет?
Почему это важно
АналитикаТакой подход показывает, как практические сценарии и стоимость могут влиять на восприятие моделей сильнее, чем стандартные бенчмарки.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Qwen4-Max вышла: меньше токенов и ниже стоимость задач
Qwen4-Max получила архитектуру MoE, контекст 1 млн токенов и встроенную поддержку изображений.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: сравнение моделей 2026
Каждые несколько недель выходит новая модель, и каждый раз те же вопросы: стоит ли переходить? что изменилось? за что платить?
Загрязнение бенчмарков (Data Contamination)
Проблема объективности оценки искусственного интеллекта, когда вопросы и ответы из стандартных тестовых наборов (MMLU, HumanEval, GSM8K) случайно или намеренно попадают в тренировочные данные модели, приводя к искусственно завышенным оценкам на презентациях.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.