Lista de niveles de modelos de IA: ¿puede el uso real pagado superar a los benchmarks oficiales?
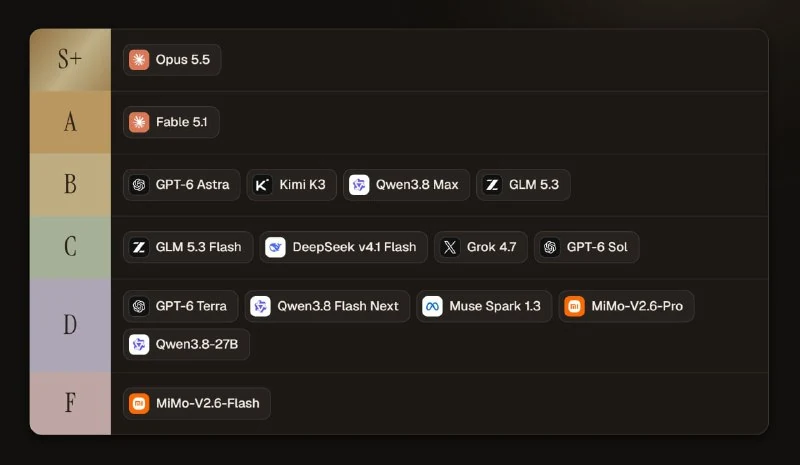
Se discute una lista de niveles de modelos de IA basada en el uso real pagado, no en pruebas sintéticas.
Lista de niveles de modelos de IA: ¿puede el uso real pagado superar a los benchmarks oficiales?
En línea circula una lista de niveles de modelos de IA que, según se señala, podría ser más precisa que la mayoría de los benchmarks oficiales.
La principal diferencia es que no se basa en tareas de prueba, sino en el uso real con cargas de trabajo pagadas. Esto significa que las posiciones no dependen solo de métricas sintéticas, sino también de la utilidad práctica, el costo y la experiencia concreta de trabajo.
El debate deja una pregunta abierta: ¿es el uso real pagado un mejor indicador de la calidad de los modelos de IA que los benchmarks estándar?
Por qué es importante
AnálisisEl uso real pagado puede mostrar ventajas que las pruebas sintéticas no capturan, aunque es menos reproducible y depende mucho del caso de uso.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Qwen4-Max ya está disponible: menos tokens y menor coste por tarea
Qwen4-Max llega con arquitectura MoE, contexto de 1M tokens, soporte de imágenes integrado y una reducción significativa de costes.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: comparación de modelos 2026
Cada pocas semanas sale un nuevo modelo y cada vez surgen las mismas preguntas: ¿debería cambiar? ¿Qué cambió por qué pagar?
Benchmarks para Agentes: GAIA y SWE-bench
Nueva generación de rigurosos benchmarks prácticos para evaluar la autonomía de la inteligencia artificial. GAIA prueba tareas multimodales en la web abierta con archivos y navegador, mientras que SWE-bench evalúa la capacidad de los agentes para encontrar y corregir errores reales en grandes repositorios de GitHub.
Contaminación de Benchmarks (Data Contamination)
El problema de la objetividad en la evaluación de inteligencia artificial, cuando preguntas y respuestas de conjuntos de pruebas estándar (MMLU, HumanEval, GSM8K) se filtran accidental o intencionadamente en los datos de entrenamiento del modelo, resultando en evaluaciones artificialmente infladas en presentaciones.