Lista de classificação de modelos de IA: o uso pago real supera os benchmarks oficiais?
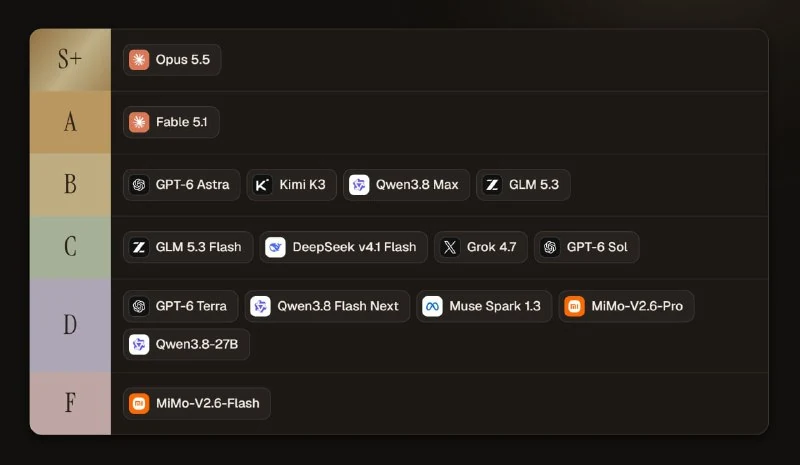
Uma nova lista de classificação de modelos de IA, baseada em uso pago real, está sendo debatida como uma alternativa potencial aos benchmarks oficiais.
Lista de classificação de modelos de IA: o uso pago real supera os benchmarks oficiais?
Uma lista de classificação (tier list) de modelos de IA está circulando online e pode ser mais precisa do que a maioria dos benchmarks oficiais.
A principal diferença é que ela não se baseia em tarefas de teste sintéticas, mas sim no uso real com cargas de trabalho pagas. Isso significa que os rankings são moldados não apenas por métricas artificiais, mas também pela utilidade prática, custo e experiência direta.
Isso levanta uma questão natural: o uso pago real é um indicador melhor da qualidade dos modelos de IA do que os padrões de benchmark convencionais?
Por que isso importa
AnáliseO uso pago real pode revelar pontos fortes que os testes sintéticos ignoram, embora seja mais difícil de reproduzir e dependa fortemente de fluxos de trabalho específicos.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Qwen4-Max já está disponível: 50% menos tokens e custo menor por tarefa
Qwen4-Max chega com arquitetura MoE, contexto de 1 milhão de tokens, suporte integrado a imagens e redução significativa de custos.
Claude Sonnet 4.6 vs GPT-5.5 vs Gemini 3.1 Pro: Comparação de Modelos 2026
A cada poucas semanas, surge um novo modelo, e sempre as mesmas perguntas: vale a pena migrar? O que mudou? Pelo que pagar?
Benchmarks para agentes: GAIA e SWE-bench
Nova geração de benchmarks práticos rigorosos para avaliar a autonomia da inteligência artificial. O GAIA testa tarefas multimodais na web aberta, envolvendo arquivos e navegador, enquanto o SWE-bench verifica a capacidade dos agentes de encontrar e corrigir bugs reais em grandes repositórios do GitHub.
Contaminação de Benchmarks (Data Contamination)
Problema de objetividade na avaliação da inteligência artificial, quando perguntas e respostas de conjuntos de testes padrão (MMLU, HumanEval, GSM8K) são incluídas acidental ou intencionalmente nos dados de treinamento do modelo, resultando em pontuações artificialmente infladas nas apresentações.