Une méthode open source presque double la puissance de calcul de la RTX 3090
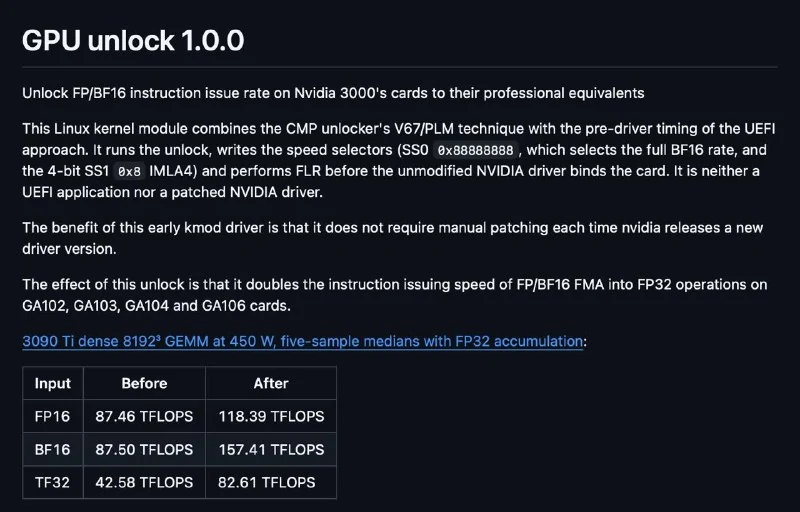
Le projet GitHub gpu-unlock contourne la limite logicielle de NVIDIA sur les Tensor Cores des GeForce 30, augmente le débit FP16/BF16 et accélère le préremplissage LLM sans patcher le pilote.
Une méthode open source presque double la puissance de calcul de la RTX 3090
Le projet open source gpu-unlock a dépassé les 5 000 étoiles sur GitHub en quelques jours.
Ce que NVIDIA limite sur GeForce 30
Les cartes GeForce 30, comme RTX 3080, RTX 3090 et RTX 3090 Ti, disposent de Tensor Cores capables de multiplier des matrices en FP16 et BF16 avec accumulation en FP32. C’est exactement cette opération qui sert à entraîner et exécuter des réseaux de neurones. Comme il s’agit de GPU de jeu, NVIDIA limite volontairement de moitié la vitesse de cette opération par logiciel — segmentation classique du marché : pour faire du ML, il faut acheter une carte ML plutôt qu’une carte gaming.
La restriction est implémentée comme un diviseur de vitesse d’émission d’instructions, et sa valeur se trouve dans des registres où l’on ne peut normalement pas écrire. Un contournement direct est donc impossible.
Comment fonctionne gpu-unlock
L’auteur a trouvé un moyen de contourner cette limite en réutilisant une technique inventée pour débloquer des restrictions similaires sur les cartes de minage CMP 170HX, et l’a intégrée sous forme de module noyau Linux.
Le module s’exécute au démarrage, avant le lancement du pilote NVIDIA, configure la vitesse complète, puis transmet la carte au pilote standard. L’essentiel est que le module agit avant le pilote : il n’est donc pas nécessaire de patcher le pilote à chaque mise à jour ni de reflasher le BIOS.
Résultats annoncés
Pour la RTX 3090 Ti, le dépôt indique les résultats GEMM 8192 à 450 W :
- BF16 : 87,5 → 157,4 TFLOPS
- FP16 : 87,5 → 118,4 TFLOPS
- TF32 : 42,6 → 82,6 TFLOPS
Sur des tâches réelles, le gain est plus modeste mais réel : le préremplissage LLM est accéléré d’environ 14 à 36 %, et les résultats de calcul restent identiques bit à bit.
Windows et installation
Le dépôt original est réservé à Linux, mais des ports tiers pour Windows existent déjà, par exemple AD103_win_unlocker.
Les instructions d’installation sont disponibles dans le dépôt.
Pourquoi c'est important
AnalyseCela montre que les limites logicielles des fabricants peuvent être contournées au niveau du noyau, offrant plus de puissance IA sur des GPU gaming existants, tout en introduisant des risques potentiels de compatibilité et de stabilité.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
L'IA aide à augmenter le débit des GPU Nvidia RTX 3000 et 4000
Sur GitHub, les projets gpu-unlock et gpu-unlock-ada affirment aider à augmenter le débit des GPU Nvidia des séries RTX 3000 et 4000.
Projet open source avec 74 compétences pour le développement de jeux
Un dépôt open source sur GitHub réunit 74 compétences pour Unity, Godot, Unreal Engine et d’autres moteurs de jeu, avec sélection automatique et prise en charge de Claude Code et Codex.
10 dépôts GitHub pour devenir ingénieur en IA en 90 jours
Devenir ingénieur en IA aujourd'hui ne se limite pas aux modèles et aux prompts. La majeure partie du travail réel s'articule autour des agents, des systèmes RAG, de l'orchestration (orchestration), des bases de données vectorielles (vector databases) et de l'infrastructure IA.
Sélection de dépôts GitHub pour le SEO et la recherche par mots-clés
8 dépôts open-source vérifiés sur GitHub dédiés à l'analyse sémantique, à l'audit technique des sites web et au Generative Engine Optimization (GEO).
Le monopole de Nvidia et la plateforme CUDA
Analyse de la domination technologique et économique de Nvidia sur le marché de l'intelligence artificielle. Comment la plateforme logicielle CUDA (Compute Unified Device Architecture), créée en 2006, a transformé les cartes graphiques de jeu ordinaires en l'outil de calcul principal de la planète, et pourquoi il est si difficile pour les concurrents (AMD, Intel) de briser ce monopole.
Moteurs haute vitesse TensorRT-LLM & SGLang
Moteurs de calcul compilés en profondeur pour une optimisation extrême de l'inférence des modèles de langage sur les serveurs NVIDIA, avec optimisation des graphes, FlashAttention-3 et routage avancé.