Open-Source-Methode verdoppelt fast die Rechenleistung der RTX 3090
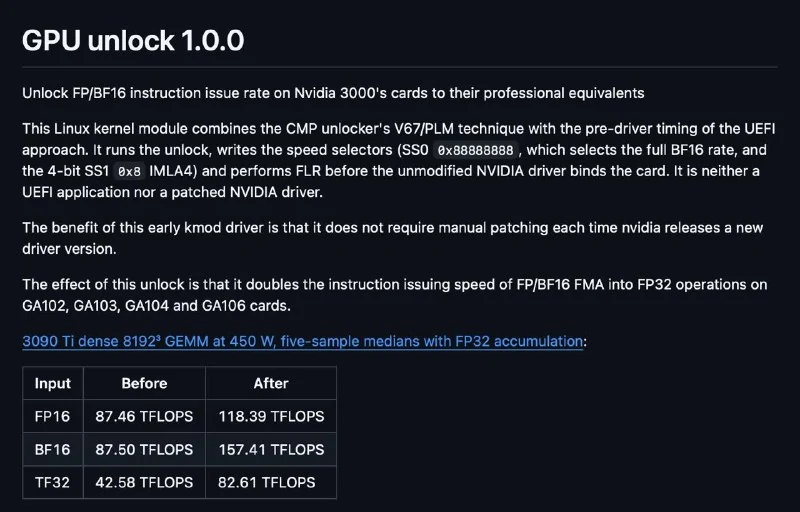
Das GitHub-Projekt gpu-unlock umgeht NVIDIAs Software-Limit bei Tensor Cores der GeForce-30-Serie, steigert FP16/BF16-Durchsatz und beschleunigt LLM-Prefill ohne Treiber-Patch.
Open-Source-Methode verdoppelt fast die Rechenleistung der RTX 3090
Das Open-Source-Projekt gpu-unlock erreichte innerhalb weniger Tage mehr als 5.000 Sterne auf GitHub.
Was NVIDIA bei GeForce 30 begrenzt
Grafikkarten der GeForce-30-Serie wie RTX 3080, RTX 3090 und RTX 3090 Ti haben Tensor Cores, die Matrizen in FP16 und BF16 mit FP32-Akkumulation multiplizieren können. Genau über diese Operation werden neuronale Netze trainiert und ausgeführt. Da es sich um Gaming-GPUs handelt, begrenzt NVIDIA die Geschwindigkeit dieser Operation per Software um die Hälfte — klassische Marktsegmentierung: Wer ML machen will, soll eine ML-Grafikkarte kaufen und keine Gaming-Karte.
Die Begrenzung ist als Geschwindigkeits-Teiler für die Instruction Issue implementiert, und ihr Wert liegt in Registern, in die normalerweise nicht geschrieben werden kann. Ein direkter Umweg ist daher nicht möglich.
Wie gpu-unlock funktioniert
Der Autor fand einen Weg, das zu umgehen, indem er eine Technik wiederverwendete, die zuvor zum Entsperren ähnlicher Limits bei Mining-Karten vom Typ CMP 170HX entwickelt wurde, und verpackte sie als Linux-Kernel-Modul.
Das Modul läuft beim Booten, bevor der NVIDIA-Treiber startet, setzt die volle Geschwindigkeit und übergibt die Karte erst danach an den Standard-Treiber. Entscheidend ist, dass es vor dem Treiber wirkt: Ein Patchen des Treibers nach jedem Update oder ein Überschreiben der BIOS ist nicht nötig.
Angegebene Ergebnisse
Für die RTX 3090 Ti nennt das Repository GEMM-8192-Ergebnisse bei 450 W:
- BF16: 87,5 → 157,4 TFLOPS
- FP16: 87,5 → 118,4 TFLOPS
- TF32: 42,6 → 82,6 TFLOPS
Bei realen Aufgaben ist der Zuwachs bescheidener, aber vorhanden: LLM-Prefill beschleunigt sich um etwa 14–36 %, und die Rechenergebnisse bleiben bitgenau identisch.
Windows und Installation
Das ursprüngliche Repository ist nur für Linux, aber es gibt bereits Drittanbieter-Ports für Windows, etwa AD103_win_unlocker.
Installationsanweisungen finden sich im Repository.
Warum das wichtig ist
AnalyseDie Entwicklung zeigt, dass künstliche Herstellerlimits auf Kernel-Ebene umgangen werden können und vorhandene Gaming-GPUs mehr KI-Leistung liefern, allerdings mit möglichen Kompatibilitäts- und Stabilitätsrisiken.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
KI hilft, den Durchsatz von Nvidia-RTX-3000- und RTX-4000-GPUs zu steigern
Auf GitHub sind die Projekte gpu-unlock und gpu-unlock-ada erschienen, die angeblich helfen, den Durchsatz von Nvidia-GPUs der Serien RTX 3000 und 4000 zu erhöhen.
Open-Source-Projekt mit 74 Skills für die Spieleentwicklung
Ein Open-Source-Repository auf GitHub bündelt 74 Skills für Unity, Godot, Unreal Engine und andere Engines, mit automatischer Skill-Auswahl und Unterstützung für Claude Code und Codex.
10 GitHub-Repositories, die Ihnen helfen, in 90 Tagen ein KI-Ingenieur zu werden
KI-Ingenieur zu werden bedeutet heute nicht nur, sich mit Modellen und Prompts auszukennen. Der Großteil der praktischen Arbeit dreht sich um Agenten, RAG-Systeme, Orchestrierung (Orchestration), Vektordatenbanken (Vector Databases) und KI-Infrastruktur.
Auswahl an GitHub-Repositories für SEO und Keyword-Recherche
8 geprüfte Open-Source-Repositories auf GitHub zur Erfassung von Semantik, technischen Website-Audits und Generative Engine Optimization (GEO).
Nvidias Monopolstellung und die CUDA-Plattform
Eine Analyse der technologischen und wirtschaftlichen Dominanz von Nvidia auf dem Markt für künstliche Intelligenz. Wie die im Jahr 2006 eingeführte Softwareplattform CUDA (Compute Unified Device Architecture) gewöhnliche Gaming-Grafikkarten zum wichtigsten Rechenwerkzeug der Welt machte und warum es Konkurrenten wie AMD und Intel so schwerfällt, dieses Monopol zu brechen.
TensorRT-LLM & SGLang Hochleistungs-Engines
Tief kompilierte Berechnungs-Engines für die extreme Optimierung der Inferenz von Sprachmodellen auf NVIDIA-Servern, mit Graphoptimierung, FlashAttention-3 und erweitertem Routing.