Método open source quase dobra o desempenho computacional da RTX 3090
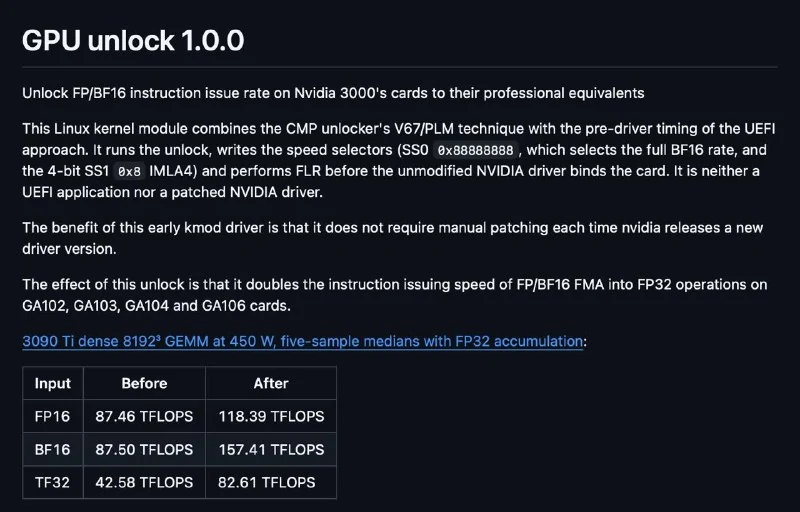
O projeto GitHub gpu-unlock contorna o limite de software da NVIDIA nos Tensor Cores da série GeForce 30, aumenta o throughput FP16/BF16 e acelera o prefill de LLM sem patchear o driver.
Método open source quase dobra o desempenho computacional da RTX 3090
O projeto open source gpu-unlock ultrapassou 5 mil estrelas no GitHub em poucos dias.
O que a NVIDIA limita na GeForce 30
As placas GeForce 30, como RTX 3080, RTX 3090 e RTX 3090 Ti, têm Tensor Cores capazes de multiplicar matrizes em FP16 e BF16 com acumulação em FP32. É exatamente essa operação que permite treinar e executar redes neurais. Como são GPUs para jogos, a NVIDIA limita por software pela metade a velocidade dessa operação — segmentação clássica de mercado: se você quer fazer ML, compre uma GPU ML em vez de uma placa gamer.
A restrição é implementada como um divisor de velocidade de emissão de instruções, e seu valor fica em registradores nos quais normalmente não se pode escrever. Por isso, um bypass direto não é possível.
Como o gpu-unlock funciona
O autor encontrou uma forma de contornar isso reutilizando uma técnica criada antes para desbloquear limites semelhantes em placas de mineração CMP 170HX, empacotada como módulo de kernel do Linux.
O módulo roda durante o boot, antes de o driver da NVIDIA iniciar, define a velocidade completa e só então entrega a placa ao driver original. O ponto importante é que ele atua antes do driver, então não é preciso patchear o driver a cada atualização ou regravar a BIOS.
Resultados reportados
Para a RTX 3090 Ti, o repositório traz os resultados GEMM 8192 a 450 W:
- BF16: 87,5 → 157,4 TFLOPS
- FP16: 87,5 → 118,4 TFLOPS
- TF32: 42,6 → 82,6 TFLOPS
Em tarefas reais, o ganho é mais modesto, mas existe: o prefill de LLM acelera aproximadamente 14–36%, e os resultados de cálculo continuam idênticos bit a bit.
Windows e instalação
O repositório original é apenas para Linux, mas já existem ports de terceiros para Windows, como AD103_win_unlocker.
As instruções de instalação estão no repositório.
Por que isso importa
AnáliseIsso mostra que limites de software do fabricante podem ser contornados no nível do kernel, oferecendo mais desempenho de IA em GPUs gamer já existentes, embora com possíveis riscos de compatibilidade e estabilidade.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
IA ajuda a aumentar a largura de banda das GPUs Nvidia RTX 3000 e 4000
No GitHub, os projetos gpu-unlock e gpu-unlock-ada afirmam ajudar a aumentar a largura de banda das GPUs Nvidia das séries RTX 3000 e 4000.
Projeto open source com 74 skills para desenvolvimento de jogos
Um repositório open source no GitHub reúne 74 skills para Unity, Godot, Unreal Engine e outros motores de jogo, com seleção automática e suporte a Claude Code e Codex.
10 Repositórios do GitHub para se tornar um Engenheiro de IA em 90 dias
Tornar-se um engenheiro de IA hoje não se resume apenas a modelos e prompts. A maior parte do trabalho real é construída em torno de agentes, sistemas RAG, orquestração (orchestration), bancos de dados vetoriais (vector databases) e infraestrutura de IA.
Seleção de repositórios do GitHub para SEO e pesquisa por palavras-chave
8 repositórios open-source verificados no GitHub para coleta de semântica, auditoria técnica de sites e Generative Engine Optimization (GEO).
O Monopólio da Nvidia e a Plataforma CUDA
Análise do domínio tecnológico e econômico da corporação Nvidia no mercado de inteligência artificial. Como a plataforma de software CUDA (Compute Unified Device Architecture), criada em 2006, transformou placas de vídeo comuns para jogos na principal ferramenta computacional do planeta, e por que é tão difícil para os concorrentes (AMD, Intel) quebrar esse monopólio.
Motores de Alta Velocidade TensorRT-LLM & SGLang
Motores de computação profundamente compilados para otimização extrema da inferência de modelos de linguagem em servidores NVIDIA, com otimização de grafos, FlashAttention-3 e roteamento avançado.