Metoda open source niemal podwaja moc obliczeniową RTX 3090
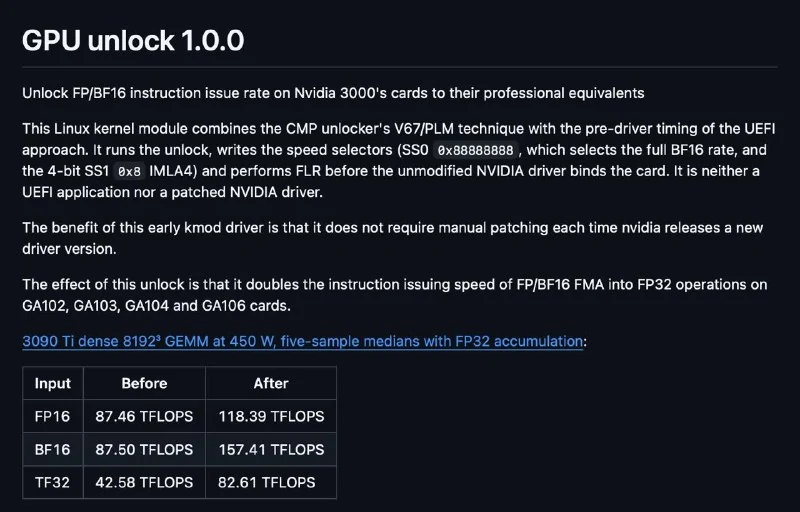
Projekt GitHub gpu-unlock omija programowe ograniczenie NVIDII w rdzeniach tensorowych kart GeForce 30, zwiększa przepustowość FP16/BF16 i przyspiesza prefill LLM bez patchowania sterownika.
Metoda open source niemal podwaja moc obliczeniową RTX 3090
Projekt open source gpu-unlock w ciągu kilku dni zebrał ponad 5 tysięcy gwiazdek na GitHubie.
Co NVIDIA ogranicza w kartach GeForce 30
Karty GeForce 30, takie jak RTX 3080, RTX 3090 i RTX 3090 Ti, mają rdzenie tensorowe zdolne do mnożenia macierzy w formatach FP16 i BF16 z akumulacją w FP32. Właśnie przez tę operację szkoli się i uruchamia sieci neuronowe. Ponieważ są to karty gamingowe, NVIDIA celowo ogranicza programowo prędkość tej operacji o połowę — klasyczna segmentacja rynku: jeśli chcesz robić ML, zapłać za kartę ML, a nie za gamingową.
Ograniczenie jest zaimplementowane jako dzielnik prędkości wydawania instrukcji, a jego wartość znajduje się w rejestrach, do których zwykle nie można zapisywać. Dlatego bezpośrednie obejście nie jest możliwe.
Jak działa gpu-unlock
Autor znalazł sposób obejścia, wykorzystując technikę wcześniej wymyśloną do odblokowywania podobnych ograniczeń w kartach do kopania CMP 170HX, i opakował ją jako moduł jądra Linuxa.
Moduł uruchamia się podczas bootowania, przed startem sterownika NVIDIA, ustawia pełną prędkość, a dopiero potem przekazuje kartę standardowemu sterownikowi. Kluczowe jest to, że działa przed sterownikiem — nie trzeba więc patchować sterownika przy każdej aktualizacji ani przeprogramowywać BIOS-u.
Podawane wyniki
Dla RTX 3090 Ti repozytorium podaje wyniki GEMM 8192 przy 450 W:
- BF16: 87,5 → 157,4 TFLOPS
- FP16: 87,5 → 118,4 TFLOPS
- TF32: 42,6 → 82,6 TFLOPS
W rzeczywistych zadaniach wzrost jest skromniejszy, ale widoczny: prefill LLM przyspiesza około 14–36%, a wyniki obliczeń pozostają bitowo identyczne.
Windows i instalacja
Oryginalne repozytorium działa tylko na Linuxie, ale istnieją już nieoficjalne porty na Windows, np. AD103_win_unlocker.
Instrukcja instalacji znajduje się w repozytorium.
Dlaczego to ważne
AnalizaPokazuje to, że sztuczne ograniczenia producenta można obejść na poziomie jądra, uzyskując więcej mocy AI z istniejących kart gamingowych, choć z możliwymi ryzykami kompatybilności i stabilności.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami
Powiązane w ekosystemie
Praktyczne poradniki, kluczowa terminologia i skille agentów
AI pomaga zwiększyć przepustowość kart graficznych Nvidia RTX 3000 i 4000
Na GitHubie pojawiły się projekty gpu-unlock i gpu-unlock-ada, które mają pomagać zwiększać przepustowość kart graficznych Nvidia z serii RTX 3000 i 4000.
Projekt open source z 74 umiejętnościami do tworzenia gier
Repozytorium open source na GitHub zawiera 74 umiejętności dla Unity, Godot, Unreal Engine i innych silników, z automatycznym doborem i obsługą Claude Code oraz Codex.
10 repozytoriów GitHub, które pomogą zostać inżynierem AI w 90 dni
Zostanie inżynierem AI to dziś nie tylko kwestia modeli i promptów. Większość rzeczywistej pracy opiera się na agentach, systemach RAG, orkiestracji (orchestration), bazach danych wektorowych (vector databases) oraz infrastrukturze AI.
Zbiór repozytoriów GitHub do SEO i wyszukiwania słów kluczowych
8 sprawdzonych repozytoriów open-source na GitHubie służących do zbierania semantyki, audytu technicznego witryn oraz optymalizacji pod kątem generatywnych silników wyszukiwania (GEO).
Monopol Nvidii i platforma CUDA
Analiza technologicznej i ekonomicznej dominacji korporacji Nvidia na rynku sztucznej inteligencji. Jak stworzona w 2006 roku platforma programistyczna CUDA (Compute Unified Device Architecture) przekształciła zwykłe karty graficzne do gier w główny narzędzie obliczeniowe świata oraz dlaczego konkurenci (AMD, Intel) mają tak duże trudności z przełamaniem tego monopolu.
Silniki TensorRT-LLM i SGLang o wysokiej wydajności
Głęboko skompilowane silniki obliczeniowe do ekstremalnej optymalizacji wnioskowania modeli językowych na serwerach NVIDIA, z optymalizacją grafów, FlashAttention-3 oraz zaawansowanym routingiem.