Un método open source casi duplica el rendimiento computacional de la RTX 3090
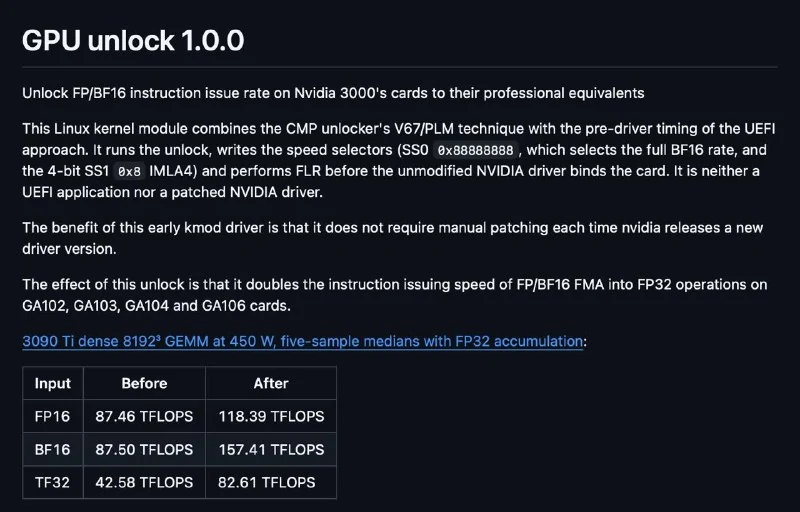
El proyecto de GitHub gpu-unlock evita el límite de software de NVIDIA en los núcleos tensoriales de la serie GeForce 30, aumenta el rendimiento FP16/BF16 y acelera el prefill de LLM sin parchear el controlador.
Un método open source casi duplica el rendimiento computacional de la RTX 3090
El proyecto open source gpu-unlock superó las 5.000 estrellas en GitHub en pocos días.
Qué limita NVIDIA en GeForce 30
Las tarjetas GeForce 30, como RTX 3080, RTX 3090 y RTX 3090 Ti, tienen núcleos tensoriales capaces de multiplicar matrices en FP16 y BF16 con acumulación en FP32. Esa operación es la base para entrenar y ejecutar redes neuronales. Como son GPU para juegos, NVIDIA limita por software a la mitad la velocidad de esa operación: una segmentación clásica del mercado, si quieres hacer ML, compra una GPU ML y no una tarjeta gamer.
La restricción se implementa como un divisor de velocidad de emisión de instrucciones, y su valor está en registros donde normalmente no se puede escribir. Por eso no es posible saltárselo directamente.
Cómo funciona gpu-unlock
El autor encontró una forma de romper ese límite reutilizando una técnica creada antes para desbloquear restricciones similares en tarjetas de minería CMP 170HX, empaquetada como un módulo del kernel de Linux.
El módulo se ejecuta durante el arranque, antes de que inicie el controlador de NVIDIA, configura la velocidad completa y luego entrega la GPU al controlador original. Lo importante es que actúa antes del controlador, así que no hace falta parchearlo en cada actualización ni reprogramar la BIOS.
Resultados reportados
Para la RTX 3090 Ti, el repositorio indica estos resultados de GEMM 8192 a 450 W:
- BF16: 87,5 → 157,4 TFLOPS
- FP16: 87,5 → 118,4 TFLOPS
- TF32: 42,6 → 82,6 TFLOPS
En cargas reales la mejora es más modesta, pero existe: el prefill de LLM se acelera aproximadamente un 14–36%, y los resultados de cálculo siguen siendo idénticos bit a bit.
Windows e instalación
El repositorio original es solo para Linux, pero ya existen puertos de terceros para Windows, como AD103_win_unlocker.
Las instrucciones de instalación están en el repositorio.
Por qué es importante
AnálisisMuestra que la segmentación de software del fabricante puede evitarse a nivel del kernel, ofreciendo más rendimiento de IA en GPUs de gaming existentes, aunque con posibles riesgos de compatibilidad y estabilidad.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
La IA ayuda a aumentar el ancho de banda de las GPU Nvidia RTX 3000 y 4000
En GitHub aparecen los proyectos gpu-unlock y gpu-unlock-ada, que afirman ayudar a aumentar el ancho de banda de las GPU Nvidia de las series RTX 3000 y 4000.
Proyecto open source con 74 habilidades para desarrollo de juegos
Un repositorio de código abierto en GitHub reúne 74 habilidades para Unity, Godot, Unreal Engine y otros motores de juegos, con selección automática y soporte para Claude Code y Codex.
10 repositorios de GitHub que te ayudarán a convertirte en ingeniero de IA en 90 días
Convertirse en ingeniero de inteligencia artificial hoy en día no se trata solo de modelos e indicaciones. La mayor parte del trabajo real se basa en agentes, sistemas RAG, orquestación, bases de datos vectoriales e infraestructura de inteligencia artificial.
Top Repositorios de GitHub para SEO y Keyword Research
8 repositorios open-source verificados en GitHub para búsqueda semántica de palabras clave, auditorías técnicas y Optimización para Motores Generativos (GEO).
Monopolio de Nvidia y la Plataforma CUDA
Análisis del dominio tecnológico y económico de Nvidia en el mercado de inteligencia artificial. La plataforma CUDA (Compute Unified Device Architecture), creada en 2006, transformó las tarjetas gráficas de juegos en la principal herramienta computacional del planeta, dificultando a los competidores (AMD, Intel) romper esta monopolio.
Motores de Alta Velocidad TensorRT-LLM y SGLang
Motores computacionales profundamente compilados para la optimización extrema del inferencia de modelos de lenguaje en servidores NVIDIA, con optimización de gráficos, FlashAttention-3 y enrutamiento avanzado.