Peut-être que les réseaux de neurones ne sont pas des boîtes noires, comme on le croit
Le chercheur en interprétabilité de l'IA Nick Cammarata avance que les neurones pourraient encoder des concepts globaux cohérents plutôt que des mélanges aléatoires de caractéristiques, rendant la décomposition complexe parfois inutile.
Nick Cammarata, chercheur reconnu en interprétabilité de l'IA, a publié un essai majeur intitulé Neural Networks Are Already Clean. Cammarata a été l'un des premiers scientifiques à travailler sur l'interprétabilité, il a constitué l'équipe d'interprétabilité chez OpenAI et a signé plusieurs travaux fondamentaux sur le sujet. Il travaille aujourd'hui chez Goodfire.
Il avance l'hypothèse que les réseaux de neurones sont en réalité plus simples qu'on ne le pense.
La plupart des tentatives d'interprétation des réseaux reposent sur l'hypothèse de superposition : regarder des neurones individuels paraît presque inutile, car le modèle accumulerait dans chacun d'eux une masse d'éléments sans lien. Les chercheurs essaient donc d'abord de démêler les activations à l'aide d'autres modèles — l'approche la plus connue étant SAE — puis travaillent avec les caractéristiques trouvées.
Cammarata dit qu'il défendait lui-même cette approche. Aujourd'hui, il affirme qu'aucune décomposition n'est peut-être nécessaire et que les neurones ne mélangent pas des éléments aléatoires, mais des concepts globaux plus larges. Ils ne sont simplement pas toujours évidents pour les humains.
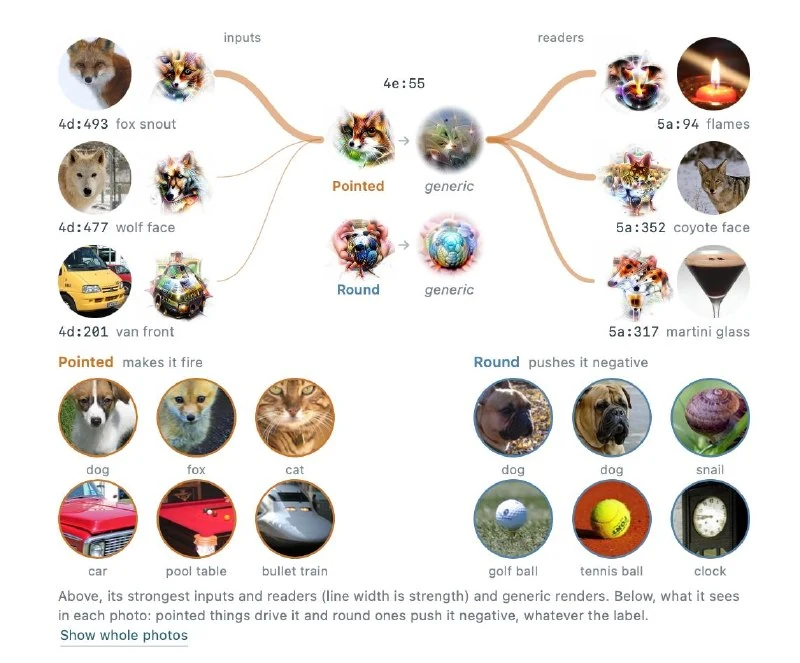
Un travail fondateur pour l'interprétabilité est Circuits (2020). Cammarata en était coauteur, et ce papier a été vu comme une « preuve » de la superposition dans les réseaux de neurones. Les auteurs ont analysé GoogLeNet pour la reconnaissance d'images et ont montré que le même neurone s'activait à la fois sur des capots de voitures et sur des visages de chats. Cet exemple reste considéré comme la preuve canonique que des caractéristiques sans lien se répartissent presque en désordre dans les neurones.
Dans son essai, Cammarata réfute ce cas. Il s'est avéré que les deux concepts se mélangeaient dans ce neurone pour une raison : c'était un neurone en forme de V. Il s'activait lorsqu'il fallait distinguer ce qui est allongé de ce qui est rond, et les visages de chats et les capots n'étaient que des exemples fréquents.
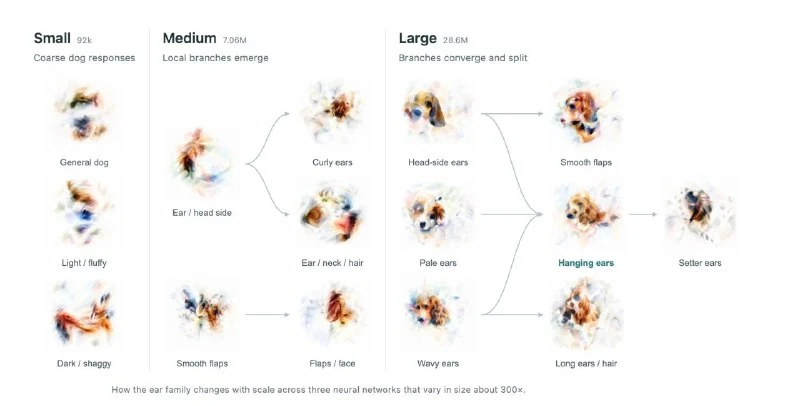
Cammarata montre que la lisibilité des neurones ne dépend même pas de la taille du modèle. Plus le modèle est petit, plus les neurones sont grossiers en termes de caractéristique interne, et plus il est difficile de comprendre ces caractéristiques. L'auteur appelle cela la nature fractale de la généralisation : les petits modèles donnent une explication brute, les grands une explication plus détaillée pour chaque neurone.
Pour les modèles de langage, cela semble aussi fonctionner. Dans des audits préliminaires de Qwen3-32B, environ 90 % des neurones ont une fonction principale, environ 7 % en ont deux liées, et seuls 2 à 4 % restent incompris. Des résultats similaires sont rapportés pour des modèles allant jusqu'à des billions de paramètres, y compris les modèles MoE.
Bien que toutes les conclusions soient très provisoires, l'auteur suggère un parallèle avec la « leçon amère » de Sutton : en interprétabilité, le même principe que celui du deep learning pourrait s'appliquer — l'étude directe des neurones à grande échelle pourrait être plus efficace que les approches complexes.
Pourquoi c'est important
AnalyseSi l'hypothèse se confirme, l'interprétabilité de l'IA pourrait se simplifier : plutôt que de décomposer coûteusement les activations, les chercheurs pourraient analyser les neurones directement, accélérant les audits de modèles et la compréhension de leur comportement.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs