Можливо, нейромережі — зовсім не чорні скриньки, як ми звикли вважати
Дослідник інтерпретованості ШІ Нік Каммарата стверджує, що окремі нейрони можуть кодувати цілісні глобальні концепції, а не безладні набори ознак, тому складна декомпозиція активностей не завжди є обов'язковою.
Нік Каммарата, відомий дослідник інтерпретованості ШІ, опублікував значне есе Neural Networks Are Already Clean. Каммарата був одним із перших учених, які займалися інтерпретованістю, зокрема сформував команду інтерпретованості в OpenAI, і написав кілька фундаментальних робіт. Нині він працює в Goodfire.
Він висунув гіпотезу, що нейромережі насправді влаштовані простіше, ніж прийнято вважати.
Більшість спроб інтерпретувати мережі спираються на припущення про суперпозицію: вважається, що дивитися окремо на нейрони майже безглуздо, бо модель ніби зваливає в кожен із них безліч пов'язаних і не пов'язаних речей. Тому дослідники спершу намагаються розплутати активації за допомогою інших моделей — найвідоміший підхід — SAE — і лише потім працюють із знайденими ознаками.
Каммарата каже, що сам раніше дотримувався такого підходу. Тепер він стверджує, що декомпозиція, можливо, взагалі не потрібна, і що в нейронах насправді об'єднані не випадкові речі, а ширші глобальні концепції. Просто вони не завжди очевидні для людини.
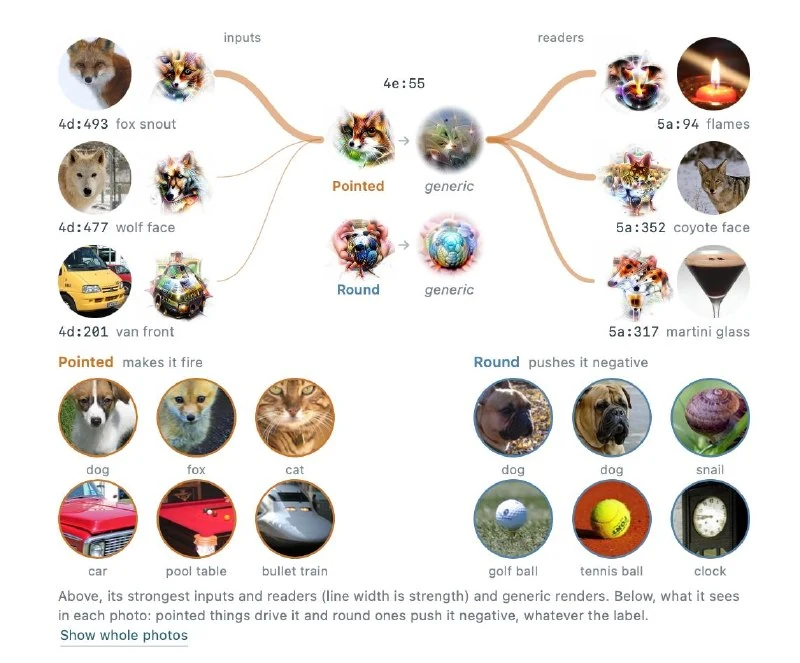
Основоположною роботою для сфери інтерпретованості вважається Circuits (2020). Каммарата був її співавтором, і саме там ніби «доказали» суперпозицію нейромереж. Автори розібрали GoogLeNet для розпізнавання зображень і показали, що один і той самий нейрон активувався і на капоти автомобілів, і на мордочки котів. Цей приклад досі сприймається як канонічний доказ того, що не пов'язані ознаки майже безладно розтікаються по нейронах.
У своєму есе Каммарата спростовує цей кейс. Виявилося, що дві концепції змішалися в цьому нейроні не випадково: це був нейрон V-подібної форми. Він активувався, коли потрібно було відрізнити витягнуте від круглого, а котячі мордочки й капоти виявилися просто найчастішими прикладами.
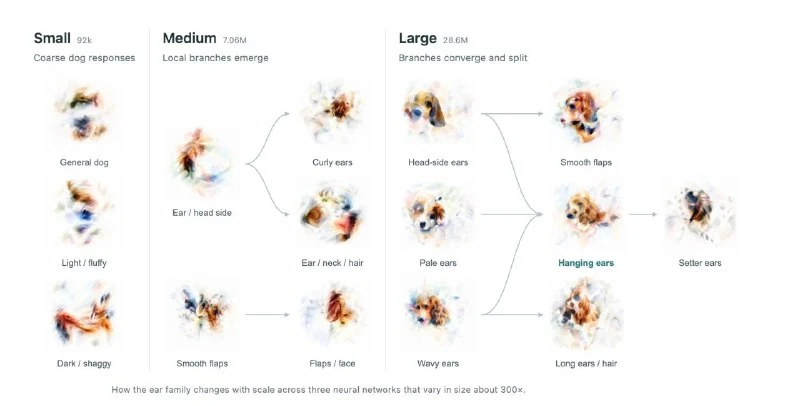
Каммарата показує, що читабельність нейронів не залежить навіть від розміру моделі. Просто чим модель менша, тим грубіші нейрони за внутрішньою ознакою і тим складніше зрозуміти ці ознаки. Автор називає це фрактальною природою узагальнення: маленькі моделі дають грубше пояснення, великі — детальніше для кожного нейрона.
У разі мовних моделей це, зокрема, також працює. У попередніх аудитах Qwen3-32B приблизно в 90% нейронів одна основна робота, у ~7% — дві пов'язані, і лише 2–4% поки незрозумілі. Аналогічні результати спостерігаються для моделей аж до трильйонів параметрів, включно з MoE.
Хоча всі висновки поки що дуже гіпотетичні, автор припускає, що тут є паралель із «гірким уроком» Саттона і що в інтерпретованості може спрацювати той самий принцип, що й у глибокому навчанні. Тобто звичайне дослідження нейронів у масштабі може виявитися ефективнішим за складні підходи.
Чому це важливо
АналітикаЯкщо гіпотеза підтвердиться, інтерпретованість ШІ може спроститися: замість складних розщеплень активностей дослідники зможуть частіше аналізувати нейрони напряму, що прискорить аудит моделей і пошук причин їхньої поведінки.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками