Być może sieci neuronowe wcale nie są czarnymi skrzynkami, jak zwykle zakładamy
Badacz interpretowalności AI Nick Cammarata twierdzi, że pojedyncze neurony mogą kodować spójne globalne koncepcje zamiast przypadkowych zbiorów cech, co sugeruje, że złożona dekompozycja nie zawsze jest potrzebna.
Nick Cammarata, znany badacz interpretowalności AI, opublikował ważny esej Neural Networks Are Already Clean. Cammarata był jednym z pierwszych naukowców zajmujących się interpretowalnością, zbudował zespół interpretowalności w OpenAI i napisał kilka fundamentalnych prac na ten temat. Obecnie pracuje w Goodfire.
Wysuwa hipotezę, że sieci neuronowe są w rzeczywistości prostsze, niż myślimy.
Większość prób interpretowania sieci opiera się na założeniu superpozycji: patrzenie na pojedyncze neurony wydaje się bezcelowe, ponieważ model miałby wrzucać do każdego z nich wiele niepowiązanych rzeczy. Dlatego badacze najpierw próbują rozplątać aktywacje za pomocą innych modeli — najlepiej znane podejście to SAE — a dopiero potem pracują ze znalezionymi cechami.
Cammarata mówi, że sam wcześniej popierał takie podejście. Teraz twierdzi, że dekompozycja może wcale nie być potrzebna i że w neuronach nie są połączone przypadkowe rzeczy, lecz szersze globalne koncepcje. Po prostu nie zawsze są oczywiste dla ludzi.
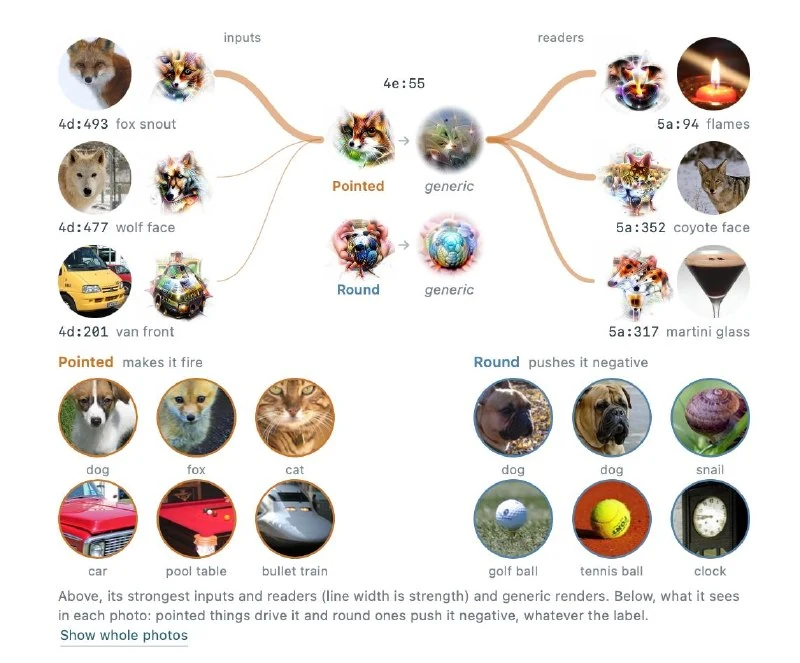
Fundamentalną pracą dla dziedziny interpretowalności jest Circuits (2020). Cammarata był jej współautorem i właśnie tam «dowodzono» superpozycji sieci neuronowych. Autorzy przeanalizowali GoogLeNet do rozpoznawania obrazów i pokazali, że ten sam neuron aktywował się zarówno przy maskach samochodów, jak i kocich mordkach. Ten przykład jest nadal uważany za kanoniczny dowód, że niepowiązane cechy rozlewają się po neuronach prawie bezładnie.
W swoim eseju Cammarata obala ten przypadek. Okazało się, że dwie koncepcje mieszały się w tym neuronie nie bez powodu: był to neuron w kształcie litery V. Aktywował się, gdy trzeba było odróżnić kształty wydłużone od okrągłych, a kocie mordki i maski były po prostu najczęstszymi przykładami.
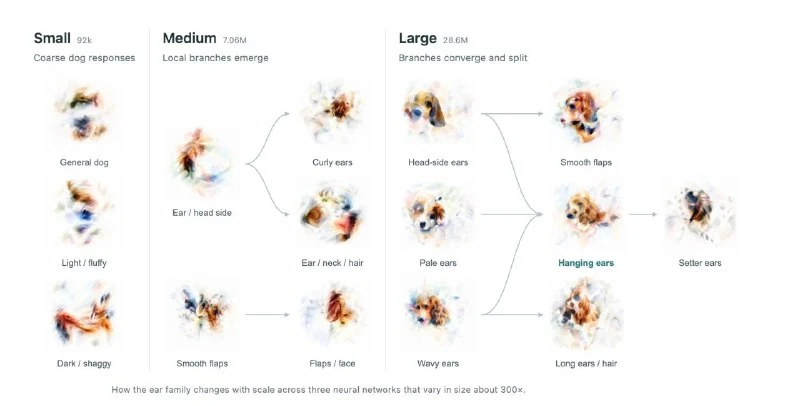
Cammarata pokazuje, że czytelność neuronów nie zależy nawet od rozmiaru modelu. Im mniejszy model, tym bardziej zgrubne są neurony pod względem wewnętrznej cechy i tym trudniej zrozumieć te cechy. Autor nazywa to fraktalną naturą generalizacji: małe modele dają grube wyjaśnienie, duże — bardziej szczegółowe dla każdego neuronu.
W przypadku modeli językowych to również wydaje się działać. W wstępnych audytach Qwen3-32B około 90% neuronów ma jedno główne zadanie, około 7% dwa powiązane zadania, a tylko 2–4% pozostaje niezrozumiałe. Podobne wyniki raportuje się dla modeli o bilionach parametrów, w tym modeli MoE.
Choć wszystkie wnioski są wciąż bardzo hipotetyczne, autor sugeruje podobieństwo do «gorzkiej lekcji» Suttona: w interpretowalności może zadziałać ta sama zasada co w deep learningu — zwykłe badanie neuronów na dużą skalę może okazać się skuteczniejsze niż złożone podejścia.
Dlaczego to ważne
AnalizaJeśli hipoteza się potwierdzi, interpretowalność AI może się uprosić: zamiast skomplikowanej dekompozycji aktywacji badacze mogliby częściej analizować neurony bezpośrednio, przyspieszając audyt modeli i rozumienie ich zachowania.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami