Quizás las redes neuronales no sean cajas negras, como solemos pensar
El investigador en interpretabilidad de IA Nick Cammarata sostiene que las neuronas pueden codificar conceptos globales coherentes en lugar de mezclas aleatorias de características, por lo que la descomposición compleja no siempre sería necesaria.
Nick Cammarata, destacado investigador en interpretabilidad de IA, publicó un ensayo importante titulado Neural Networks Are Already Clean. Cammarata fue uno de los primeros científicos en trabajar en interpretabilidad, creó el equipo de interpretabilidad de OpenAI y firmó varios trabajos fundamentales sobre el tema. Actualmente trabaja en Goodfire.
Propone la hipótesis de que las redes neuronales pueden estar organizadas de forma más simple de lo que creemos.
La mayoría de los intentos de interpretar redes se basan en la suposición de superposición: parece casi inútil mirar neuronas individuales porque el modelo supuestamente acumula en cada una muchas cosas inconexas. Por eso los investigadores intentan primero desenredar las activaciones con otros modelos —el enfoque más conocido es SAE— y solo después trabajar con las características encontradas.
Cammarata dice que él mismo defendía este enfoque. Ahora sostiene que quizá no haga falta ninguna descomposición y que en las neuronas no se combinan cosas aleatorias, sino conceptos globales más amplios. Simplemente no siempre son obvios para los humanos.
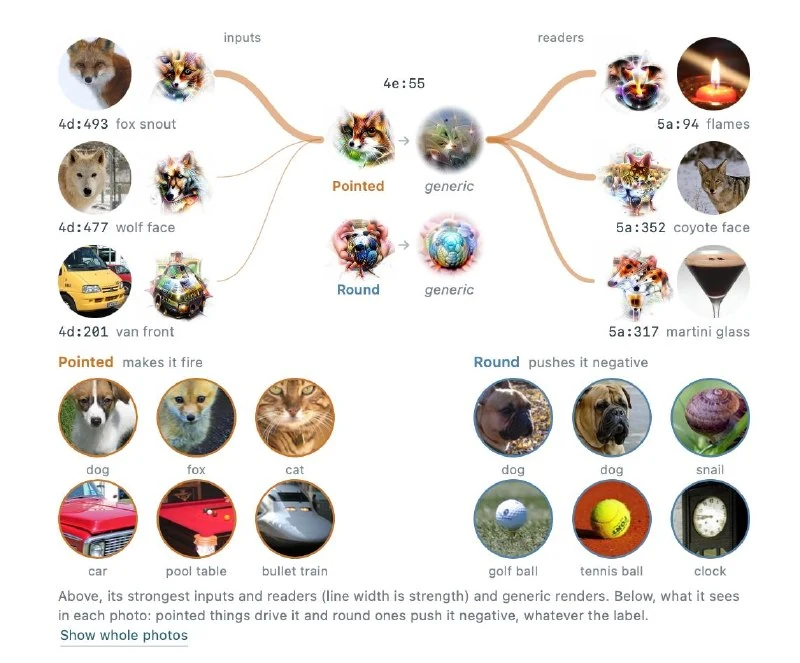
Un trabajo fundacional para la interpretabilidad es Circuits (2020). Cammarata fue coautor y allí se «demostró» la superposición en redes neuronales. Los autores analizaron GoogLeNet para reconocimiento de imágenes y mostraron que una misma neurona se activaba tanto con capós de coches como con caras de gatos. Ese ejemplo sigue considerándose una prueba canónica de que las características inconexas se reparten casi sin orden por las neuronas.
En su ensayo, Cammarata rebate ese caso. Resultó que las dos conceptos se mezclaban en esa neurona por una razón: era una neurona en forma de V. Se activaba cuando había que distinguir lo alargado de lo redondo, y las caras de gatos y los capós eran solo ejemplos frecuentes.
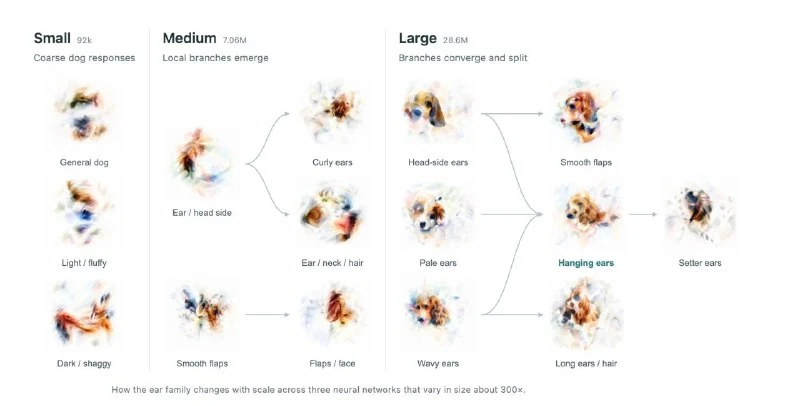
Cammarata muestra que la legibilidad de las neuronas no depende ni siquiera del tamaño del modelo. Los modelos más pequeños tienen neuronas más gruesas en cuanto a rasgo interno, lo que dificulta entender esos rasgos. El autor llama a esto la naturaleza fractal de la generalización: los modelos pequeños dan una explicación burda, los grandes más detallada para cada neurona.
En modelos de lenguaje, esto también parece funcionar. En auditorías preliminares de Qwen3-32B, alrededor del 90% de las neuronas tiene una tarea principal, cerca del 7% tiene dos tareas relacionadas y solo el 2–4% sigue sin entenderse. Los resultados son similares para modelos de hasta billones de parámetros, incluidos los MoE.
Aunque todas las conclusiones son muy provisionales, el autor sugiere un paralelo con la «lección amarga» de Sutton: en interpretabilidad podría funcionar el mismo principio que en el aprendizaje profundo, es decir, estudiar neuronas a escala de forma directa podría ser más eficaz que los enfoques complejos.
Por qué es importante
AnálisisSi la hipótesis se confirma, la interpretabilidad de la IA podría simplificarse: en lugar de descomponer activaciones con modelos auxiliares, los investigadores podrían analizar neuronas directamente, acelerando auditorías y comprensión del comportamiento de los modelos.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores