Vielleicht sind neuronale Netze gar keine Black Boxes, wie wir oft annehmen
Der KI-Interpretierbarkeitsforscher Nick Cammarata argumentiert, dass einzelne Neuronen kohärente globale Konzepte statt zufälliger Merkmalssammlungen kodieren könnten, sodass komplexe Dekomposition nicht immer nötig wäre.
Nick Cammarata, ein bekannter Forscher im Bereich der KI-Interpretierbarkeit, hat ein wichtiges Essay mit dem Titel Neural Networks Are Already Clean veröffentlicht. Cammarata gehörte zu den ersten Wissenschaftlern, die sich mit Interpretierbarkeit befassten, baute das Interpretierbarkeits-Team bei OpenAI auf und verfasste mehrere grundlegende Arbeiten zu dem Thema. Heute arbeitet er bei Goodfire.
Er stellt die Hypothese auf, dass neuronale Netze tatsächlich einfacher aufgebaut sind, als wir denken.
Die meisten Versuche, Netze zu interpretieren, beruhen auf der Annahme der Superposition: Einzelne Neuronen anzuschauen erscheint fast sinnlos, weil das Modell angeblich viele unzusammenhängende Dinge in jedem Neuron bündelt. Deshalb versuchen Forschende zunächst, Aktivierungen mit anderen Modellen zu entwirren — der bekannteste Ansatz ist SAE — und arbeiten erst danach mit den gefundenen Merkmalen.
Cammarata sagt, dass er selbst früher diesen Ansatz vertreten habe. Jetzt behauptet er, dass eine Dekomposition möglicherweise gar nicht nötig sei und dass in Neuronen nicht zufällige Dinge kombiniert würden, sondern breitere globale Konzepte. Sie seien für Menschen nur nicht immer offensichtlich.
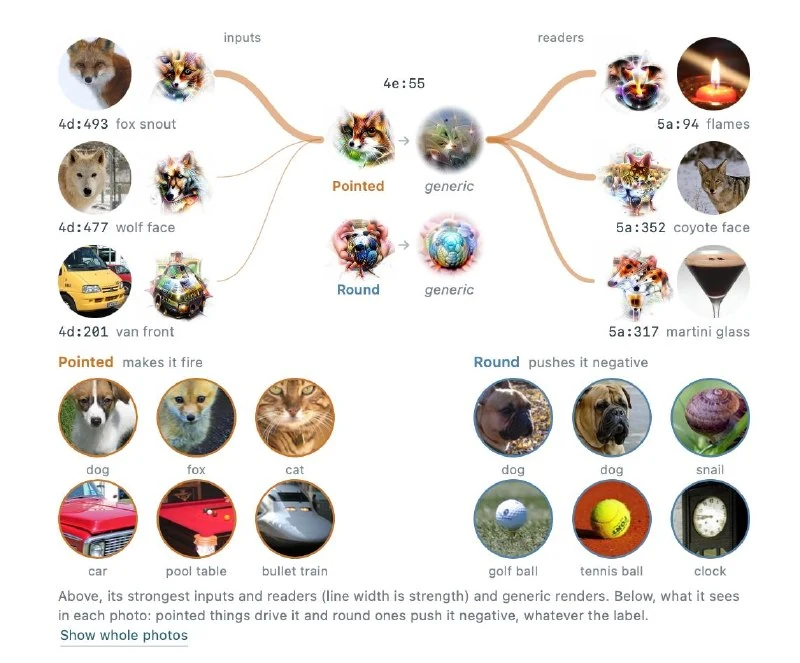
Eine Grundlagenarbeit für die Interpretierbarkeit ist Circuits (2020). Cammarata war Mitautor, und dort wurde die Superposition neuronaler Netze gewissermaßen «bewiesen». Die Autoren analysierten GoogLeNet für Bilderkennung und zeigten, dass dasselbe Neuron sowohl auf Motorhauben von Autos als auch auf Katzengesichter reagierte. Dieses Beispiel gilt weiterhin als kanonischer Beleg dafür, dass unzusammenhängende Merkmale fast chaotisch über Neuronen verteilt sind.
In seinem Essay widerlegt Cammarata diesen Fall. Es stellte sich heraus, dass die beiden Konzepte in diesem Neuron nicht zufällig vermischt waren: Es war ein V-förmiges Neuron. Es aktivierte, wenn es darum ging, Langgestrecktes von Runden zu unterscheiden, und Katzengesichter und Motorhauben waren nur häufige Beispiele.
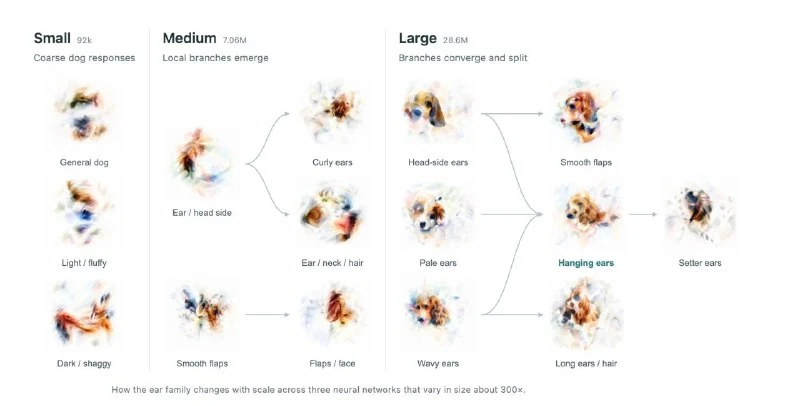
Cammarata zeigt, dass die Lesbarkeit von Neuronen nicht einmal von der Modellgröße abhängt. Je kleiner das Modell, desto gröber sind die Neuronen in Bezug auf ihr inneres Merkmal, und desto schwieriger ist es, diese Merkmale zu verstehen. Der Autor nennt dies die fraktale Natur der Generalisierung: kleine Modelle liefern eine grobe Erklärung, große eine detailliertere für jedes Neuron.
Bei Sprachmodellen scheint dies ebenfalls zu funktionieren. In vorläufigen Audits von Qwen3-32B hat bei etwa 90 % der Neuronen eines eine Hauptaufgabe, bei rund 7 % zwei zusammenhängende Aufgaben, und nur 2–4 % sind noch unklar. Ähnliche Ergebnisse werden für Modelle bis zu Billionen Parametern berichtet, einschließlich MoE-Modellen.
Obwohl alle Schlussfolgerungen noch sehr spekulativ sind, vermutet der Autor eine Parallele zu Suttons «bitter lesson»: In der Interpretierbarkeit könnte derselbe Prinzip funktionieren wie im Deep Learning — gewöhnliche Neuronforschung im Maßstab könnte wirksamer sein als komplexe Ansätze.
Warum das wichtig ist
AnalyseFalls sich die Hypothese bestätigt, könnte KI-Interpretierbarkeit einfacher werden: Statt Aktivierungen aufwendig zu zerlegen, könnten Forschende Neuronen direkt analysieren, was Modell-Audits und das Verständnis von Modellverhalten beschleunigt.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern