Talvez as redes neurais não sejam caixas-pretas, como costumamos pensar
O pesquisador de interpretabilidade de IA Nick Cammarata argumenta que neurônios podem codificar conceitos globais coerentes em vez de misturas aleatórias de características, sugerindo que a decomposição complexa nem sempre é necessária.
Nick Cammarata, pesquisador conhecido na área de interpretabilidade de IA, publicou um ensaio importante intitulado Neural Networks Are Already Clean. Cammarata foi um dos primeiros cientistas a trabalhar com interpretabilidade, construiu a equipe de interpretabilidade da OpenAI e escreveu vários trabalhos fundamentais sobre o tema. Atualmente, ele trabalha na Goodfire.
Ele propõe a hipótese de que as redes neurais podem ser, na verdade, mais simples do que imaginamos.
A maioria das tentativas de interpretar redes se baseia na suposição de superposição: olhar para neurônios individuais parece quase sem sentido, porque o modelo supostamente acumula em cada um deles muitas coisas desconexas. Por isso, os pesquisadores tentam primeiro desembaraçar as ativações usando outros modelos — a abordagem mais conhecida é SAE — e só depois trabalhar com as características encontradas.
Cammarata diz que antes defendia essa abordagem. Agora, ele afirma que talvez nenhuma decomposição seja necessária e que, nos neurônios, não estão misturadas coisas aleatórias, mas conceitos globais mais amplos. Eles simplesmente nem sempre são óbvios para humanos.
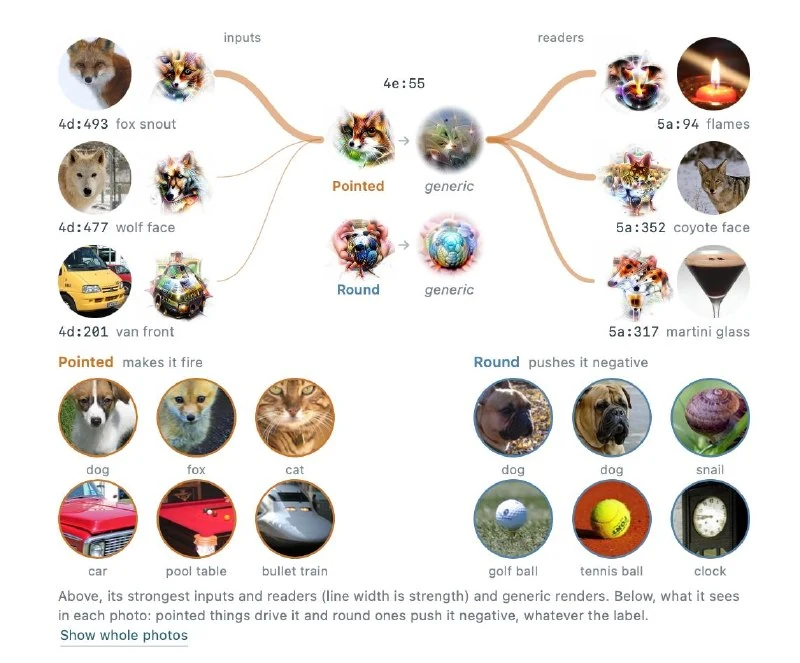
Um trabalho fundamental para a área de interpretabilidade é Circuits (2020). Cammarata foi coautor, e ali a superposição das redes neurais foi «provada». Os autores analisaram o GoogLeNet para reconhecimento de imagens e mostraram que o mesmo neurônio ativava tanto para capôs de carros quanto para rostos de gatos. Esse exemplo ainda é considerado uma prova canônica de que características desconexas se espalham quase sem ordem pelos neurônios.
Em seu ensaio, Cammarata refuta esse caso. Verificou-se que os dois conceitos se misturavam nesse neurônio por uma razão: era um neurônio em forma de V. Ele ativava quando era preciso distinguir o alongado do redondo, e rostos de gatos e capôs eram apenas exemplos frequentes.
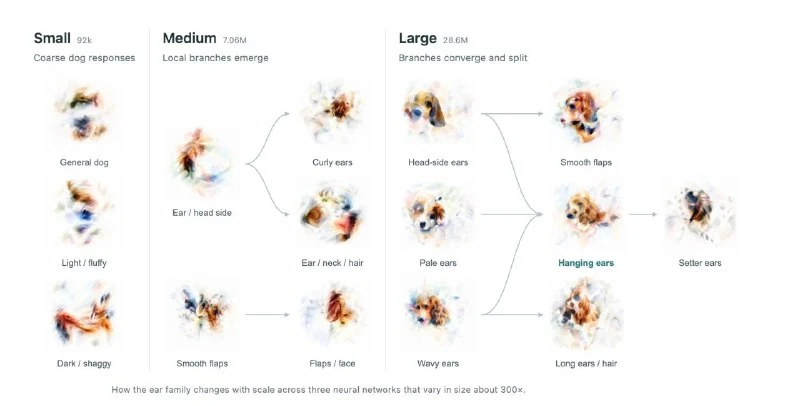
Cammarata mostra que a legibilidade dos neurônios não depende nem do tamanho do modelo. Quanto menor o modelo, mais grosseiros são os neurônios em relação ao traço interno, e mais difícil é entender esses traços. O autor chama isso de natureza fractal da generalização: modelos pequenos dão uma explicação grosseira, modelos grandes dão uma explicação mais detalhada para cada neurônio.
No caso de modelos de linguagem, isso também parece funcionar. Em auditorias preliminares do Qwen3-32B, cerca de 90% dos neurônios têm uma função principal, cerca de 7% têm duas funções relacionadas e apenas 2–4% ainda não são compreendidos. Resultados semelhantes são observados para modelos com até trilhões de parâmetros, incluindo modelos MoE.
Embora todas as conclusões sejam ainda muito especulativas, o autor sugere um paralelo com a «lição amarga» de Sutton: na interpretabilidade, pode funcionar o mesmo princípio que no deep learning — estudar neurônios diretamente em escala pode ser mais eficaz do que abordagens complexas.
Por que isso importa
AnáliseSe a hipótese se confirmar, a interpretabilidade de IA pode ficar mais simples: em vez de decompor ativações com modelos auxiliares, pesquisadores poderão analisar neurônios diretamente, acelerando auditorias e a compreensão do comportamento dos modelos.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores