LeCun avait raison : un modèle de 109 millions de paramètres a surpassé un modèle de 72 milliards
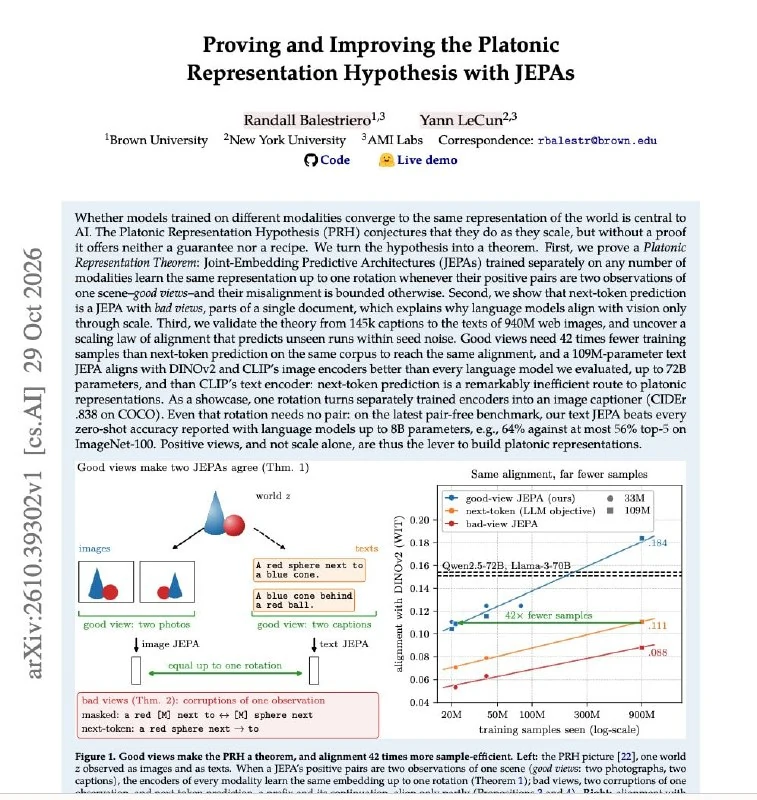
Une étude de Randall Balestriero et Yann LeCun suggère que la qualité et le type de données comptent davantage que la taille du modèle.
Yann LeCun avait raison, mais personne dans cette industrie ne veut le dire à voix haute.
Un modèle avec 109 millions de paramètres a surpassé un modèle avec 72 milliards de paramètres.
Depuis des années, LeCun affirme que la taille d’un modèle ne suffit pas à lui faire comprendre le monde. Meta a misé sur l’approche inverse. En novembre, il a quitté l’entreprise et fondé son propre laboratoire à Paris.
Il a récemment publié des preuves de sa théorie.
Depuis 2024, l’industrie a suivi l’idée selon laquelle il suffit d’entraîner des modèles de plus en plus grands sur du texte, des images et du son pour qu’ils finissent par former une représentation commune du monde. On pensait que la taille réglait tout, mais cette hypothèse n’avait jamais été prouvée.
Randall Balestriero et Yann LeCun l’ont testée. Les résultats montrent que la taille du modèle n’est pas décisive.
Ce qui compte, ce sont les données que le modèle reçoit ensemble.
Une photographie et sa description sont deux manières différentes de transmettre des informations sur le même objet. Les modèles entraînés sur de telles paires atteignent le résultat voulu beaucoup plus vite.
En revanche, deux paragraphes d’un même document ne sont pas deux représentations du même objet. Les modèles entraînés sur ce type de données atteignent un résultat comparable beaucoup plus lentement et exigent nettement plus de ressources de calcul.
La prédiction du jeton suivant appartient précisément à ce second type. C’est sur ce principe que fonctionnent pratiquement tous les chatbots modernes.
Dans les expériences, la première méthode a atteint un niveau de compréhension comparable avec seulement 21,6 millions d’exemples. Pour l’entraînement par prédiction du jeton suivant, il a fallu 900 millions.
De plus, un modèle textuel de 109 millions de paramètres a formé une représentation du monde plus proche de celle d’un modèle entraîné sur des images que celle d’un modèle linguistique de 72 milliards de paramètres.
660 fois moins de paramètres.
Pourquoi c'est important
AnalyseCela remet en cause le dogme de la taille et pourrait orienter le développement de l’IA vers de meilleures données multimodales et un entraînement plus efficace.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs
Lié dans l'écosystème
Guides pratiques, terminologie clé et compétences d'agents
Mistral ouvre les poids de Large 4, le modèle Le Chonk de 1 000 milliards de paramètres
Mistral a publié les poids ouverts de son modèle phare Large 4, surnommé Le Chonk, et réduit les prix de l'API.
Partie II. Architecture des agents IA : du modèle à la mémoire et aux outils
Immersion technique approfondie : tokenisation, cache KV, déterminisme de l'échantillonnage, stack d'entraînement, quantification, ingénierie contextuelle, stack de sécurité, RAG en production, ReAct et systèmes swarm multi-agents.
Modèles de pointe (Frontier Models)
La classe d'intelligence artificielle la plus puissante à l'avant-garde de la recherche mondiale (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), définissant les limites actuelles des capacités de raisonnement, d'autonomie et de codage.
LLM (Large Language Model - Grand modèle de langage)
Classe fondamentale d'architectures de réseaux neuronaux basée sur le transformateur autorégressif, qui prédit la distribution probabiliste des tokens suivants et démontre des propriétés émergentes de pensée abstraite, de synthèse de code et de raisonnement logique.