Модель із 109 млн параметрів перевершила модель із 72 млрд: ШІ-дослідження
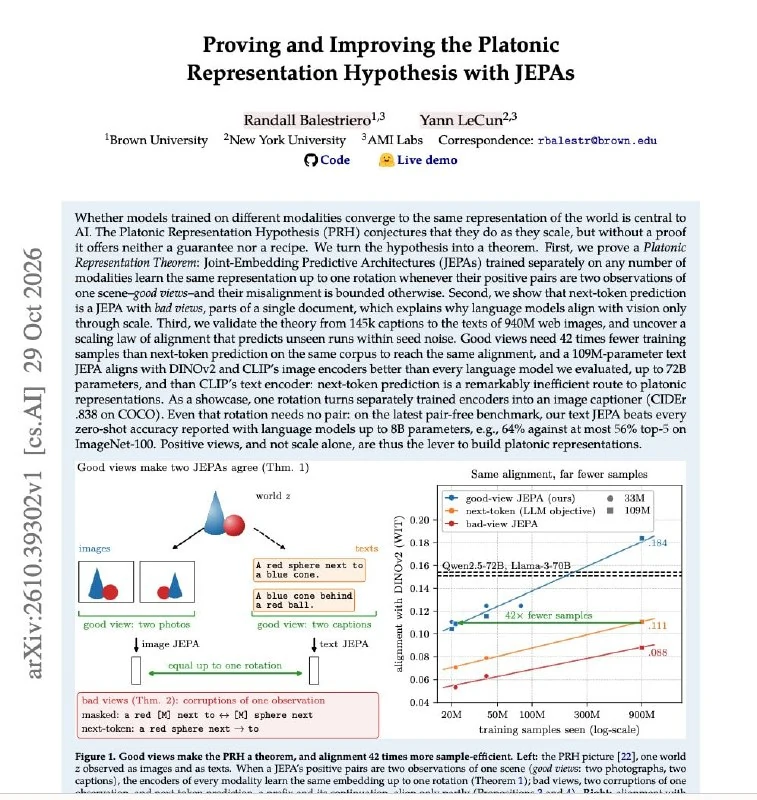
Дослідження Рендалла Балестрієро та Яна Лекуна показало, що якість і тип даних можуть бути важливішими за розмір ШІ-моделі.
Ян ЛеКун мав рацію, але в цій індустрії ніхто не хоче говорити про це вголос.
Модель із 109 млн параметрів перевершила модель із 72 млрд параметрів.
Уже кілька років ЛеКун стверджує, що масштаб моделі сам по собі не змушує її розуміти навколишній світ. Meta зробила ставку на протилежний підхід. У листопаді він залишив компанію та заснував власну лабораторію в Парижі.
Нещодавно він опублікував докази своєї теорії.
З 2024 року індустрія дотримувалася ідеї, згідно з якою достатньо навчати дедалі більші моделі на тексті, зображеннях і звуках, щоб зрештою вони сформували однакове внутрішнє представлення навколишнього світу. Вважалося, що все вирішує масштаб. Але цю гіпотезу так і не довели.
Рендалл Балестрієро та Ян ЛеКун перевірили її. Результати показали, що справа зовсім не в розмірі моделі.
Вирішальну роль відіграє те, які саме дані модель отримує разом.
Фотографія та її опис — це два різні способи передачі інформації про один об’єкт. Моделі, навчені на таких парах, досягають потрібного результату значно швидше.
А два абзаци з одного документа не є двома представленнями одного й того самого об’єкта. Моделі, навчені на таких даних, досягають аналогічного результату набагато повільніше й потребують значно більших обчислювальних ресурсів.
Саме до другого типу відноситься передбачення наступного токена. На цьому принципі працюють практично всі сучасні чат-боти.
У ході експериментів перший метод дозволив досягти аналогічного рівня розуміння всього на 21,6 млн прикладів. Для навчання з передбаченням наступного токена знадобилося 900 млн.
Більше того, текстова модель із 109 млн параметрів сформувала уявлення про навколишній світ, яке виявилося ближчим до уявлення моделі, навченої на зображеннях, ніж у мовної моделі з 72 млрд параметрів.
У 660 разів менше параметрів.
Чому це важливо
АналітикаЦе ставить під сумнів догму про масштаб і може перенаправити розробку ШІ до кращих мультимодальних даних та ефективнішого навчання.
Обговорити новину у спільноті
Діліться своїм досвідом та думками з ШІ-розробниками
Пов'язані матеріали екосистеми
Практичні гайди, термінологія та агентські скіли
Mistral випустила відкриті ваги Large 4 — ШІ-модель Le Chonk з 1 трлн параметрів
Mistral відкрила ваги флагманської ШІ-моделі Large 4, яку називають Le Chonk, та знизила ціни на API.
LLM (Large Language Model - Велика мовна модель)
Фундаментальний клас нейромережевих архітектур на базі авторегресійного трансформера, що передбачає ймовірнісний розподіл наступних токенів і демонструє емерджентні властивості абстрактного мислення, синтезу коду та логічного висновку.
OpenAI таємно тестує GPT-6.2 Astra: нову модель помітили в статистиці Codex
У частини користувачів у статистиці використання Codex з’явився окремий запис gpt-6.2-astra, тоді як у списку доступних моделей досі значиться GPT-6 Astra.
Частина I. Архітектура ШІ-агентів: фундаментальні блоки
Десять фундаментальних блоків сучасного агента: таксономія моделей, рантайм-петля, техніки промптингу, дистиляція, навички (skills), пам'ять, function calling та юніт-економіка.