LeCun tenía razón: un modelo de 109 millones de parámetros superó a uno de 72.000 millones
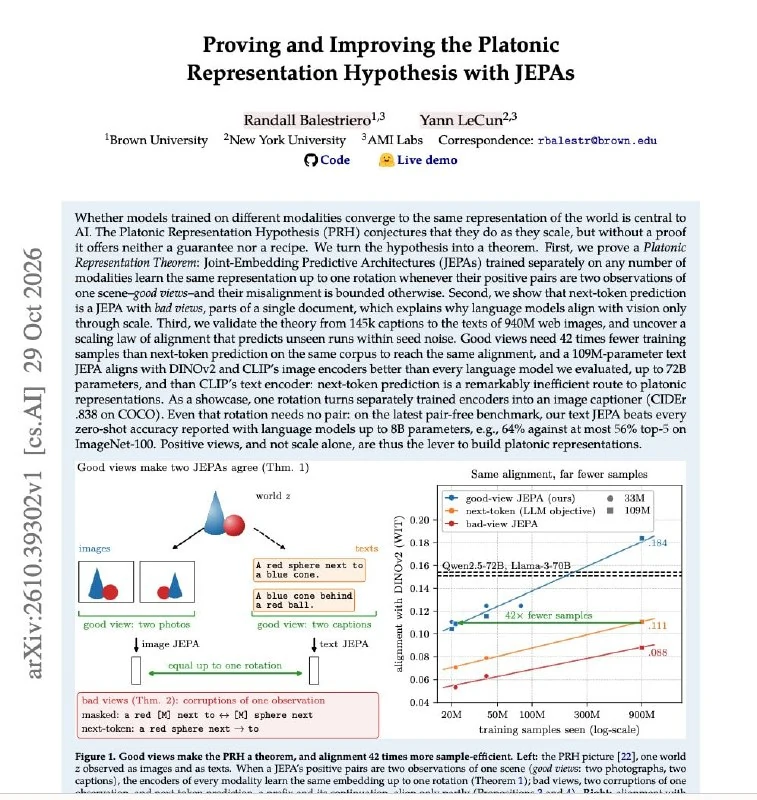
Un estudio de Randall Balestriero y Yann LeCun sugiere que la calidad y el tipo de datos importan más que el tamaño del modelo.
Yann LeCun tenía razón, pero en esta industria nadie quiere decirlo en voz alta.
Un modelo con 109 millones de parámetros superó a uno con 72.000 millones.
Durante años LeCun ha sostenido que la escala del modelo por sí sola no lo obliga a comprender el mundo. Meta apostó por el enfoque contrario. En noviembre dejó la empresa y fundó su propio laboratorio en París.
Recientemente publicó pruebas de su teoría.
Desde 2024 la industria ha seguido la idea de que basta con entrenar modelos cada vez más grandes sobre texto, imágenes y sonido para que terminen formando una representación común del mundo. Se creía que el tamaño lo resolvía todo, pero esa hipótesis nunca se había demostrado.
Randall Balestriero y Yann LeCun la pusieron a prueba. Los resultados muestran que el tamaño del modelo no es decisivo.
Lo que importa es qué datos recibe el modelo junto con otros.
Una fotografía y su descripción son dos formas de transmitir información sobre el mismo objeto. Los modelos entrenados con pares así alcanzan el objetivo mucho más rápido.
En cambio, dos párrafos de un mismo documento no son dos representaciones del mismo objeto. Los modelos entrenados con esos datos llegan a un resultado similar mucho más lentamente y requieren muchos más recursos de cálculo.
Precisamente a ese segundo tipo pertenece la predicción del siguiente token. Sobre ese principio funcionan prácticamente todos los chatbots modernos.
En los experimentos, el primer método alcanzó un nivel de comprensión comparable con solo 21,6 millones de ejemplos. Para entrenar con predicción del siguiente token hicieron falta 900 millones.
Además, un modelo de texto con 109 millones de parámetros formó una representación del mundo más cercana a la de un modelo entrenado con imágenes que la de un modelo lingüístico con 72.000 millones de parámetros.
660 veces menos parámetros.
Por qué es importante
AnálisisEsto cuestiona la creencia en el escalado y puede redirigir el desarrollo de IA hacia datos multimodales de mejor calidad y entrenamiento más eficiente.
Debatir en la comunidad
Comparte tus preguntas e ideas con desarrolladores
Relacionado en el ecosistema
Guías prácticas, terminología y skills de agentes
Mistral publica los pesos abiertos de Large 4, el modelo Le Chonk de 1 billón de parámetros
Mistral publicó los pesos abiertos de su modelo insignia Large 4, llamado internamente Le Chonk, y redujo los precios de la API.
Parte II. Arquitectura de agentes de IA: del modelo a la memoria y las herramientas
Inmersión profunda de ingeniería: tokenización, KV-cache, determinismo del muestreo, stack de entrenamiento, cuantización, ingeniería de contexto, stack de seguridad, RAG en producción, ReAct y sistemas swarm multiagente.
Modelos Frontera
La clase más poderosa de inteligencia artificial en la vanguardia de la investigación mundial (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define los límites de las capacidades modernas de razonamiento, autonomía y codificación.
LLM (Large Language Model - Modelo de Lenguaje Grande)
Clase fundamental de arquitecturas de redes neuronales basadas en transformadores autorregresivos, que predice la distribución probabilística de los siguientes tokens y demuestra propiedades emergentes de pensamiento abstracto, síntesis de código y razonamiento lógico.