LeCun estava certo: um modelo de 109 milhões de parâmetros superou um modelo de 72 bilhões
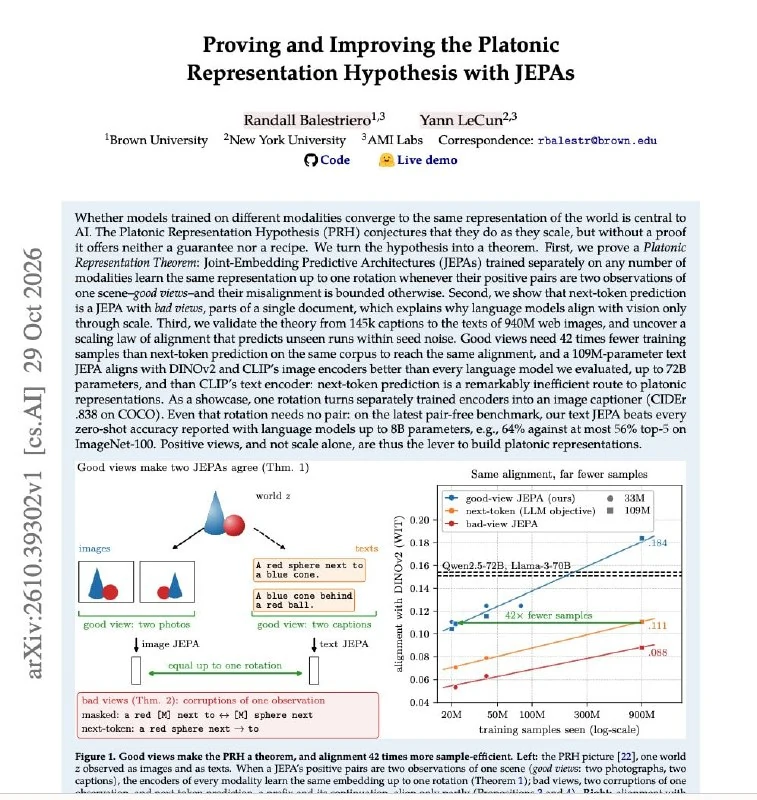
Um estudo de Randall Balestriero e Yann LeCun indica que a qualidade e o tipo dos dados importam mais do que o tamanho do modelo.
Yann LeCun estava certo, mas ninguém nesta indústria quer dizer isso em voz alta.
Um modelo com 109 milhões de parâmetros superou um modelo com 72 bilhões.
Há anos LeCun argumenta que o tamanho do modelo, por si só, não o leva a compreender o mundo. A Meta apostou na abordagem oposta. Em novembro, ele deixou a empresa e fundou seu próprio laboratório em Paris.
Recentemente, ele publicou provas de sua teoria.
Desde 2024, a indústria seguiu a ideia de que basta treinar modelos cada vez maiores sobre texto, imagens e áudio para que eles acabem formando uma representação comum do mundo. Acreditava-se que o tamanho resolvia tudo, mas essa hipótese nunca foi comprovada.
Randall Balestriero e Yann LeCun testaram essa hipótese. Os resultados mostram que o tamanho do modelo não é decisivo.
O que importa é quais dados o modelo recebe juntos.
Uma fotografia e sua descrição são duas formas diferentes de transmitir informações sobre o mesmo objeto. Modelos treinados em pares assim alcançam o resultado desejado muito mais rápido.
Já dois parágrafos de um mesmo documento não são duas representações do mesmo objeto. Modelos treinados nesse tipo de dados alcançam um resultado semelhante muito mais devagar e exigem muito mais recursos computacionais.
É justamente a esse segundo tipo que pertence a previsão do próximo token. Praticamente todos os chatbots modernos funcionam com esse princípio.
Nos experimentos, o primeiro método atingiu um nível de compreensão comparável com apenas 21,6 milhões de exemplos. Para treinar com previsão do próximo token, foram necessários 900 milhões.
Além disso, um modelo de texto com 109 milhões de parâmetros formou uma representação do mundo mais próxima da de um modelo treinado em imagens do que a de um modelo de linguagem com 72 bilhões de parâmetros.
660 vezes menos parâmetros.
Por que isso importa
AnáliseIsso desafia o dogma do escalamento e pode redirecionar o desenvolvimento de IA para dados multimodais melhores e treinamento mais eficiente.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores
Relacionado no ecossistema
Guias práticos, terminologia essencial e skills de agentes
Mistral lança pesos abertos de Large 4, o modelo Le Chonk com 1 trilhão de parâmetros
A Mistral lançou os pesos abertos do modelo principal Large 4, chamado internamente de Le Chonk, e reduziu os preços da API.
Parte II. Arquitetura de Agentes de IA: do Modelo à Memória e Ferramentas
Imersão profunda em engenharia: tokenização, cache KV, determinismo de amostragem, stack de treinamento, quantização, engenharia de contexto, stack de segurança, RAG em produção, ReAct e sistemas swarm multiagente.
Modelos de Fronteira
A classe mais poderosa de inteligência artificial na vanguarda da pesquisa global (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), que define os limites atuais das capacidades de raciocínio, autonomia e codificação.
LLM (Large Language Model - Modelo de Linguagem Grande)
Classe fundamental de arquiteturas de redes neurais baseada em transformadores autorregressivos, que prevê a distribuição probabilística dos próximos tokens e demonstra propriedades emergentes de pensamento abstrato, síntese de código e raciocínio lógico.