LeCun hatte recht: Ein 109-Millionen-Parameter-Modell übertraf ein 72-Milliarden-Modell
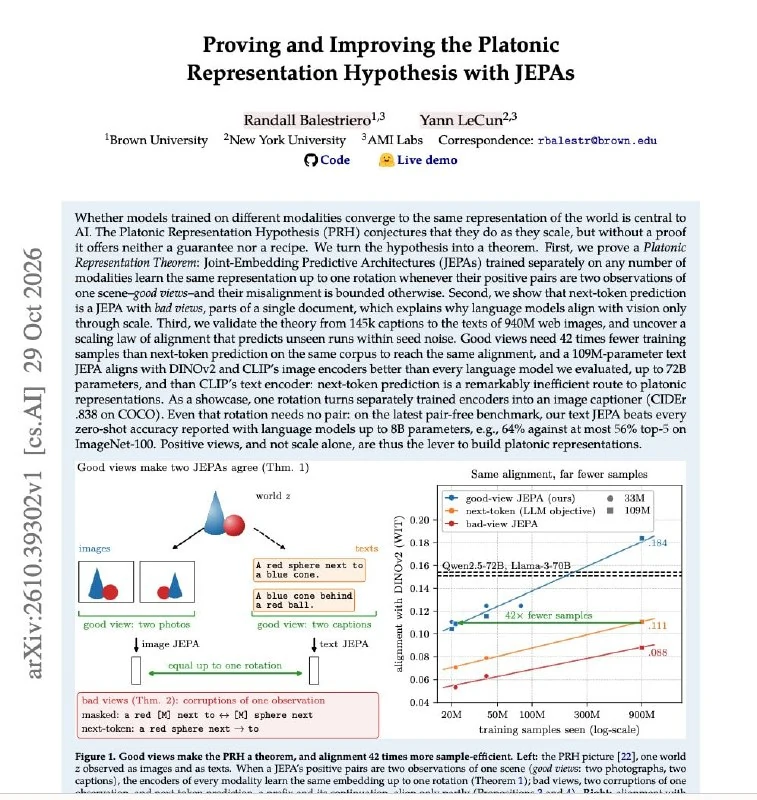
Eine Studie von Randall Balestriero und Yann LeCun zeigt, dass Art und Kombination der Trainingsdaten wichtiger sind als schiere Modellgröße.
Yann LeCun hatte recht, aber in dieser Branche will niemand das offen aussprechen.
Ein Modell mit 109 Millionen Parametern übertraf ein Modell mit 72 Milliarden Parametern.
Seit Jahren argumentiert LeCun, dass die Größe eines Modells allein es nicht dazu bringt, die Welt zu verstehen. Meta setzte auf den gegenteiligen Ansatz. Im November verließ er das Unternehmen und gründete ein eigenes Labor in Paris.
Vor Kurzem veröffentlichte er Belege für seine Theorie.
Seit 2024 folgt die Branche der Idee, dass es ausreiche, immer größere Modelle auf Text, Bildern und Audio zu trainieren, damit sie am Ende eine gemeinsame innere Repräsentation der Welt bilden. Man glaubte, dass Größe alles entscheide. Bewiesen wurde diese Hypothese jedoch nie.
Randall Balestriero und Yann LeCun haben sie überprüft. Die Ergebnisse zeigen, dass es nicht um die Modellgröße geht.
Entscheidend ist, welche Daten ein Modell gemeinsam erhält.
Ein Foto und seine Beschreibung sind zwei verschiedene Wege, Information über dasselbe Objekt zu übertragen. Modelle, die auf solchen Paaren trainiert werden, erreichen das gewünschte Ergebnis deutlich schneller.
Zwei Absätze aus einem Dokument sind dagegen keine zwei Darstellungen desselben Objekts. Modelle, die auf solchen Daten trainiert werden, erreichen ein vergleichbares Ergebnis viel langsamer und benötigen erheblich mehr Rechenressourcen.
Genau zu diesem zweiten Typ gehört die Vorhersage des nächsten Tokens. Nach diesem Prinzip arbeiten praktisch alle modernen Chatbots.
In den Experimenten erreichte die erste Methode ein vergleichbares Verständnisniveau mit nur 21,6 Millionen Beispielen. Für das Training mit Vorhersage des nächsten Tokens waren 900 Millionen nötig.
Darüber hinaus bildete ein Textmodell mit 109 Millionen Parametern eine Weltrepräsentation, die näher an der eines auf Bildern trainierten Modells lag als bei einem Sprachmodell mit 72 Milliarden Parametern.
660-mal weniger Parameter.
Warum das wichtig ist
AnalyseDas Ergebnis stellt die Skalierungsdogma infrage und könnte KI-Entwicklung in Richtung besserer multimodaler Daten und effizienteren Trainings lenken.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern
Verwandt im Ökosystem
Praktische Leitfäden, Terminologie und Agenten-Skills
Mistral veröffentlicht offene Gewichte für Large 4, das Le-Chonk-Modell mit 1.000 Milliarden Parametern
Mistral hat die offenen Gewichte seines Flaggschiff-Modells Large 4 veröffentlicht, intern Le Chonk genannt, und die API-Preise gesenkt.
Teil II. Architektur von KI-Agenten: Vom Modell zu Gedächtnis und Tools
Tiefes technisches Eintauchen: Tokenisierung, KV-Cache, Determinismus beim Sampling, Trainings-Stack, Quantisierung, Kontext-Engineering, Security-Stack, produktives RAG, ReAct sowie Multi-Agenten-Swarm-Systeme.
Frontier-Modelle
Die leistungsstärkste Klasse künstlicher Intelligenz an der Spitze der globalen Forschung (Claude 3.7 Sonnet, OpenAI o3/GPT-4.5, Gemini 2.0 Pro), die die Grenzen moderner Fähigkeiten in Bezug auf Reasoning, Autonomie und Coding definiert.
LLM (Large Language Model – Großes Sprachmodell)
Eine fundamentale Klasse neuronaler Netzwerkarchitekturen auf Basis autoregressiver Transformer, die Wahrscheinlichkeitsverteilungen für nachfolgende Tokens vorhersagt und emergente Fähigkeiten im abstrakten Denken, in der Code-Synthese sowie im logischen Schlussfolgern zeigt.