Ян ЛеКун оказался прав: модель со 109 млн параметров превзошла модель с 72 млрд
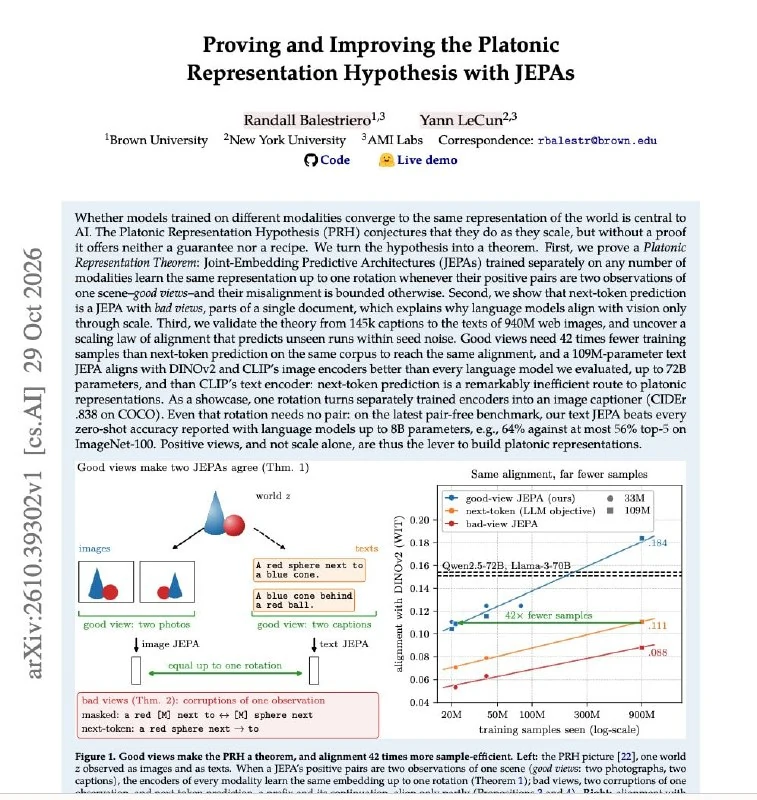
Исследование Рэндолла Балестриеро и Яна Лекуна показало, что тип и сочетание данных важнее размера модели.
Ян ЛеКун оказался прав, но в этой индустрии никто не хочет говорить об этом вслух.
Модель со 109 млн параметров превзошла модель с 72 млрд.
Уже несколько лет ЛеКун утверждает, что масштаб модели сам по себе не заставляет её понимать окружающий мир. Meta сделала ставку на противоположный подход. В ноябре он покинул компанию и основал собственную лабораторию в Париже.
Недавно он опубликовал доказательства своей теории.
С 2024 года индустрия придерживается идеи, согласно которой достаточно обучать всё более крупные модели на текстах, изображениях и звуках, чтобы в итоге они сформировали одинаковое внутреннее представление об окружающем мире. Считалось, что всё решает масштаб. Но эту гипотезу никто так и не доказал.
Рэндолл Балестриеро и Ян ЛеКун проверили её. И результаты показали, что дело вовсе не в размере модели.
Решающую роль играет то, какие именно данные модель получает вместе друг с другом.
Фотография и её описание представляют собой два разных способа передачи информации об одном объекте. Модели, обученные на таких парах, достигают нужного результата значительно быстрее.
А вот два абзаца из одного документа не являются двумя представлениями одного и того же объекта. Модели, обученные на таких данных, достигают аналогичного результата гораздо медленнее и требуют значительно больше вычислительных ресурсов.
Именно ко второму типу относится предсказание следующего токена. На этом принципе работают практически все современные чат-боты.
В ходе экспериментов первый метод позволил достичь аналогичного уровня понимания всего на 21,6 млн примеров. Для обучения с предсказанием следующего токена потребовалось 900 млн.
Более того, текстовая модель со 109 млн параметров сформировала представление об окружающем мире, которое оказалось ближе к представлению модели, обученной на изображениях, чем у языковой модели с 72 млрд параметров.
В 660 раз меньше параметров.
Почему это важно
АналитикаЭто ставит под сомнение веру в масштаб и может сместить развитие ИИ к более качественным мультимодальным данным и эффективному обучению.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Mistral выпустила открытые веса Large 4: модель Le Chonk с 1 трлн параметров
Mistral открыла веса флагманской модели Large 4, которую внутри компании называют Le Chonk, и снизила цены на API.
LLM (Large Language Model - Большая языковая модель)
Фундаментальный класс нейросетевых архитектур на основе авторегрессионного трансформера, который предполагает вероятностное распределение следующих токенов и демонстрирует эмергентные свойства абстрактного мышления, синтеза кода и логического вывода.
OpenAI втайне тестирует GPT-6.2 Astra: новую модель заметили в статистике Codex
У части пользователей в статистике использования Codex появился отдельный идентификатор gpt-6.2-astra, тогда как в списке доступных моделей по-прежнему значится GPT-6 Astra.
Часть I. Архитектура ИИ-агентов: фундаментальные блоки
Одиннадцать фундаментальных строительных блоков современного ИИ-агента: таксономия моделей, агентный рантайм, техники промптинга, дистилляция, архитектура навыков (skills), память, function calling и FinOps.