Badacze z Meta proponują pełną autonomię LLM w zarządzaniu własnym kontekstem
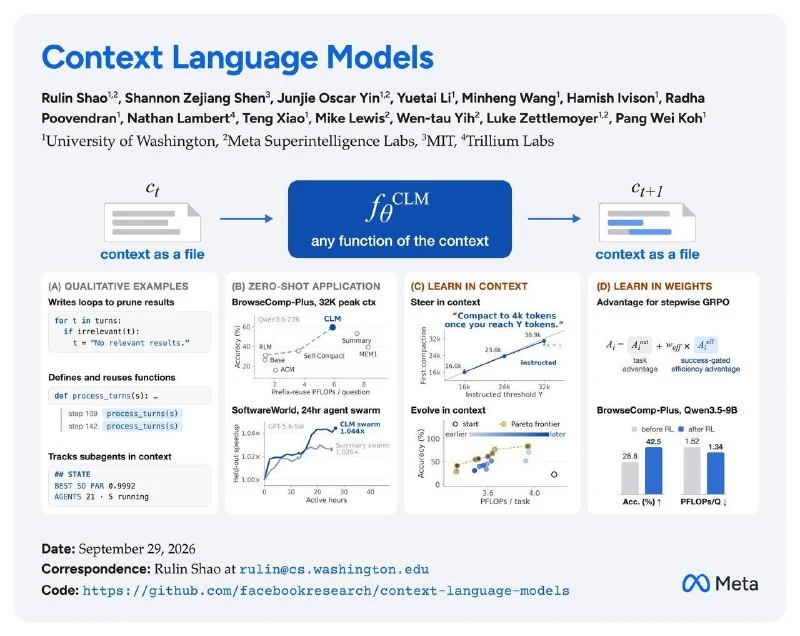
Model językowy Context Language Models (CLM) eliminuje sztywne reguły zarządzania historią, pozwalając AI samodzielnie edytować swój kontekst, co znacząco obniża koszty obliczeniowe przy długich zadaniach.
Badacze z Meta zaproponowali podejście Context Language Models (CLM), które nadaje modelom pełną kontrolę nad ich własnym kontekstem.
Zazwyczaj kontekst agenta jest zarządzany według prostej zasady: stary kontekst + nowa odpowiedź -> nowy kontekst. W miarę wzrostu historii musi ona być ostatecznie kompresowana lub czyszczona w oddzielnym procesie.
W CLM autorzy proponują całkowite usunięcie predefiniowanej logiki zarządzania kontekstem i pozwolenie modelowi na przepisywanie własnej historii.
Technicznie rzecz biorąc, bieżący kontekst jest przechowywany w zwykłym pliku dostępnym dla modelu przez Bash. Model może w dowolnym momencie usuwać zbędne wiadomości, zastępować duże fragmenty historii krótką notatką, zachowywać ważne wyniki dosłownie lub całkowicie restrukturyzować treść. Po każdej zmianie plik staje się nowym kontekstem modelu.
Model nie otrzymuje żadnych jawnych zasad dotyczących zarządzania historią. W eksperymentach agenci zaczęli dodawać notatki wewnątrz kontekstu, pisać funkcje do usuwania starych wyników wyszukiwania oraz tworzyć kompaktowe tabele ze stanami innych agentów. Na przykład w jednym z testów model utrzymywał działający kontekst w granicach 6–8K tokenów podczas 163 edycji.
Autorzy posunęli się dalej, próbując wytrenować model pod kątem tej umiejętności za pomocą uczenia ze wzmocnieniem (RL). Po wytrenowaniu Qwen3.5-9B na zbiorze BrowseComp-Plus wydajność wzrosła z 28,8% do 42,5%, a zużycie mocy obliczeniowej było niższe o 38,8% w porównaniu z modelem bazowym trenowanym w ten sam sposób z zastosowaniem standardowego streszczania.
Jednakże arbitralna edycja kontekstu łamie standardowe mechanizmy buforowania. Jeśli coś zmieni się w środku historii, wszystkie stany po tym punkcie formalnie muszą zostać przeliczone od nowa. Autorzy wprowadzili rozwiązanie Suffix Cache Reuse: dla niezmienionych części kontekstu nadal korzystają ze starego cache KV, nawet jeśli tekst przed nimi uległ zmianie. W eksperymentach zmniejszyło to obciążenie serwera o kolejne ~35% bez zauważalnej utraty jakości.
Przy długotrwałych zadaniach różnica staje się istotna. W 12-godzinnym teście EdgeBench CLM uzyskał wynik o 5% wyższy, jednocześnie redukując zużycie mocy obliczeniowej o 59%. W 24-godzinnym teście optymalizacji kodu CLM osiągnął wynik o 65% lepszy niż baseline przy tym samym budżecie obliczeniowym.
Całe to rozwiązanie działa na bazie zwykłych modeli LLM, bez zmiany samej architektury modelu.
Dlaczego to ważne
AnalizaTo podejście ma kluczowe znaczenie, ponieważ autonomiczne zarządzanie kontekstem pozwala obniżyć koszty wnioskowania i zwiększa niezależność agentów AI podczas realizacji złożonych, wieloetapowych zadań.
Dyskutuj w społeczności
Dziel się swoimi pytaniami i spostrzeżeniami z programistami