Meta propose de confier aux LLM le contrôle total de leur propre contexte
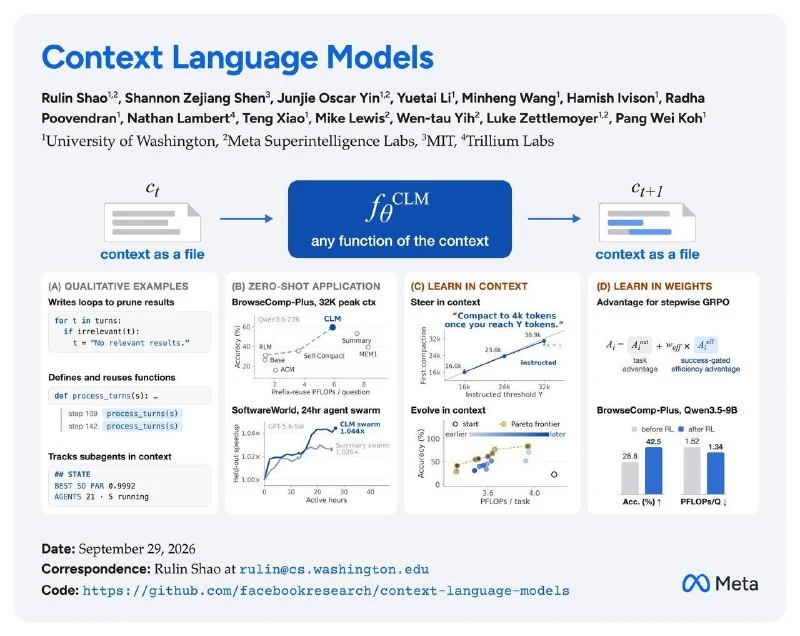
Les modèles de langage contextuels (CLM) suppriment la logique préétablie de gestion du contexte, permettant aux IA de réécrire leur propre historique via Bash pour réduire les coûts de calcul sur les tâches longues.
Des chercheurs de Meta ont proposé les Context Language Models (CLM), une approche qui confère aux modèles un contrôle total sur leur propre contexte.
Habituellement, le contexte d'un agent est géré selon une règle simple : ancien contexte + nouvelle réponse -> nouveau contexte. À mesure que l'historique s'allonge, il doit finalement être compressé ou nettoyé séparément.
Dans l'approche CLM, les auteurs proposent de supprimer entièrement la logique préétablie de gestion du contexte et d'autoriser le modèle à réécrire son propre historique.
Techniquement, le contexte actuel est stocké dans un fichier standard accessible au modèle via Bash. Le modèle peut supprimer des messages inutiles à tout moment, remplacer une grande partie de l'historique par une note courte, conserver verbatim un résultat important ou restructurer complètement le contenu. Après chaque modification, le fichier devient le nouveau contexte du modèle.
Le modèle ne reçoit aucune règle explicite sur la manière de gérer l'historique. Lors des expériences, les agents ont commencé à ajouter des notes dans le contexte, à écrire des fonctions pour supprimer d'anciens résultats de recherche et à construire des tableaux compacts contenant les états d'autres agents. Par exemple, lors d'un test, un modèle a maintenu un contexte fonctionnel entre 6 et 8K tokens sur 163 modifications.
Les auteurs sont allés plus loin en tentant d'entraîner le modèle à cette compétence grâce à l'apprentissage par renforcement (RL). Après l'entraînement de Qwen3.5-9B sur BrowseComp-Plus, la performance est passée de 28,8 % à 42,5 %, tandis que le calcul était inférieur de 38,8 % par rapport à une base de référence entraînée de la même manière avec une résumé classique.
Cependant, l'édition arbitraire du contexte brise la mise en cache standard. Si quelque chose change au milieu de l'historique, tous les états postérieurs doivent formellement être recalculés. Les auteurs ont introduit le Suffix Cache Reuse : pour les parties inchangées du contexte, ils continuent d'utiliser l'ancien KV-cache même si le texte précédent a été modifié. Dans les expériences, cela a réduit le calcul côté serveur d'environ 35 % supplémentaires sans perte notable de qualité.
Sur les tâches longues, la différence devient substantielle. Lors d'une exécution de 12 heures sur EdgeBench, CLM a obtenu un score supérieur de 5 % tout en réduisant le calcul de 59 %. Dans un test d'optimisation de code de 24 heures, CLM a atteint un résultat 65 % meilleur que la base de référence sous le même budget de calcul.
Tout cela fonctionne sur des LLM ordinaires, sans modifier l'architecture du modèle elle-même.
Pourquoi c'est important
AnalyseCette avancée est cruciale car la gestion autonome du contexte permet de réduire les coûts d'inférence et d'accroître l'autonomie des agents IA sur les tâches complexes et multi-étapes.
Discuter dans la communauté
Partagez vos questions et vos idées avec les développeurs