Meta-Forscher schlagen vor, LLMs die volle Kontrolle über ihren eigenen Kontext zu geben
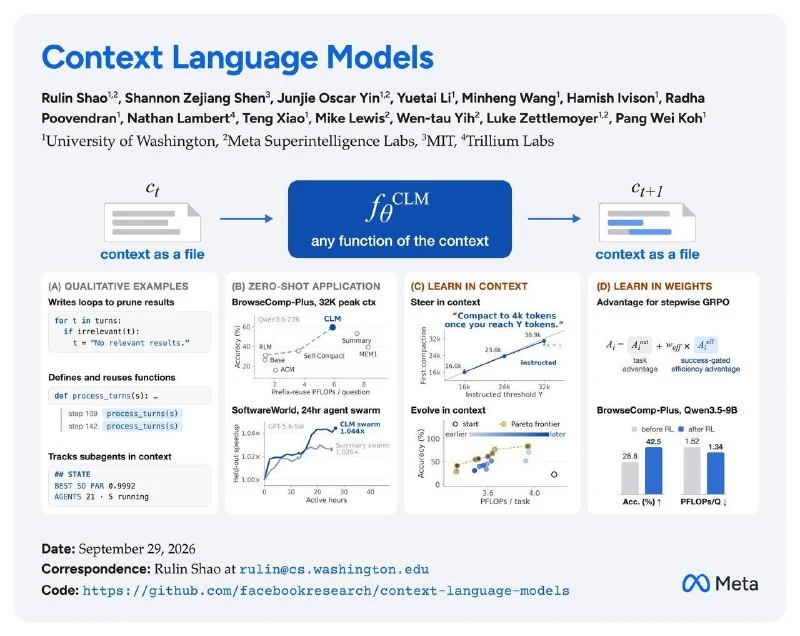
Context Language Models (CLM) eliminieren vordefinierte Logiken zur Kontextverwaltung und ermöglichen es Modellen, ihre eigene Historie in einer über Bash zugänglichen Datei umzuschreiben, was die Rechenkosten bei langlaufenden Aufgaben senkt.
Forscher von Meta haben Context Language Models (CLM) vorgeschlagen, einen Ansatz, der Sprachmodellen die vollständige Kontrolle über ihren eigenen Kontext gibt.
Normalerweise wird der Kontext eines Agenten nach einer einfachen Regel verwaltet: alter Kontext + neue Antwort -> neuer Kontext. Wenn die Historie wächst, muss sie irgendwann separat komprimiert oder bereinigt werden.
Bei CLM schlagen die Autoren vor, die vordefinierte Logik zur Kontextverwaltung vollständig zu entfernen und dem Modell zu erlauben, seine eigene Historie umzuschreiben.
Technisch gesehen wird der aktuelle Kontext in einer regulären Datei gespeichert, auf die das Modell über Bash zugreifen kann. Das Modell kann unnötige Nachrichten jederzeit löschen, einen großen Teil der Historie durch eine kurze Notiz ersetzen, ein wichtiges Ergebnis wörtlich beibehalten oder den Inhalt komplett neu strukturieren. Nach jeder Änderung wird die Datei zum neuen Kontext des Modells.
Das Modell erhält keine expliziten Regeln darüber, wie es die Historie verwalten soll. In Experimenten begannen Agenten, Notizen innerhalb des Kontexts hinzuzufügen, Funktionen zum Löschen alter Suchergebnisse zu schreiben und kompakte Tabellen mit den Zuständen anderer Agenten zu erstellen. Beispielsweise hielt ein Modell in einem Test seinen Arbeitskontext über 163 Bearbeitungen hinweg innerhalb von 6–8K Tokens.
Die Autoren gingen noch weiter und versuchten, das Modell für diese Fähigkeit mittels Reinforcement Learning (RL) zu trainieren. Nach dem Training von Qwen3.5-9B auf BrowseComp-Plus stieg die Leistung von 28,8 % auf 42,5 %, während der Rechenaufwand im Vergleich zu einem Baseline-Modell, das auf die gleiche Weise mit herkömmlicher Zusammenfassung trainiert wurde, um 38,8 % geringer war.
Willkürliche Kontextbearbeitung bricht jedoch Standard-Caching-Mechanismen. Wenn sich etwas in der Mitte der Historie ändert, müssen alle Zustände danach formal neu berechnet werden. Die Autoren führten Suffix Cache Reuse ein: Für unveränderte Teile des Kontexts verwenden sie weiterhin den alten KV-Cache, auch wenn sich der Text davor geändert hat. In Experimenten reduzierte dies die serverseitige Berechnung um weitere ~35 % ohne spürbaren Qualitätsverlust.
Bei langlaufenden Aufgaben wird der Unterschied erheblich. Bei einer 12-stündigen EdgeBench-Ausführung erzielte CLM eine um 5 % höhere Punktzahl, während der Rechenaufwand um 59 % gesenkt wurde. In einem 24-stündigen Code-Optimierungstest erreichte CLM ein um 65 % besseres Ergebnis als die Baseline unter demselben Rechenbudget.
All dies funktioniert auf Basis gewöhnlicher LLMs, ohne dass die Modellarchitektur selbst geändert werden muss.
Warum das wichtig ist
AnalyseDies ist relevant, da selbstverwalteter Kontext die Inferenzkosten senken und KI-Agenten bei langen, mehrstufigen Aufgaben autonomer machen kann.
In der Community diskutieren
Teile deine Fragen und Erkenntnisse mit Entwicklern