Pesquisadores da Meta Propõem Dar aos LLMs Controle Total Sobre Seu Próprio Contexto
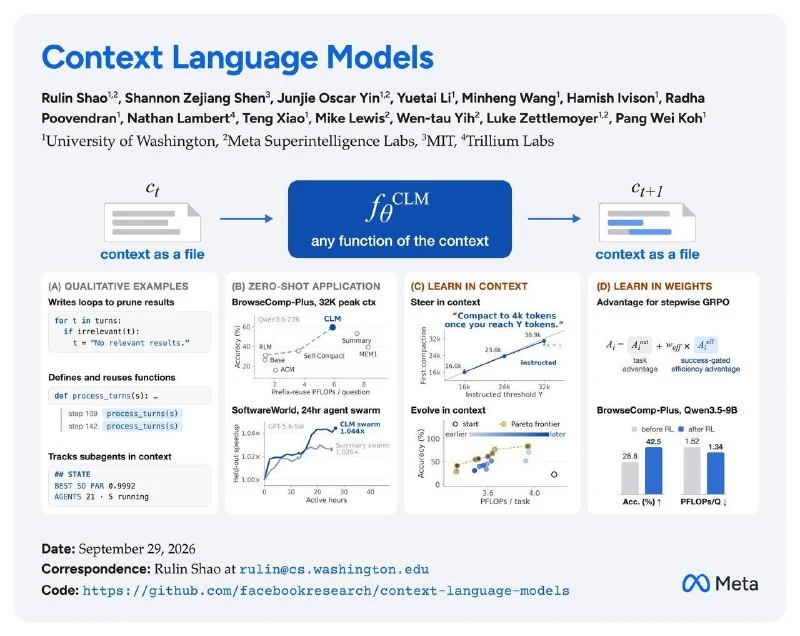
Os Modelos de Linguagem de Contexto (CLM) eliminam a lógica pré-definida de gerenciamento de contexto, permitindo que os modelos reescrevam seu próprio histórico em um arquivo acessível via Bash, reduzindo significativamente os custos computacionais em tarefas longas.
Pesquisadores da Meta propuseram os Context Language Models (CLM), uma abordagem que concede aos modelos controle total sobre seu próprio contexto.
Normalmente, o contexto de um agente é gerenciado por uma regra simples: contexto antigo + nova resposta -> novo contexto. À medida que o histórico cresce, ele eventualmente precisa ser comprimido ou limpo separadamente.
No CLM, os autores propõem remover completamente a lógica predefinida de gerenciamento de contexto e permitir que o modelo reescreva seu próprio histórico.
Tecnicamente, o contexto atual é armazenado em um arquivo regular acessível ao modelo através do Bash. O modelo pode excluir mensagens desnecessárias a qualquer momento, substituir grandes trechos do histórico por notas curtas, preservar resultados importantes verbatim ou reestruturar completamente o conteúdo. Após cada alteração, o arquivo torna-se o novo contexto do modelo.
O modelo não recebe regras explícitas sobre como gerenciar o histórico. Em experimentos, os agentes começaram a adicionar notas dentro do contexto, escrever funções para excluir antigos resultados de busca e construir tabelas compactas com os estados de outros agentes. Por exemplo, em um teste, um modelo manteve um contexto funcional entre 6–8K tokens ao longo de 163 edições.
Os autores foram além e tentaram treinar o modelo para essa habilidade usando aprendizado por reforço (RL). Após treinar o Qwen3.5-9B no BrowseComp-Plus, o desempenho aumentou de 28,8% para 42,5%, enquanto o custo computacional foi 38,8% menor do que uma linha base treinada da mesma forma com resumo comum.
A edição arbitrária do contexto, no entanto, quebra o cache padrão. Se algo no meio do histórico mudar, todos os estados após esse ponto precisam formalmente ser recalculados. Os autores introduziram o Suffix Cache Reuse: para partes inalteradas do contexto, eles continuam a usar o antigo KV-cache mesmo se o texto anterior tiver mudado. Em experimentos, isso reduziu o cálculo no lado do servidor em mais ~35% sem perda perceptível de qualidade.
Em tarefas longas, a diferença torna-se substancial. Em uma execução de 12 horas no EdgeBench, o CLM obteve pontuação 5% maior, reduzindo o uso de computação em 59%. Em um teste de otimização de código de 24 horas, o CLM alcançou um resultado 65% melhor do que a linha base sob o mesmo orçamento de computação.
Tudo isso funciona sobre LLMs comuns, sem alterar a arquitetura do modelo em si.
Por que isso importa
AnáliseIsso é relevante porque o gerenciamento autônomo de contexto pode reduzir os custos de inferência e tornar os agentes de IA mais autônomos em tarefas longas e multi-etapas.
Debater na comunidade
Compartilhe suas dúvidas e insights com desenvolvedores