Исследователи из Meta предложили дать моделям полный контроль над собственным контекстом
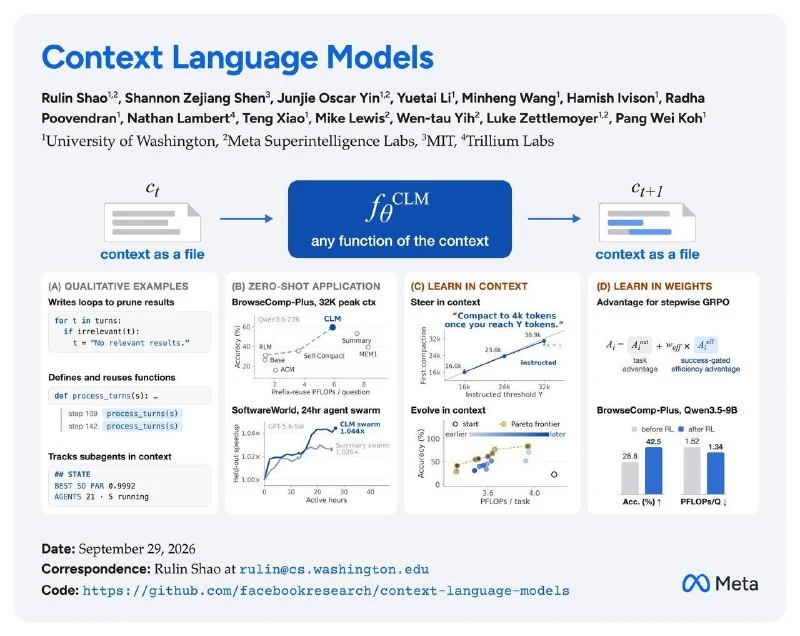
Context Language Models (CLM) убирают заранее заданную логику управления контекстом и позволяют модели самостоятельно переписывать историю в файле, доступном через Bash, что снижает вычислительные затраты в долгих задачах.
Исследователи из Meta предложили дать моделям полный контроль над собственным контекстом.
Обычно контекст агента устроен довольно просто: старый контекст + новый ответ -> новый контекст. История постепенно растет, а когда становится слишком большой, ее приходится отдельно сжимать или чистить.
В Context Language Models (CLM) авторы предлагают вообще убрать заранее заданную логику управления контекстом и дать модели возможность самой переписывать собственную историю.
Технически весь текущий контекст хранится в обычном файле, к которому у модели есть доступ через Bash. Она может в любой момент удалить ненужные сообщения, заменить большой кусок истории короткой заметкой, сохранить важный результат дословно или полностью перестроить содержимое. После каждого изменения файл становится новым контекстом модели.
При этом никаких правил о том, как именно управлять историей, модели не дают. В экспериментах агенты сами начинали заводить внутри контекста пометки, писать функции для удаления старых результатов поиска и собирать компактные таблицы с состоянием других агентов. Например, в одном из тестов модель за 163 редактирования удерживала рабочий контекст в пределах 6–8K токенов.
Авторы пошли дальше и попробовали отдельно обучить модель этому навыку через RL. После обучения Qwen3.5-9B на BrowseComp-Plus результат вырос с 28.8% до 42.5%, при этом на вычисления ушло на 38.8% меньше, чем у обученного тем же способом бейзлайна с обычной суммаризацией.
Произвольное редактирование контекста, правда, ломает обычное кеширование. Если изменить что-то в середине истории, все состояния после этого места формально приходится считать заново. Для этого авторы сделали Suffix Cache Reuse: для неизменившихся частей контекста продолжают использовать старый KV-cache, даже если текст перед ними поменялся. В экспериментах это сократило серверные вычисления еще примерно на 35% без заметной потери качества.
На длинных задачах разница становится уже довольно большой. На 12-часовом EdgeBench CLM получил на 5% больше баллов при сокращении объема вычислений на 59%. В 24-часовом тесте на оптимизацию кода CLM при том же вычислительном бюджете показал на 65% лучший результат, чем бейзлайн.
И все это работает поверх обычных LLM, без изменения архитектуры самой модели.
Почему это важно
АналитикаЭто важно, потому что самоконтроль контекста ИИ-агентов может снизить стоимость инференса и повысить автономность в многошаговых задачах.
Обсудить в сообществе
Делитесь опытом и мыслями с ИИ-разработчиками
Связанные материалы экосистемы
Практические гайды, терминология и агентские скиллы
Семейство Llama (Meta Llama)
Серия фундаментальных открытых языковых моделей от Meta (Llama 3, 3.1, 3.3), ставшая промышленным стандартом экосистемы Open Weights, локального ИИ и корпоративного fine-tuning.
Meta Llama (Главный открытый стандарт искусственного интеллекта)
Флагманская серия открытых языковых моделей от компании Meta (Llama 3, 3.3). Доступна для свободного скачивания, модификации и локального запуска на собственных серверах без ограничений и цензуры.
Jev и System One AI: полное практическое руководство по модели решений от TypeSafe
Глубокий инженерный разбор флагманской модели Jev: архитектура System One против LLM, примитивы Choice/Score/Noul, параллелизм запросов, математика уверенности, видео-кейсы, код и обзор локальных open-weight альтернатив (Laya, GLiNER2.5, CLM-8B).
DeepSeek открыла исходный код части интерфейса чата
DeepSeek опубликовала исходный код фрагмента интерфейса своего чата с поддержкой поиска, глубокого мышления и истории переписки.